

知识库
上传运维手册和 SOP,故障调查、告警收敛、结果解读、触发器生成和平台体检解读时自动检索引用。需要配置向量模型。所有版本可用。
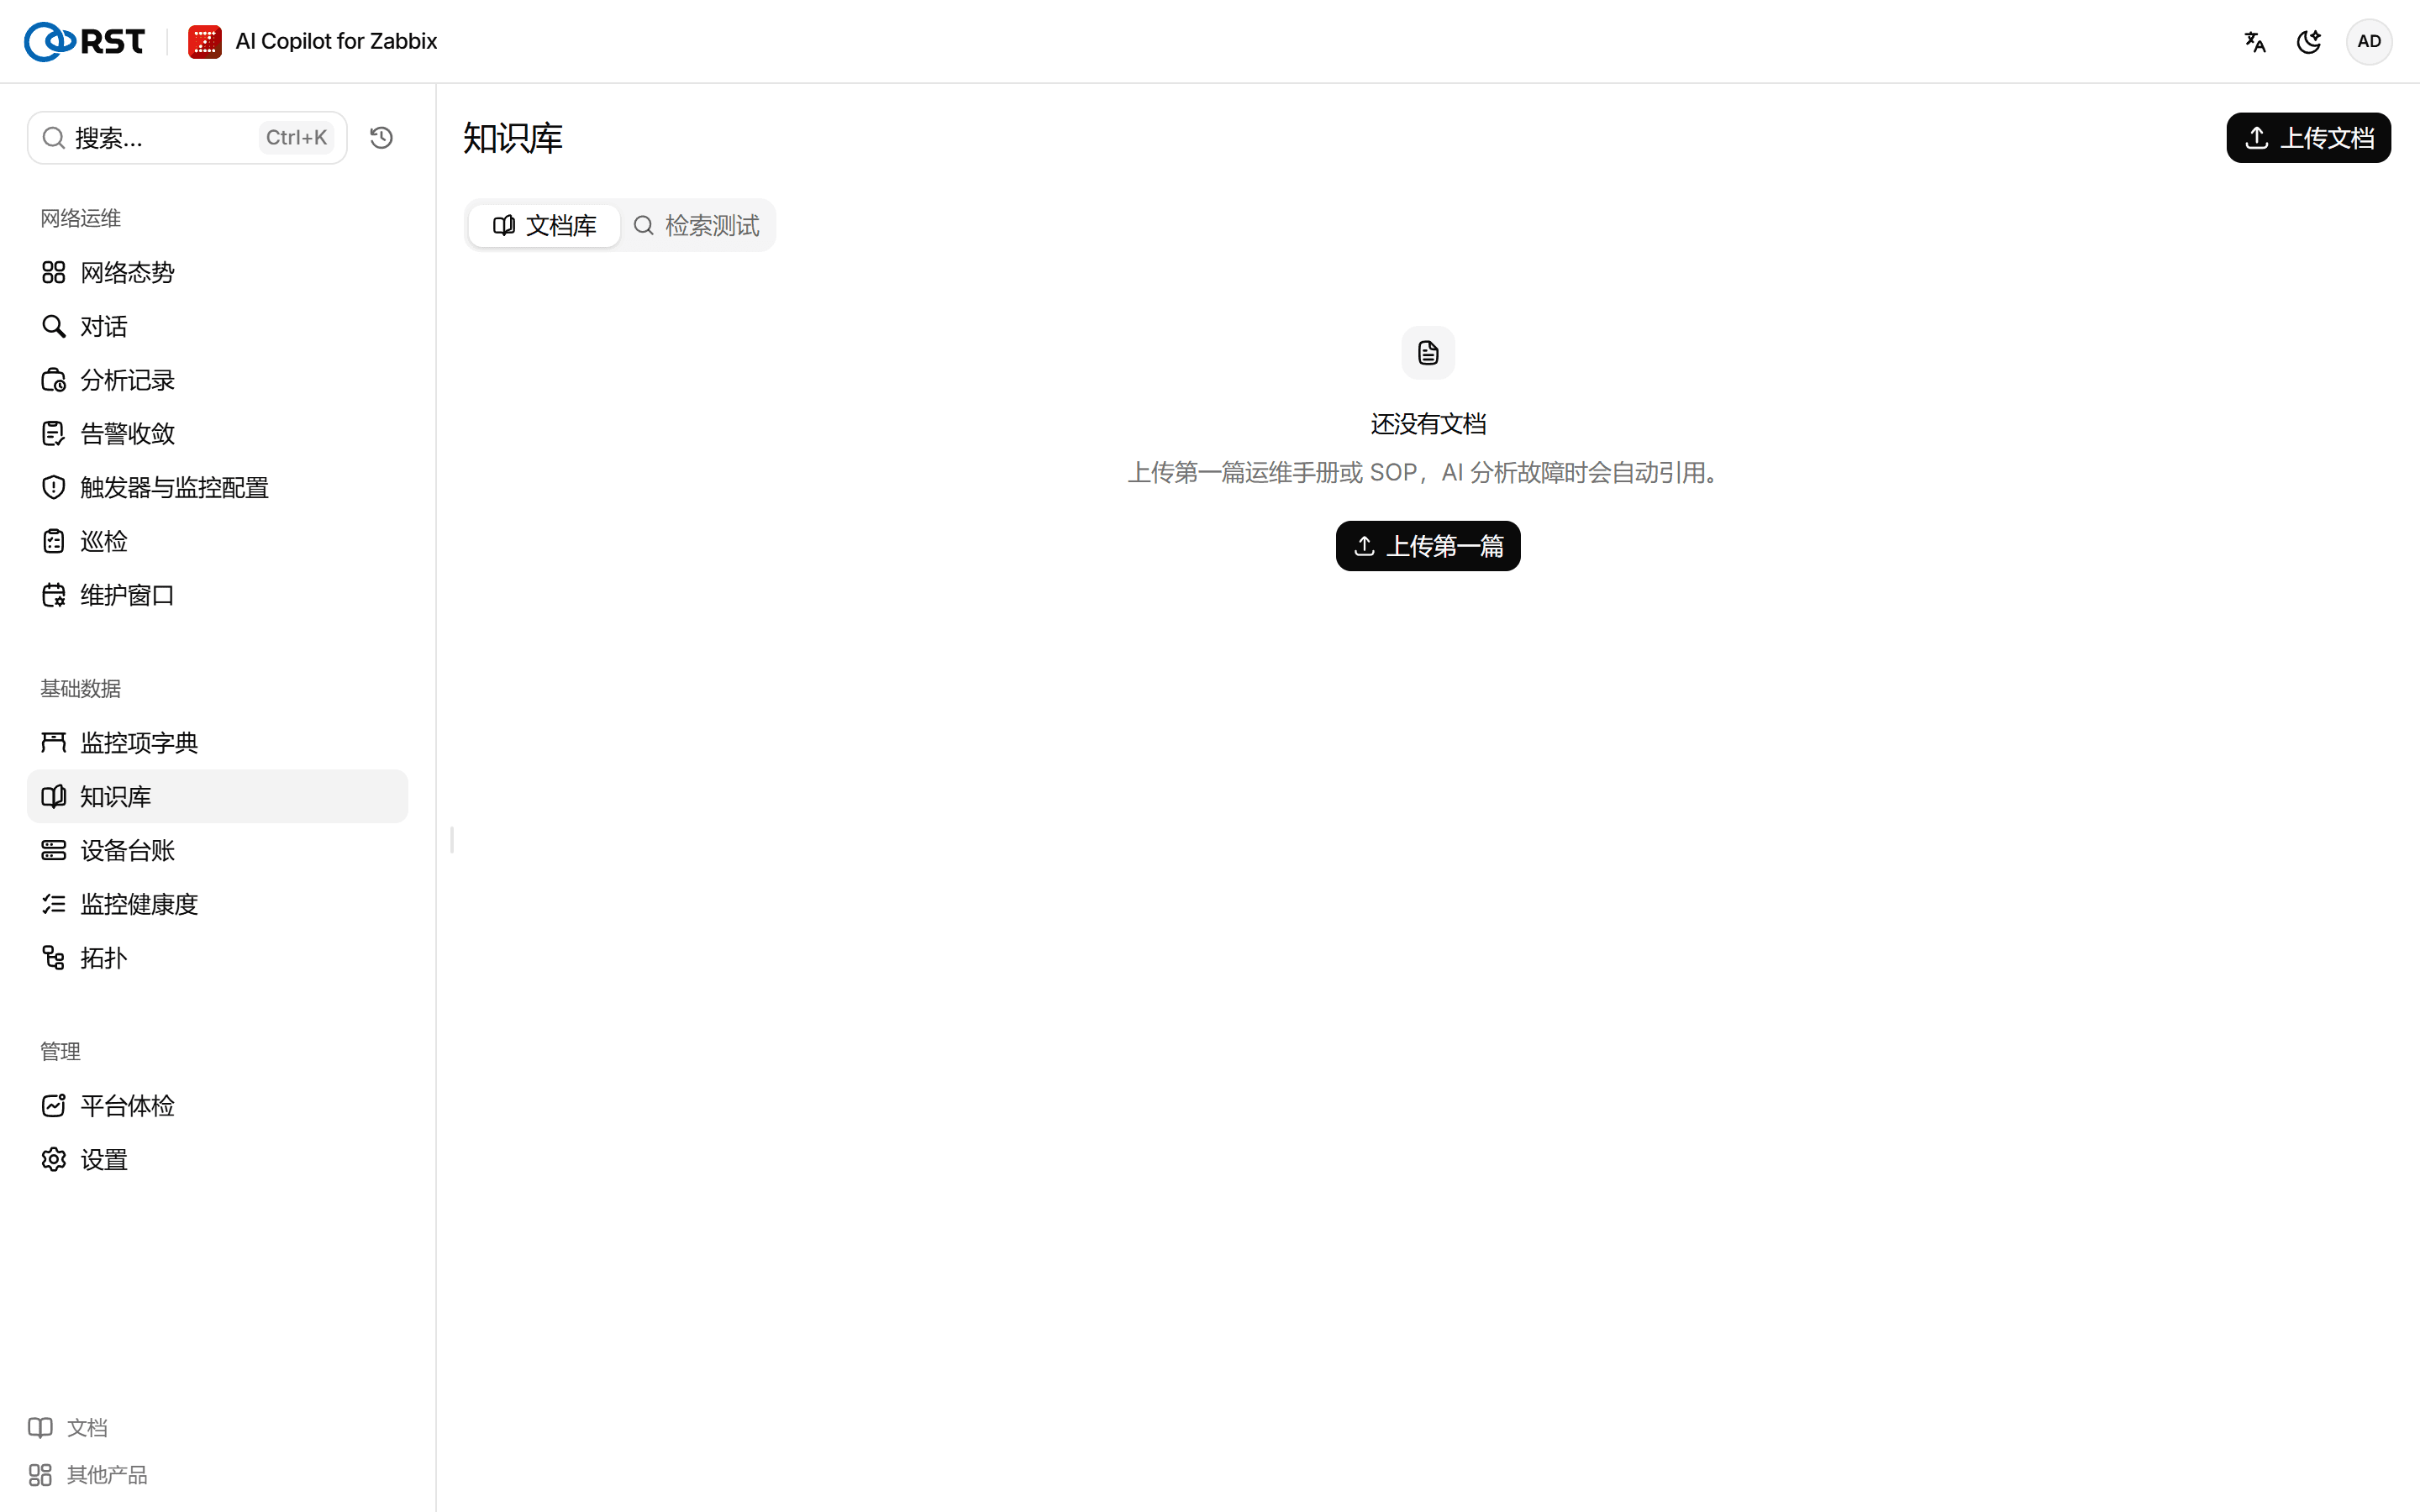
知识库保存团队自己的运维手册、SOP 和处置经验,位于侧栏 基础数据 组。模型分析故障时先在知识库中检索,把相关片段附在提示词中。知识库保存在网关的 state/kb_store.json(RST_KB_STORE),需要纳入备份。
启用知识库
知识库需要一个向量模型(Embedding)。没有配置时,页面提示 知识库未启用,AI 功能照常运行,只是不做检索。
前提条件
- 管理员角色。
步骤
- 打开 设置 中的 AI 配置,找到 知识库向量模型(Embedding)。
- 输入 模型 ID。端点和 key 留空时复用聊天模型的端点和 key。
- 选择 测试连接,向量维度 自动回填。
- 打开 启用,保存。
更换为维度不同的向量模型时,已有知识库的索引维度不匹配,保存会被拒绝,需要先重建知识库索引。
上传文档
前提条件
- 管理员角色。
- 已启用知识库。
步骤
- 在 文档库 标签中选择 上传文档。
- 输入 标题,在 正文 中粘贴 Markdown 或纯文本。建议每篇 5000 到 20000 字符。
- (可选)在 元数据(可选) 中添加键值对,例如
source=network-wiki,最多 6 组。元数据随片段一起保存,检索时可以看到片段的来源。 - 选择 提交并 embedding。
网关把正文切成约 1200 字符的片段(相邻片段重叠 150 字符),逐段向量化后入库。文档库概览 显示 文档、内容片段 和 最近入库 时间。
删除文档会移除它的全部片段,不可恢复。
检索测试
步骤
- 在 检索测试 标签中输入一个问题。
- 选择返回条数,然后选择 检索。
结果按 相似度 从高到低排列。命中不理想时,换个问法,或检查文档标题和正文是否包含现场常用的叫法。
哪些功能会引用知识库
每次检索取相似度最高的几个片段,只保留相似度不低于 RST_RAG_SCORE_THRESHOLD(默认 0.75)的片段。使用多语言向量模型时,相关片段的相似度可能落在 0.4 到 0.7 之间,可以适当调低该值。