

告警收敛
把同一时段的大量故障收敛为告警风暴,指出根因设备和影响范围,再由 AI 对剩余分组评分、给出处置建议。专业版及以上提供。
一台核心交换机宕机,它后面的设备会同时不可达:一个故障,几百条问题。告警收敛把这样的风暴收成一起事件,指出最可能的根因设备和影响范围,再把其余故障按设备分组,由 AI 评出严重度和处置建议。告警收敛属于 alert_triage 功能,需要专业版或企业版许可,包括试用许可。
风暴的识别方法
有故障的主机是图中的节点。两台主机的首个故障落在关联时间窗内,并满足以下任一条件时,归入同一起风暴:
| 依据 | 条件 | 根因设备的选法 | 置信度 |
|---|---|---|---|
| 触发器依赖 | A 的触发器依赖 B 的触发器(B 在上游) | 最上游、下游设备最多的主机 | 90% |
| LLDP/CDP 邻居 | 一台主机的 LLDP/CDP 邻居监控项写着另一台的名称 | 连接最多的主机,相同时取最早出故障的 | 70% |
| 同组同时段 | 没有拓扑关系,但同一主机组内至少 5 台主机在时间窗内同时出故障 | 最早出故障的主机,相同时取严重度高的 | 40% |
关联时间窗默认 600 秒,由 RST_CORRELATION_WINDOW_S 设置。同组同时段的主机数下限由 RST_CORRELATION_STORM_MIN_HOSTS(默认 5)设置。设置 RST_CORRELATION=0 关闭风暴识别。
要得到可靠的根因,在 Zabbix 中为接入和汇聚设备的可达性触发器配置对上游设备的依赖。监控健康度中的规则 BL-MON-007 检查这一项。
运行收敛
前提条件
- 专业版或企业版许可,包括试用许可。
步骤
- 在 收敛哪些故障 中输入 主机组,或选择 所有可访问的主机组(跨组风暴收敛到根因)。
- 设置 时间窗(分钟),默认 60。窗口之前开始、仍未恢复的故障也会带上。
- (可选)设置 最多处理条数(1 到 100,默认 100)和 送模型评分的分组上限(1 到 30,默认 30)。
- (可选)在 event.get 覆盖参数(可选) 中用 JSON 补充
event.get的参数。 - 选择 开始收敛。
从对话选择 送去分诊,或从实时故障选择 送去研判 时,故障直接带入,页面提示 已接收 N 条故障。选择 改为从 Zabbix 拉取 回到按主机组拉取。
收敛过程中显示已运行的秒数,选择 停止 可以中断。完成后结果自动归档到分析记录。
收敛结果
结果顶部显示 故障事件 总数和分成的组数、已评分 和 高及以上 的分组数,以及 已收敛:多少起风暴。
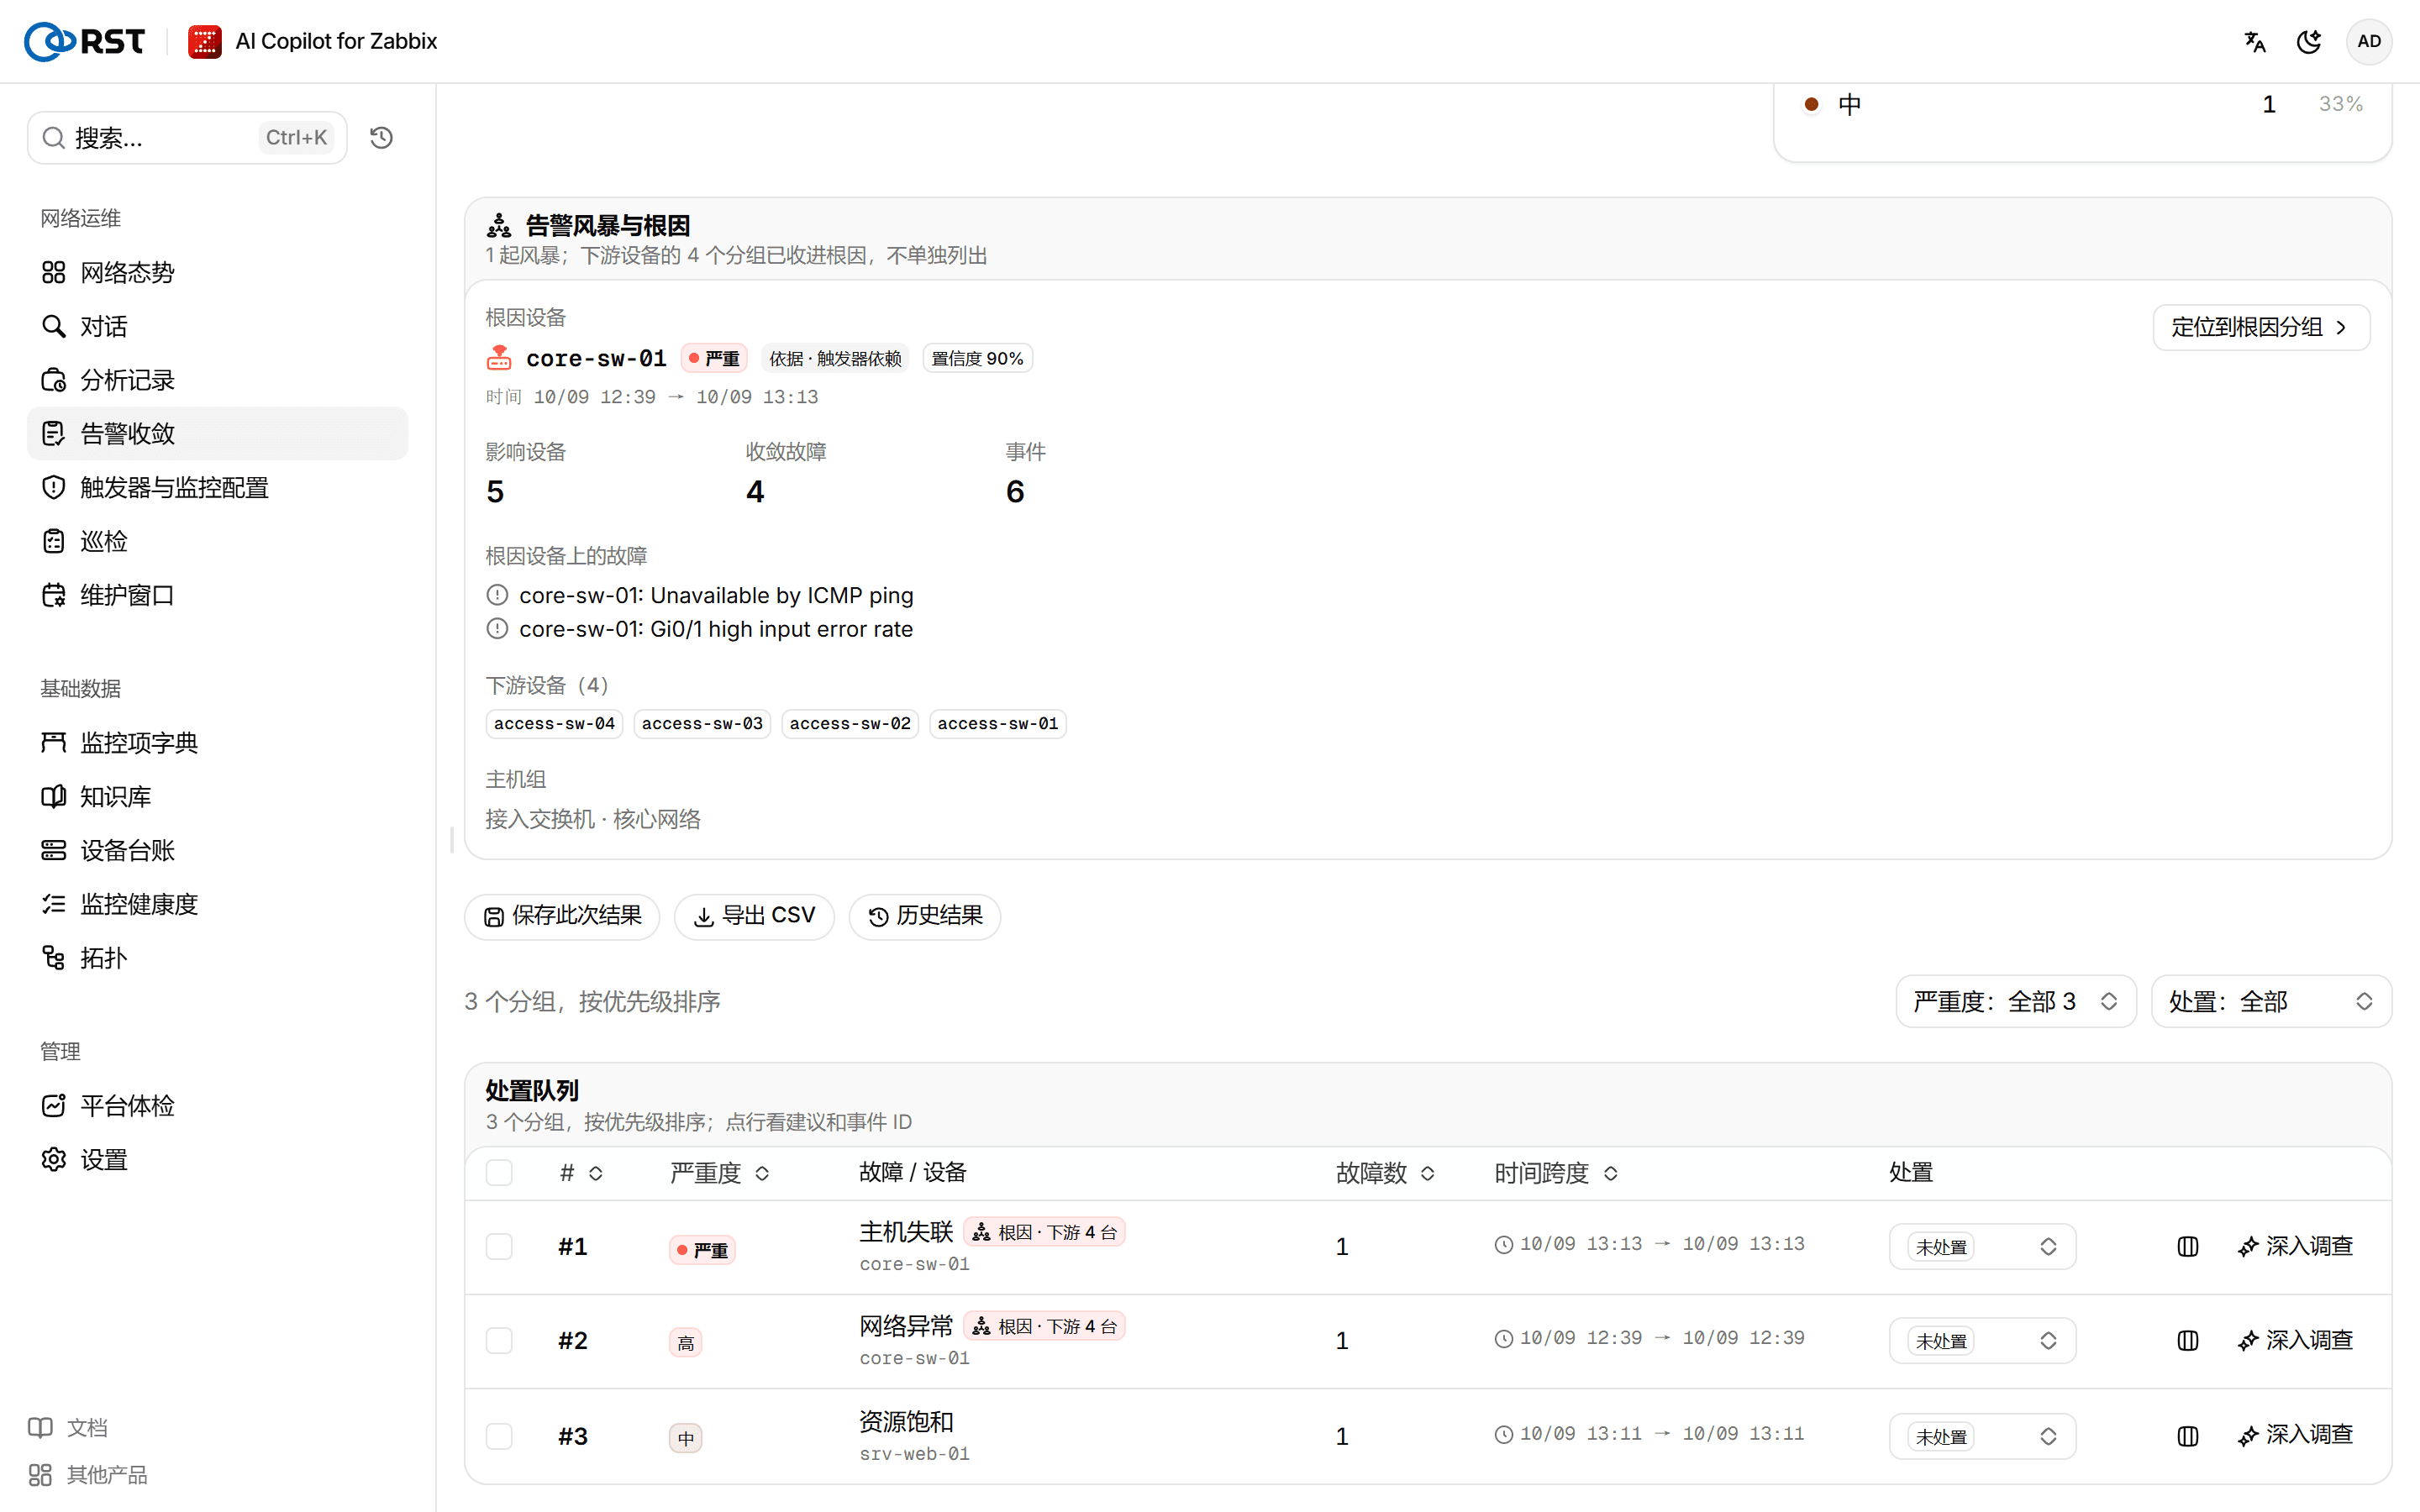
告警风暴与根因 列出每一起风暴:
| 字段 | 内容 |
|---|---|
| 根因设备 | 最可能的根因设备 |
| 依据 | 触发器依赖、LLDP/CDP 邻居或同组同时段,附置信度 |
| 影响设备、收敛故障、事件 | 风暴涉及的设备数、被收进根因的故障数和事件数 |
| 下游设备 | 被根因设备带下的设备 |
| 风险邻居 | 与根因设备直连、尚未出故障的设备 |
| 根因设备上的故障 | 根因设备自己的问题 |
下游设备的分组已收进根因,不在处置队列中单独列出。选择 定位到根因分组 跳到根因设备的分组。
处置队列 按优先级列出分组。选择一行查看 处置建议 和事件 ID。每行可以选择 对比,在页面底部并排对比,或选择 深入调查,围绕该设备发起故障调查。
模型不可用时,页面提示 AI 评分不可用。告警风暴照常识别,分组按 Zabbix 严重度和故障数排序,没有 AI 建议。模型恢复后重新提交即可。分组数超过评分上限时,页面提示有多少分组未评分,调高上限后重新提交。
处置分组
处置状态在团队内共享:未处置、已处置、误报、升级。
前提条件
- 分析员或管理员角色。查看者可以查看,不能修改处置状态或保存结果。
- 推送升级需要在对外通道中配置值班渠道。
步骤
- 在分组的 处置 中选择状态。也可以勾选多个分组,一次修改。
- 设为 升级 时,页面询问是否推送给值班渠道,确认后推送。
处置状态只保存在网关中,不写入 Zabbix。要确认 Zabbix 中的问题,在实时故障中操作。
保存与导出
选择 保存此次结果 并填写可选的备注,结果保存到服务端,全队可见。保存过的结果在 历史结果 中查看。选择 导出 CSV 下载分组列表。