产品实测··Sevion Xia
RST AI Copilot for Prometheus 实战测评
一个光模块连接头脏污,前 40 分钟没有一条告警,随后 16 条告警同时出现:看 Prometheus 与 RST AI Copilot for Prometheus 如何在一分钟内把它们定位到收光 -40 dBm 的根因。
版本 v1.0 · 2026-10 · 测评环境:RST AI Copilot for Prometheus 0.2.3 · Prometheus 2.53.0 · Alertmanager 0.27.0 · Grafana 11.1.0 · 模型 MiniMax-M3
摘要
汇聚交换机 agg-03 的一条上联光模块连接头逐渐污染,收光功率从 -2.4 dBm 缓慢下降。前 40 分钟读数始终高于预警线,没有告警;随后依次出现 CRC 错包、间歇失光、接口与 eBGP 会话抖动、流量绕行导致另一条上联利用率升至 88%,最终彻底失光。此时 Alertmanager 中共有 16 条告警,其中混有 5 台防火墙和 1 台 CPU 偏高设备的无关告警。
本次测评在 30 台设备的园区核心网仿真环境中按时间表注入该故障(参数见 lab/sim/labgen.py 的 optic_decay 场景,可复现),由 RST AI Copilot for Prometheus 完成告警之后的研判与调查。以下数据均来自 2026-10-12 的同一次实跑:
- 研判:30 秒内将 16 条告警聚为 6 簇并全部评分。agg-03 ↔ core-01 链路的接口中断排第一,BGP 中断被标为该链路的派生告警,防火墙和 CPU 两簇排在后面。
- 调查:对排第一的簇两端各调查一次。agg-03 端执行 10 条 PromQL、耗时 45 秒,查到该端口收光 -40 dBm(预警线 -13.5 dBm),判定为光模块或光纤故障。core-01 端执行 13 条查询、耗时 53 秒,同样判断为物理链路故障,并建议优先检查收光功率。
- 护栏:模型生成的 PromQL 须经 Prometheus 校验,只走查询接口;每次最多返回 20 条序列,主机名、IP 等标签脱敏后才提交给模型;每次调查受轮数、时限和 token 预算约束。
Prometheus 负责告警,RST AI Copilot for Prometheus 在一分钟内给出这屏告警背后的根因,并附上查询证据。处置由人决定。
一、序章
测评网络是一套 30 台设备的园区核心网:出口路由器 wan-01,两台核心 core-01、core-02(华为 CE12804,AS 65000),10 台多厂商防火墙,6 台汇聚和 11 台接入。每台汇聚有两条 100G 上联,分别接两台核心;agg-01 至 agg-04 与核心之间运行 eBGP。agg-03 为 H3C S6850-56HF,本次故障发生在它接 core-01 的上联上。
11:37,agg-03 接 core-01 的上联 HGE1/0/1 光模块开始劣化,收光功率逐分钟下降,40 分钟内未触及 -13.5 dBm 预警线。约第 17 分钟出现 CRC 错包;约第 33 分钟起每 150 秒失光 45 秒,接口和 BGP 会话随之翻动,流量绕到 agg-03 ↔ core-02 上联,利用率升至 88%;约第 49 分钟彻底失光。
12:31,值班工程师打开 Alertmanager:
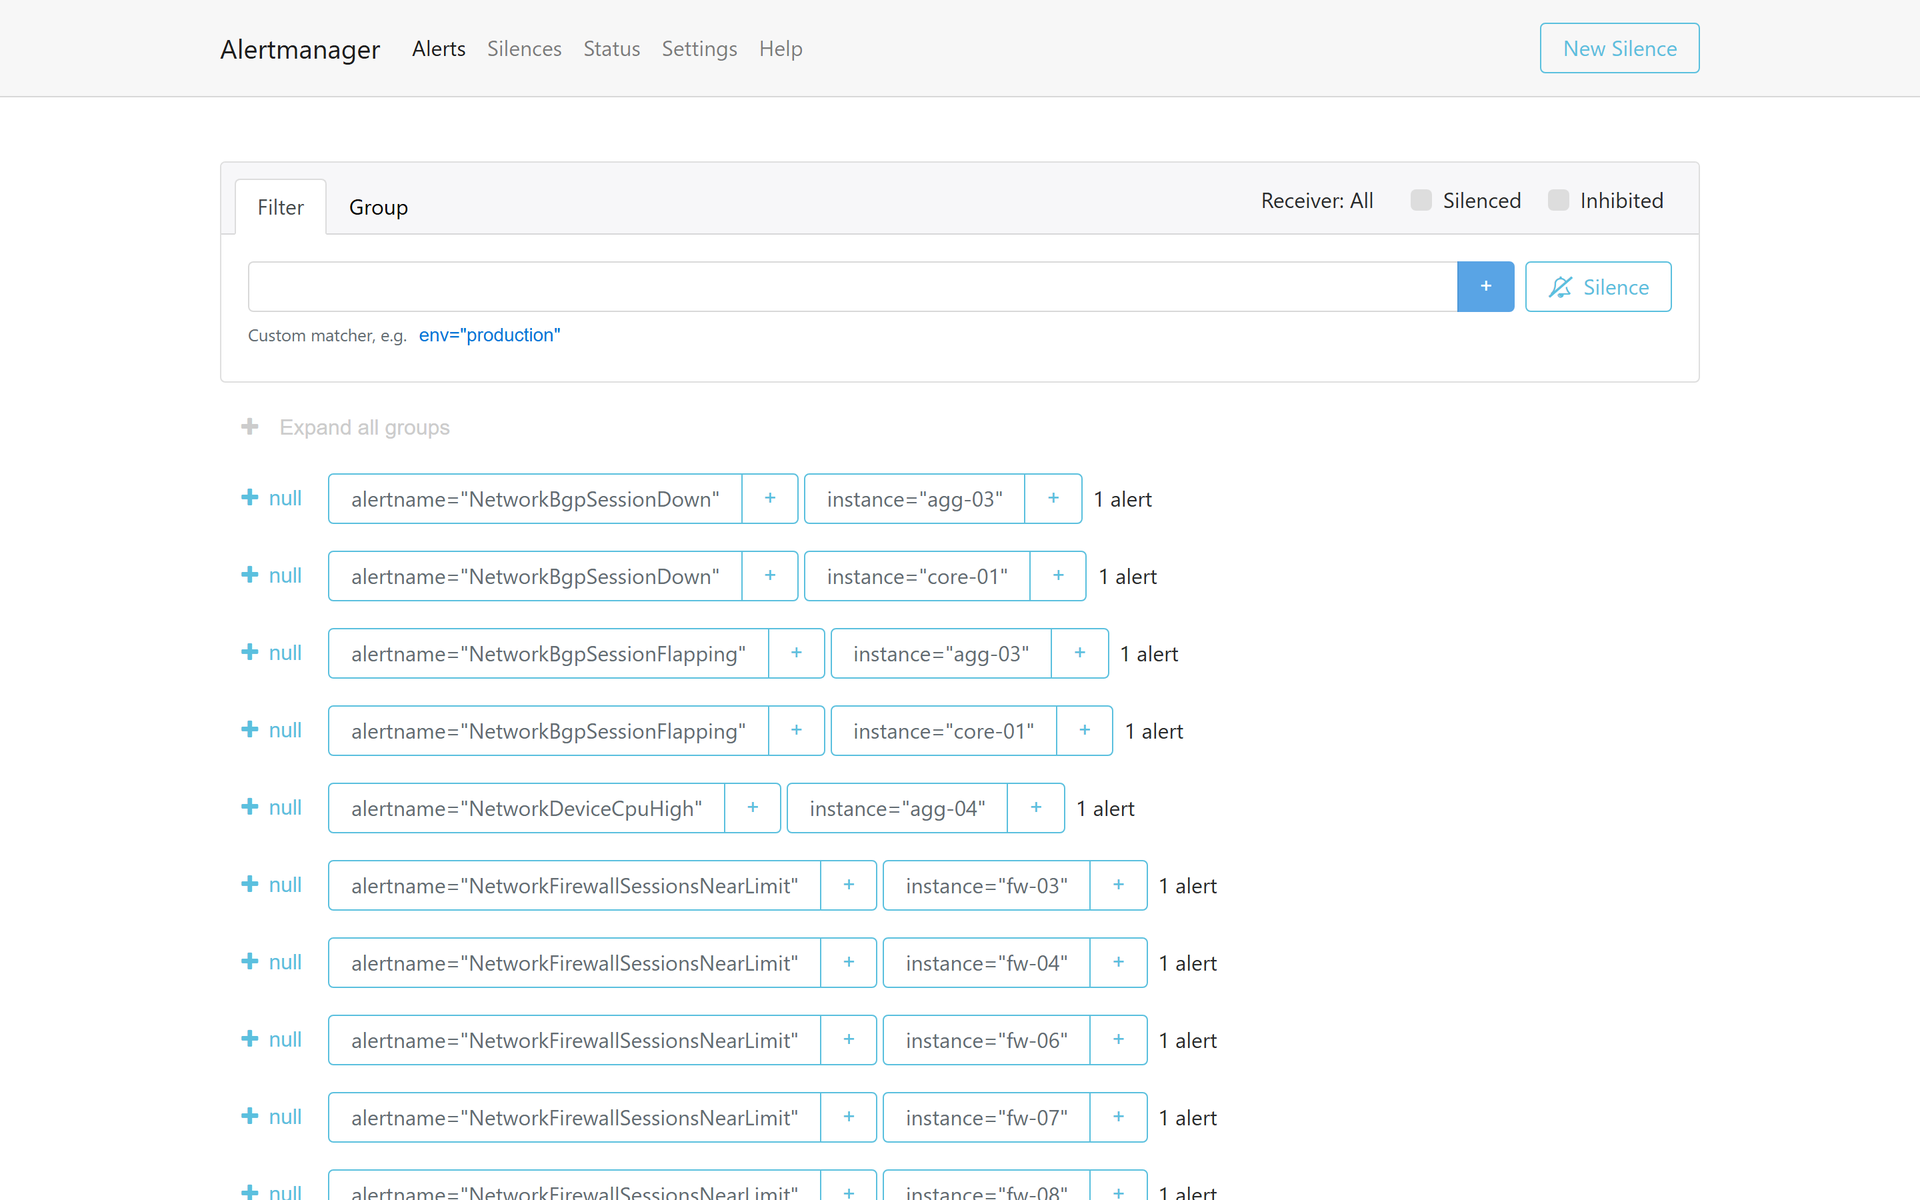
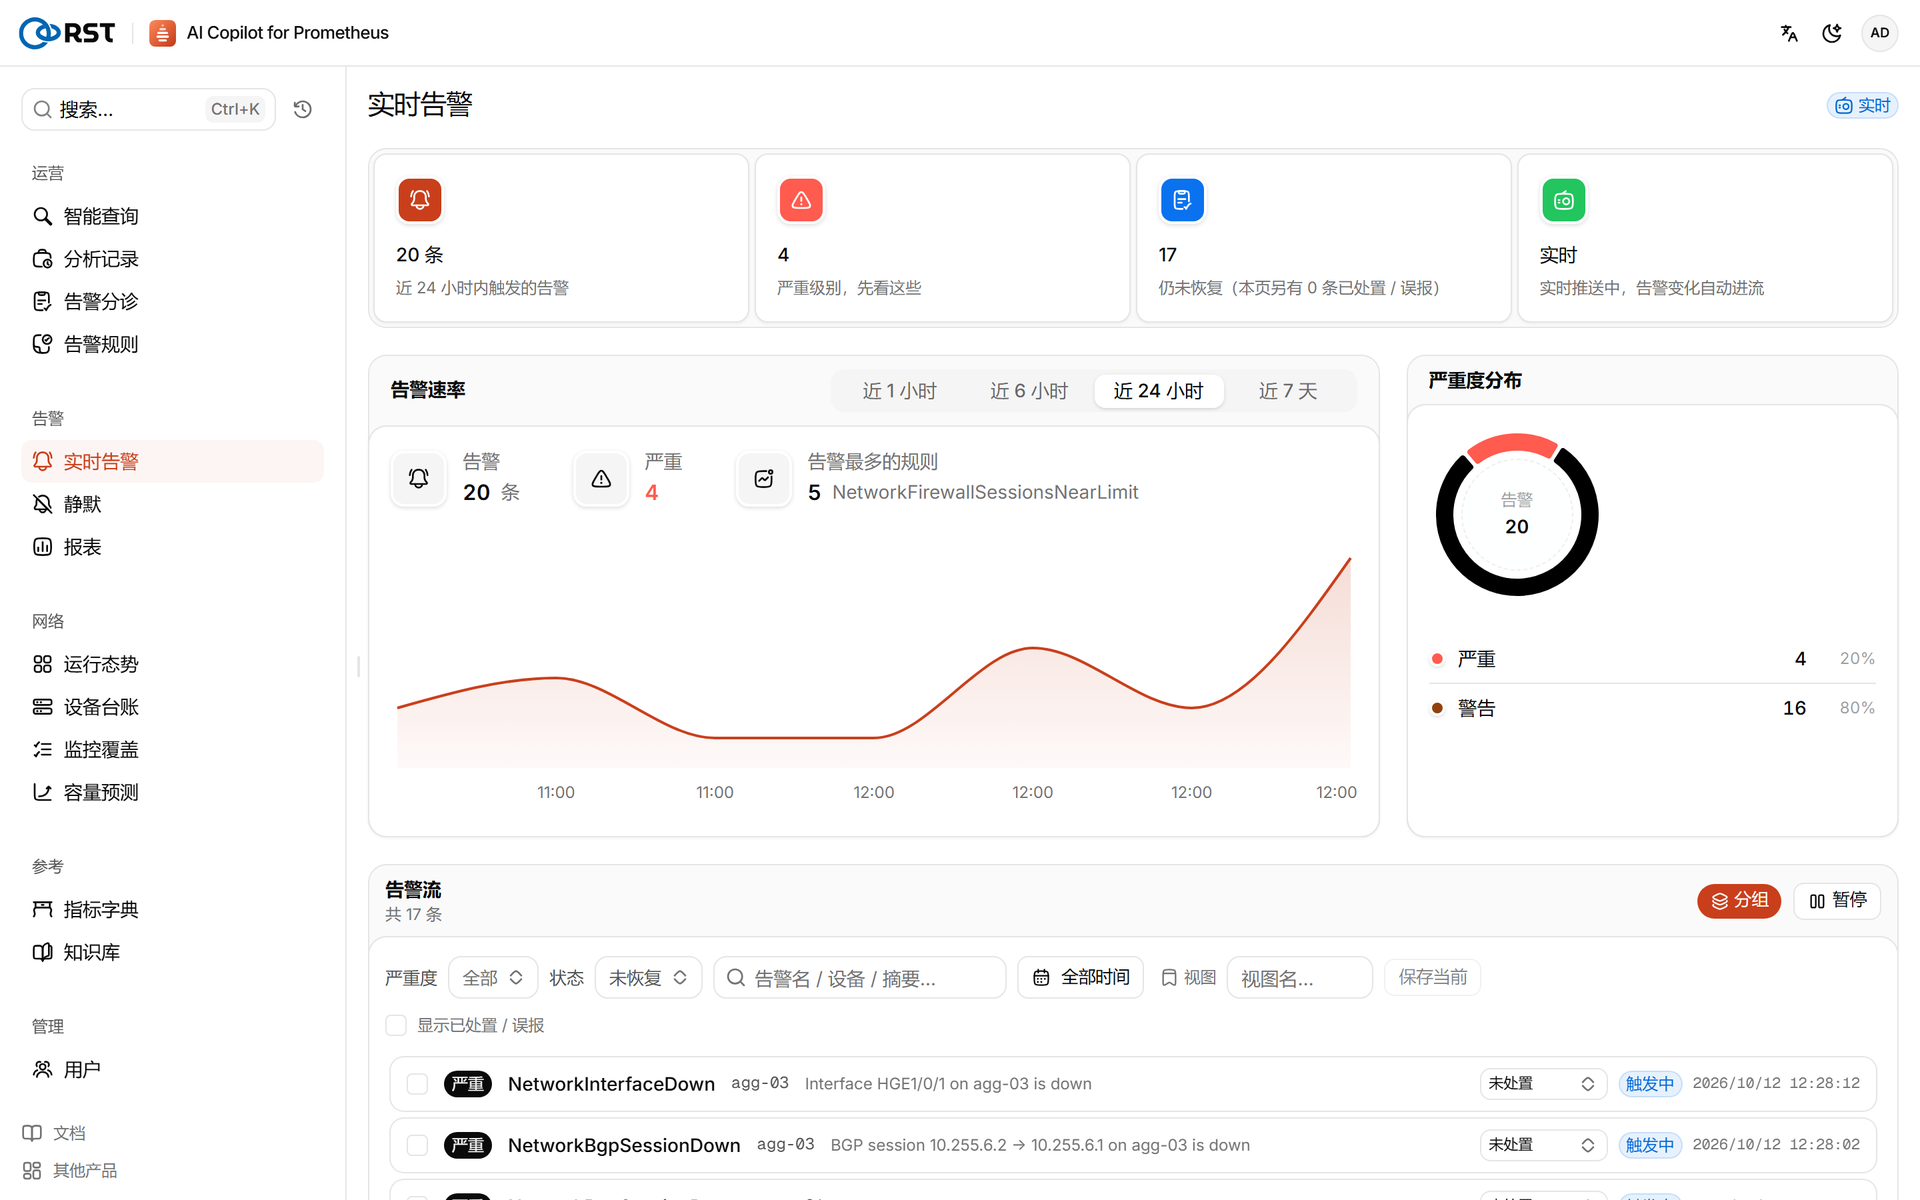
共 16 条告警:两端接口中断、两端 BGP 会话中断、两端 BGP 抖动、4 条带宽过高、5 台防火墙会话表接近上限、agg-04 CPU 偏高。最早触发的"收光功率过低"告警在失光后已自动消除(规则将 -30 dBm 以下视为无光,交由接口中断告警处理)。工程师需要回答三个问题:
- 先处理哪条? 有 4 条 critical 和若干 warning,Alertmanager 不排先后。
- 哪些属于同一事件? BGP 中断、BGP 抖动、带宽过高是否同源,防火墙和 CPU 告警是否相关。
- 根因是什么? 接口 down 只是现象,原因可能是光模块、光纤、对端端口或误操作,需要手写十几条 PromQL 排查。
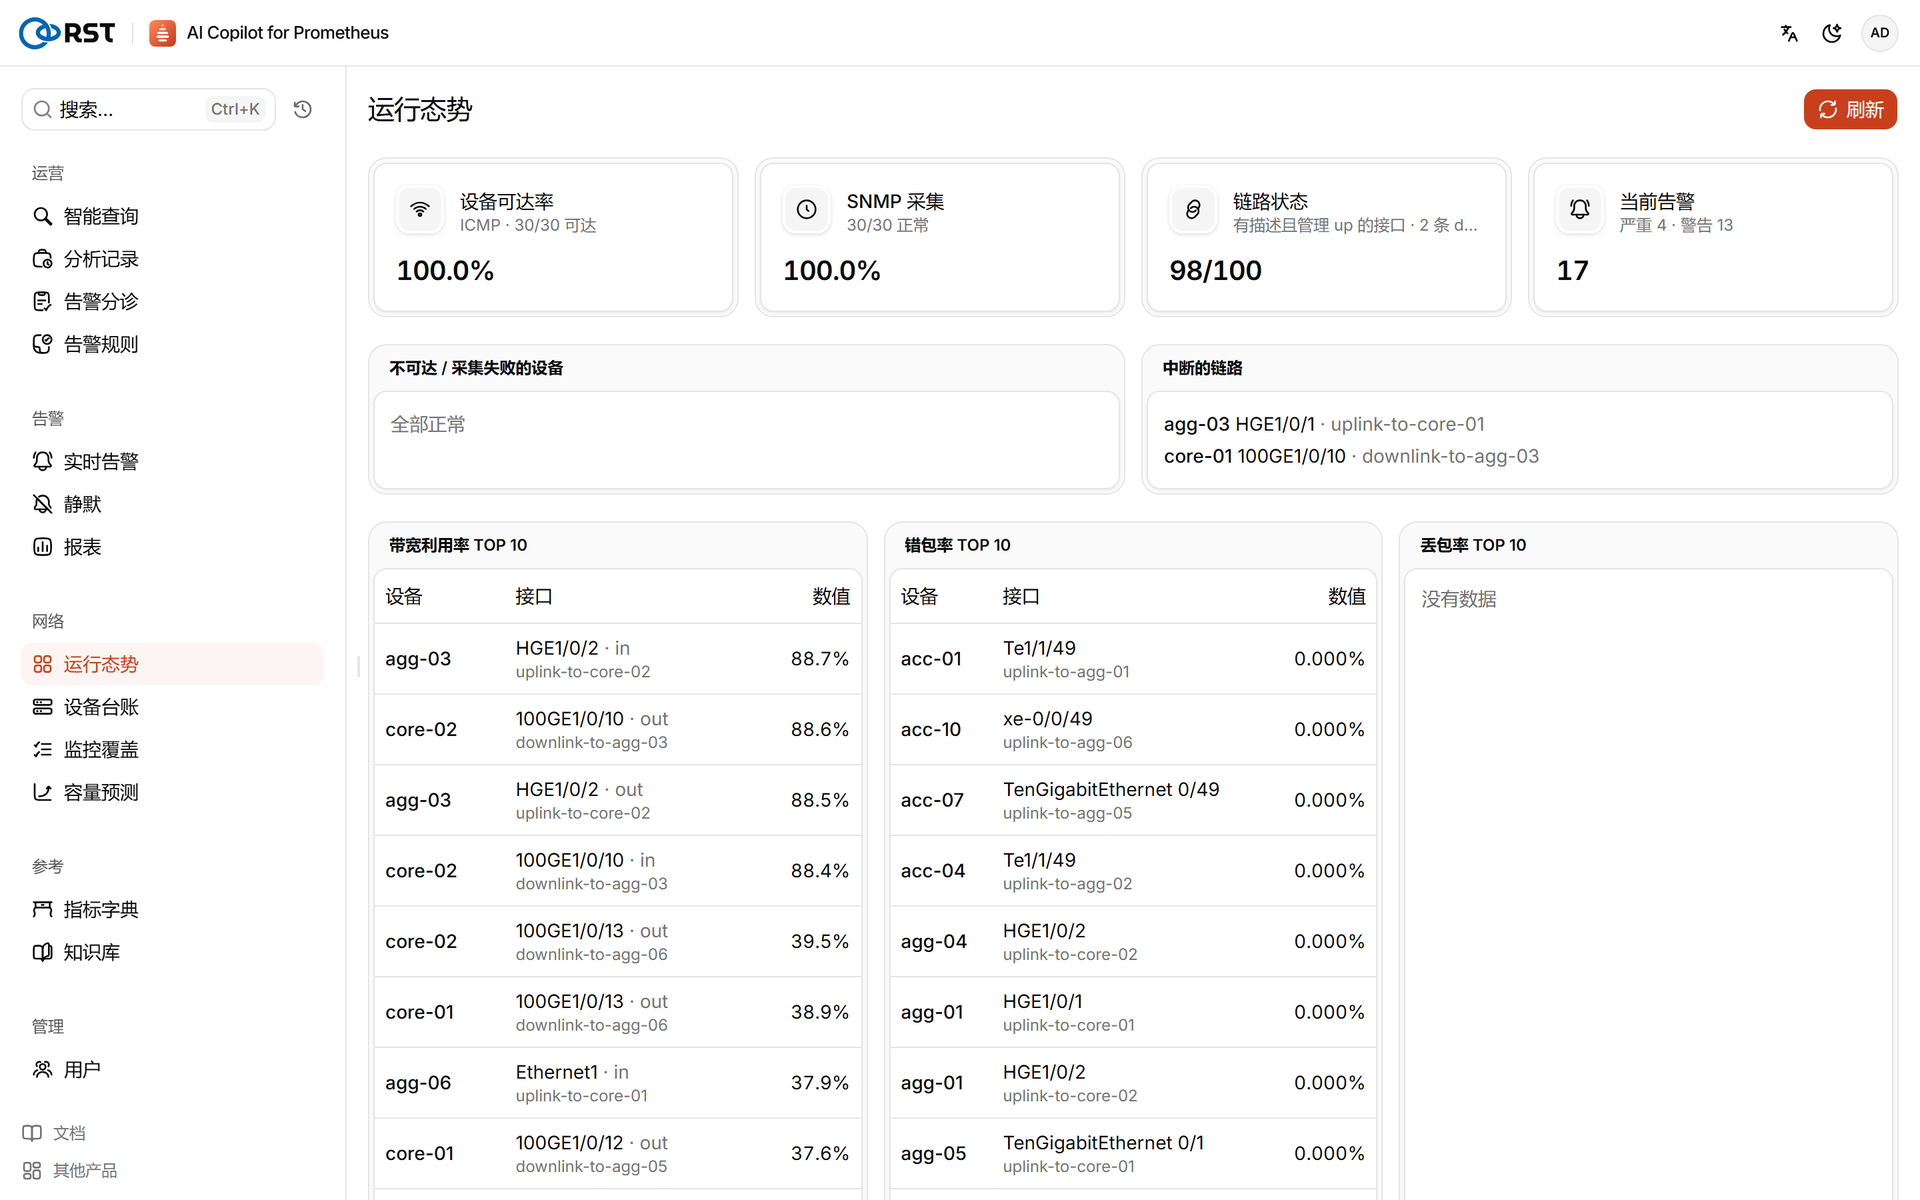
RST AI Copilot for Prometheus 部署在 Prometheus 和 Alertmanager 之上,通过 HTTP API 读取指标和告警,不替代告警规则,负责告警之后的研判与调查。同一时刻,它的「运行态势」页已经把范围收窄:「中断的链路」列出 agg-03 HGE1/0/1 ↔ core-01 100GE1/0/10,带宽利用率前四位都是承接绕行流量、利用率 88% 的那条链路。
二、双线复盘
下表左侧是网络中实际发生的事件,右侧是 Prometheus 是否告警,以及 RST AI Copilot for Prometheus 补充的信息。

时间为本地时间;"分钟"指场景开启(11:37)后的分钟数;告警时刻取 Prometheus ALERTS 进入 firing 的时间。
| 时间 | 实际事件 | Prometheus 告警 | RST AI Copilot for Prometheus 补充 |
|---|---|---|---|
| 0–41 分钟 | agg-03 HGE1/0/1 收光从 -2.4 dBm 缓慢下降,始终高于 -13.5 dBm 预警线 |  无(规则只判阈值,不判趋势) | 调查预取 deriv(rx_power[1h]);智能查询可直接画出下降曲线 |
| 开场即有 | 5 台防火墙会话表接近上限(无关) |  FirewallSessionsNearLimit ×5 | 单独成簇,排第六 |
| 15 分钟 | agg-04 CPU 偏高(无关) | DeviceCpuHigh | 单独成簇,排第四 |
| 约 17 分钟起 | 收光 -7 dBm,入方向出现 CRC 错包 | InterfaceErrorRateHigh(30 分钟) | 分诊时已恢复 |
| 约 33 分钟起 | 收光 -11.5 dBm,周期性失光,两端接口翻动 | InterfaceFlapping(37 分钟) | 降噪面板列出 agg-03 HGE1/0/1 的状态变化 |
| 约 33 分钟起 | agg-03 ↔ core-01 eBGP 会话反复建拆 | BgpSessionFlapping(37.5 分钟) | 两端抖动聚为一簇,排第二 |
| 约 33 分钟起 | 流量绕到 agg-03 ↔ core-02,利用率约 88% | InterfaceBandwidthHigh ×4(48 分钟) | 指出该链路在承接 core-01 方向流量 |
| 约 41 分钟 | 收光越过 -13.5 dBm 预警线 | TransceiverRxPowerLow(46.5 分钟触发,49 分钟失光后消除) | 分诊时已消除;调查从光功率指标中找回 |
| 约 49 分钟 | 彻底失光,读数 -40 dBm,接口和 BGP 持续 down | InterfaceDown ×2(50.5–51 分钟)、BgpSessionDown ×2(51 分钟) | 排第一;调查确认无光,定位到物理层 |
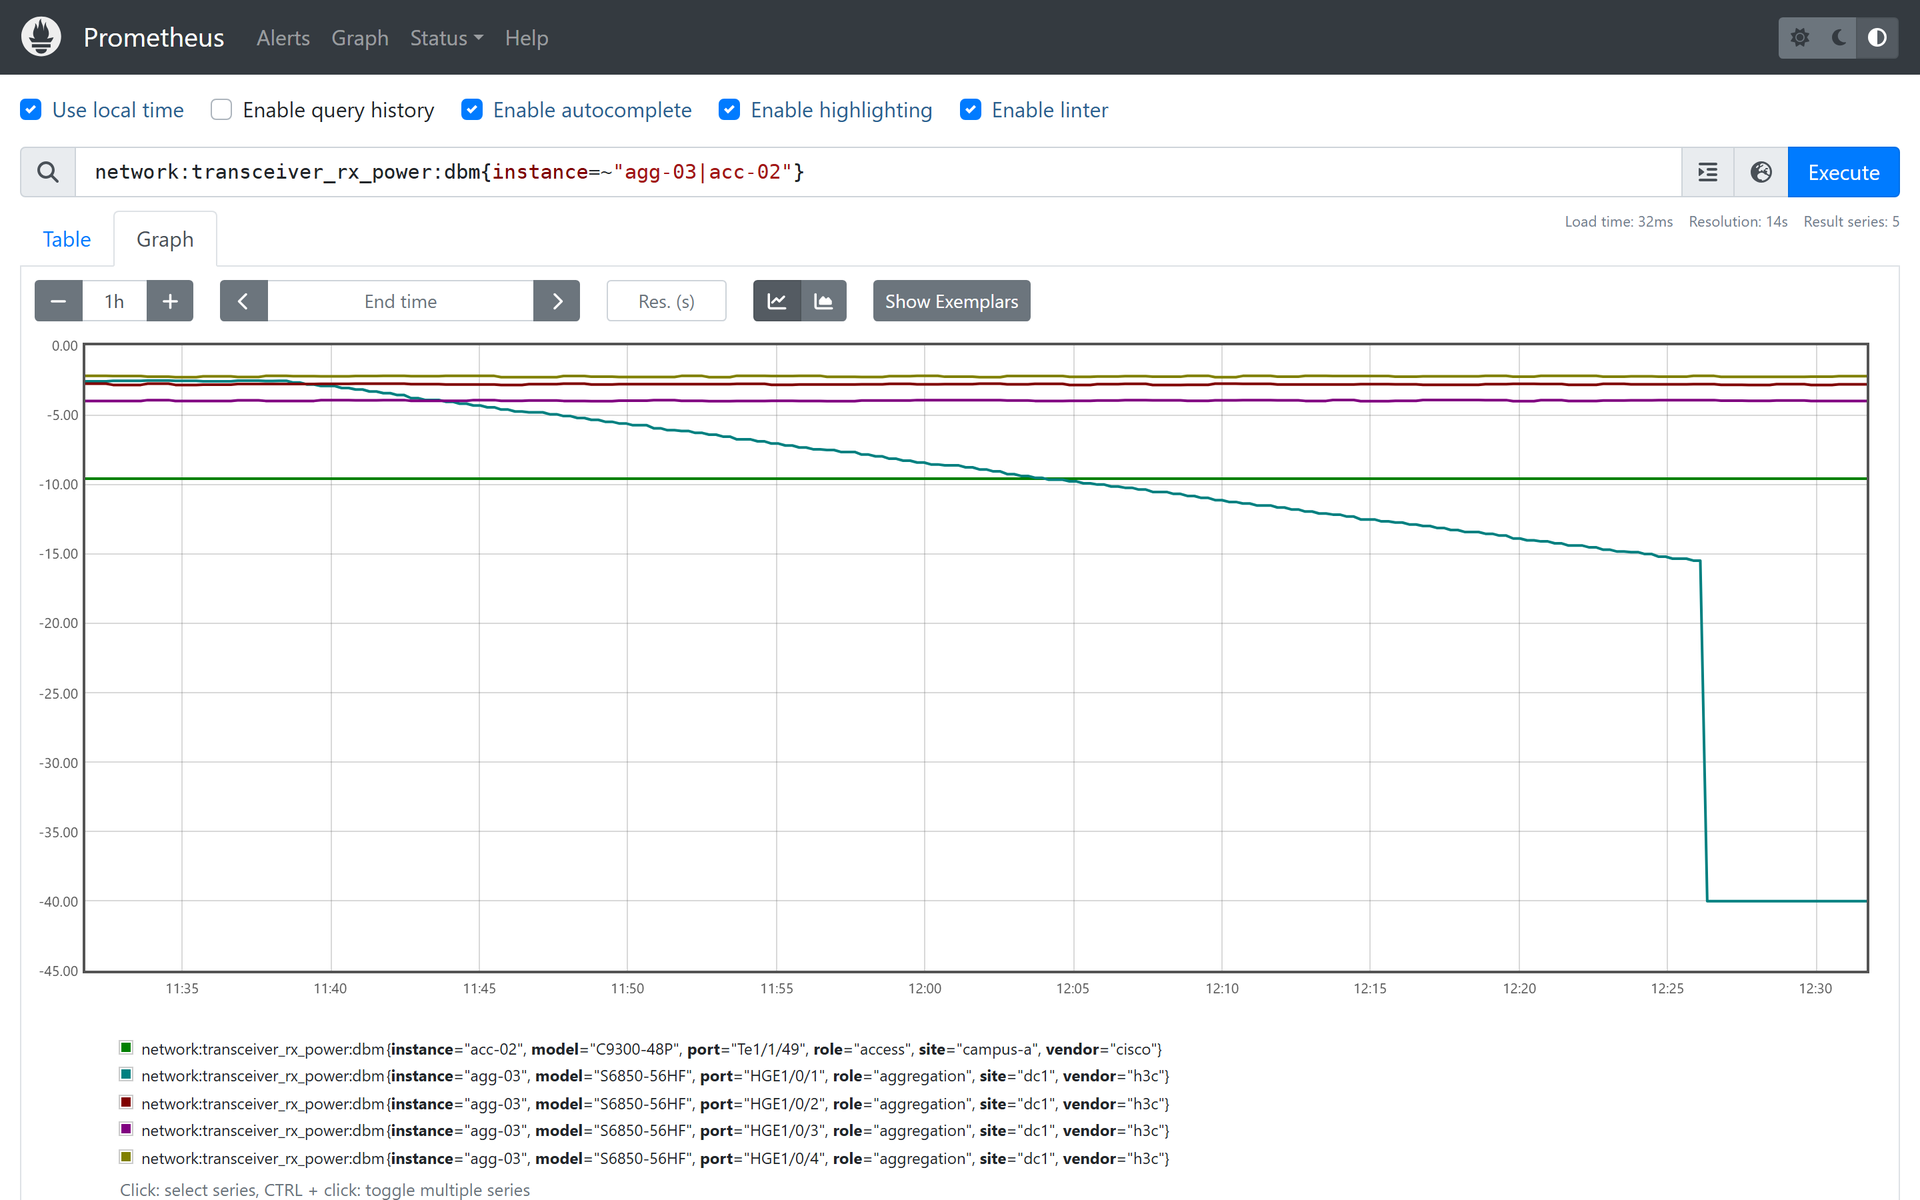
第一行最关键:故障的前 40 分钟没有任何告警。规则包有意不对"缓慢下降但未越线"告警,因为这类趋势告警在生产网络中噪声很大。这段过程只存在于 TSDB 的指标里,需要主动查询才能发现。
Prometheus 中的收光功率曲线(agg-03 四个光口和 acc-02 一个光口,最近 1 小时):
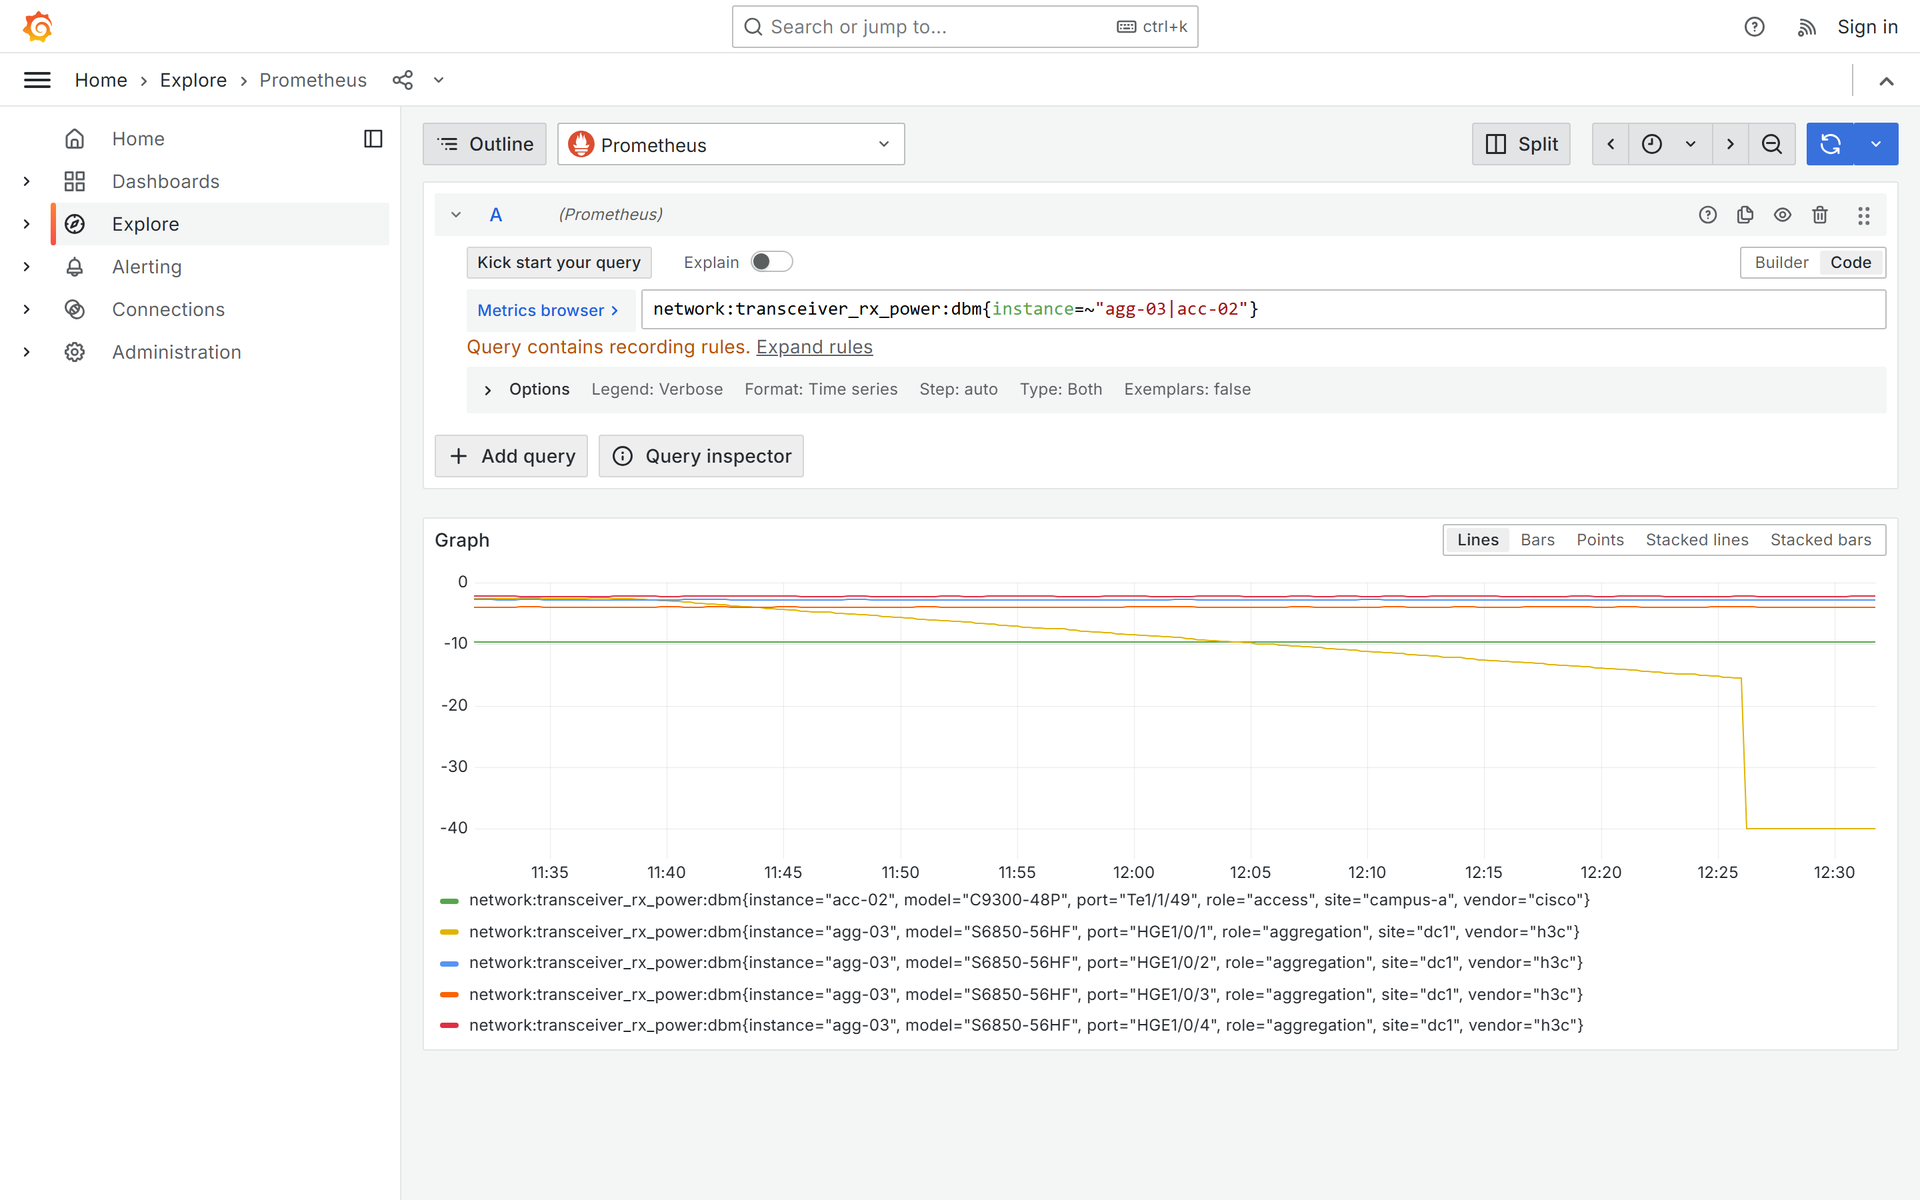
Grafana Explore 中的同一数据:
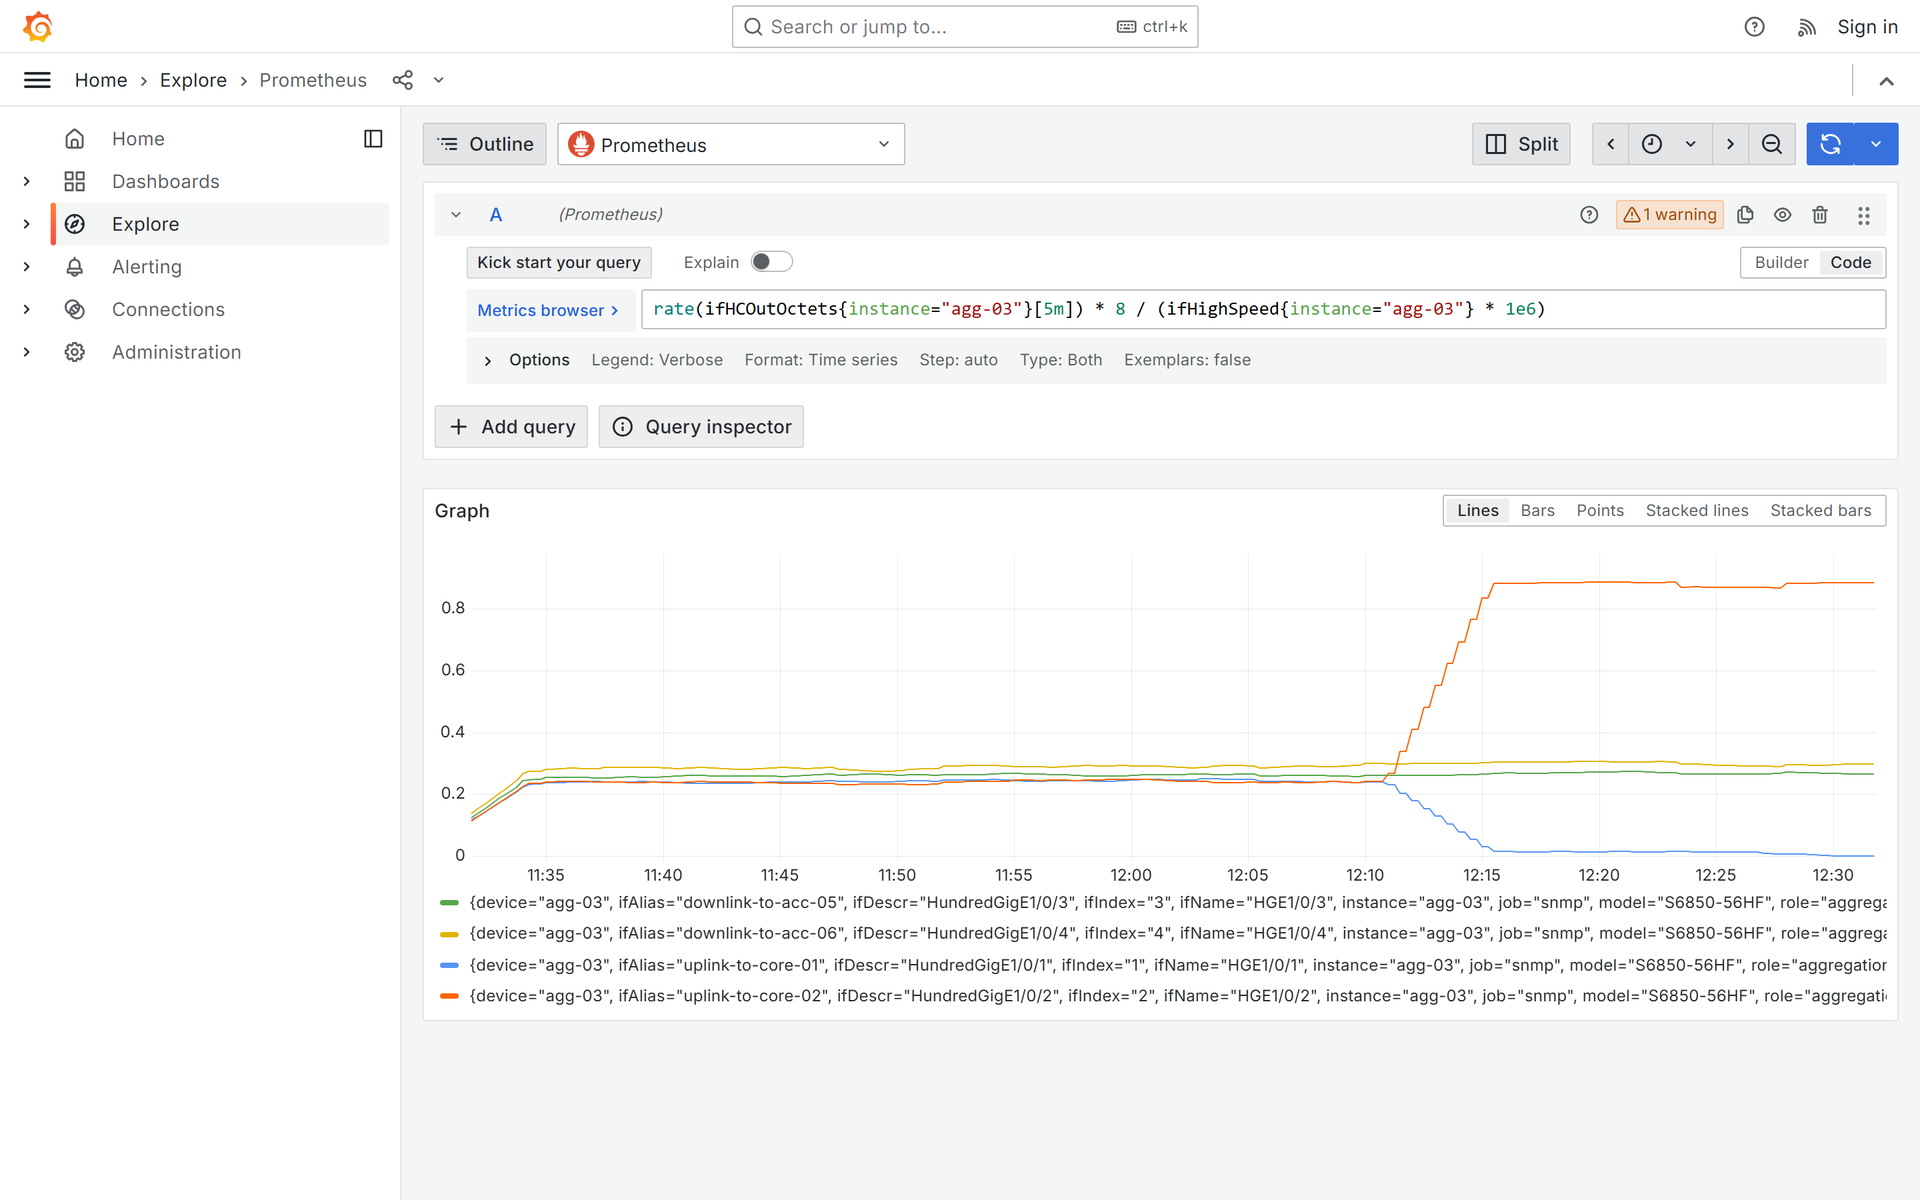
agg-03 两条上联的出方向利用率:12:10 前后,接 core-01 的链路(蓝)降到 0,接 core-02 的链路(橙)升至约 88%。
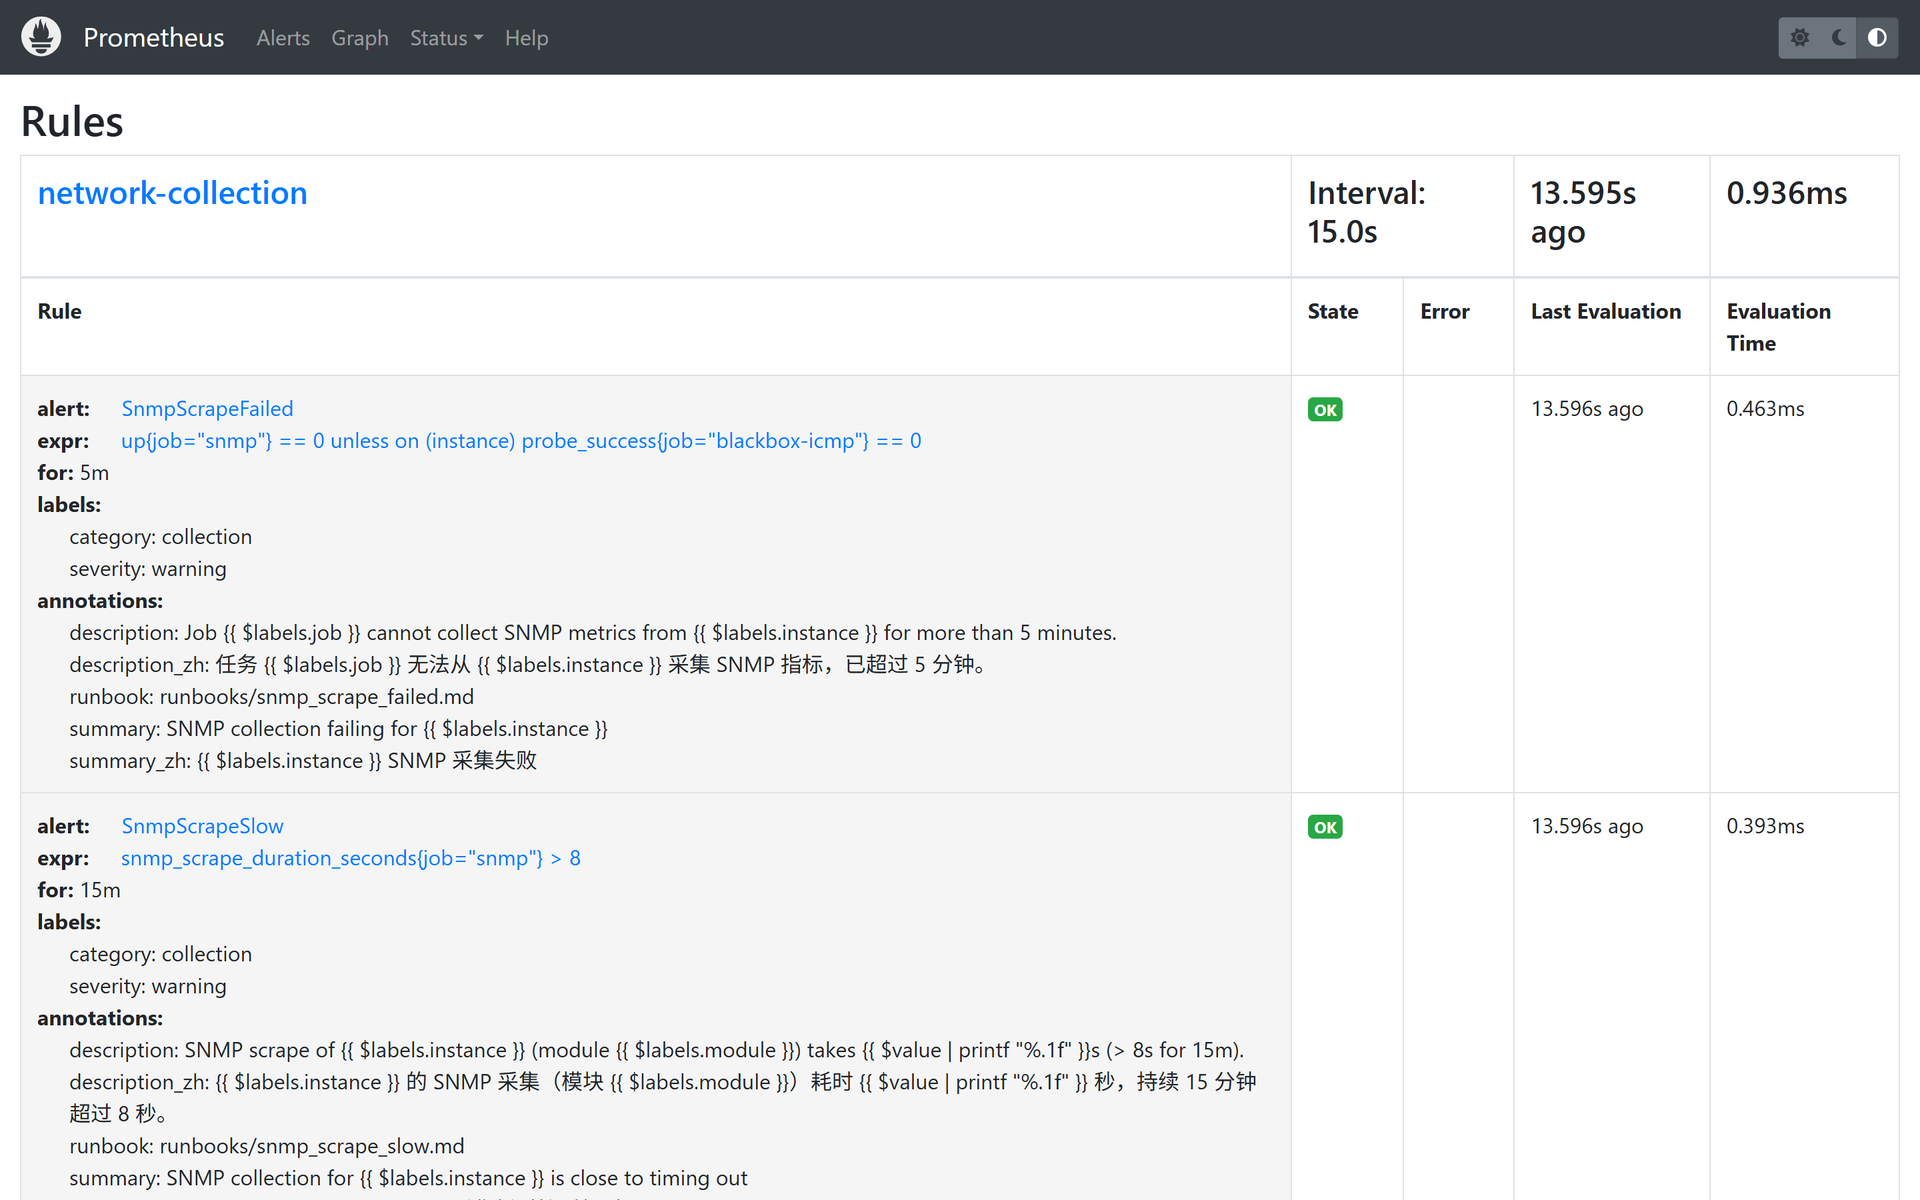
本次用到的告警规则:
三、研判
「实时告警」页按严重度、时间线和规则汇总 Alertmanager 告警,分诊和调查都从这里发起。
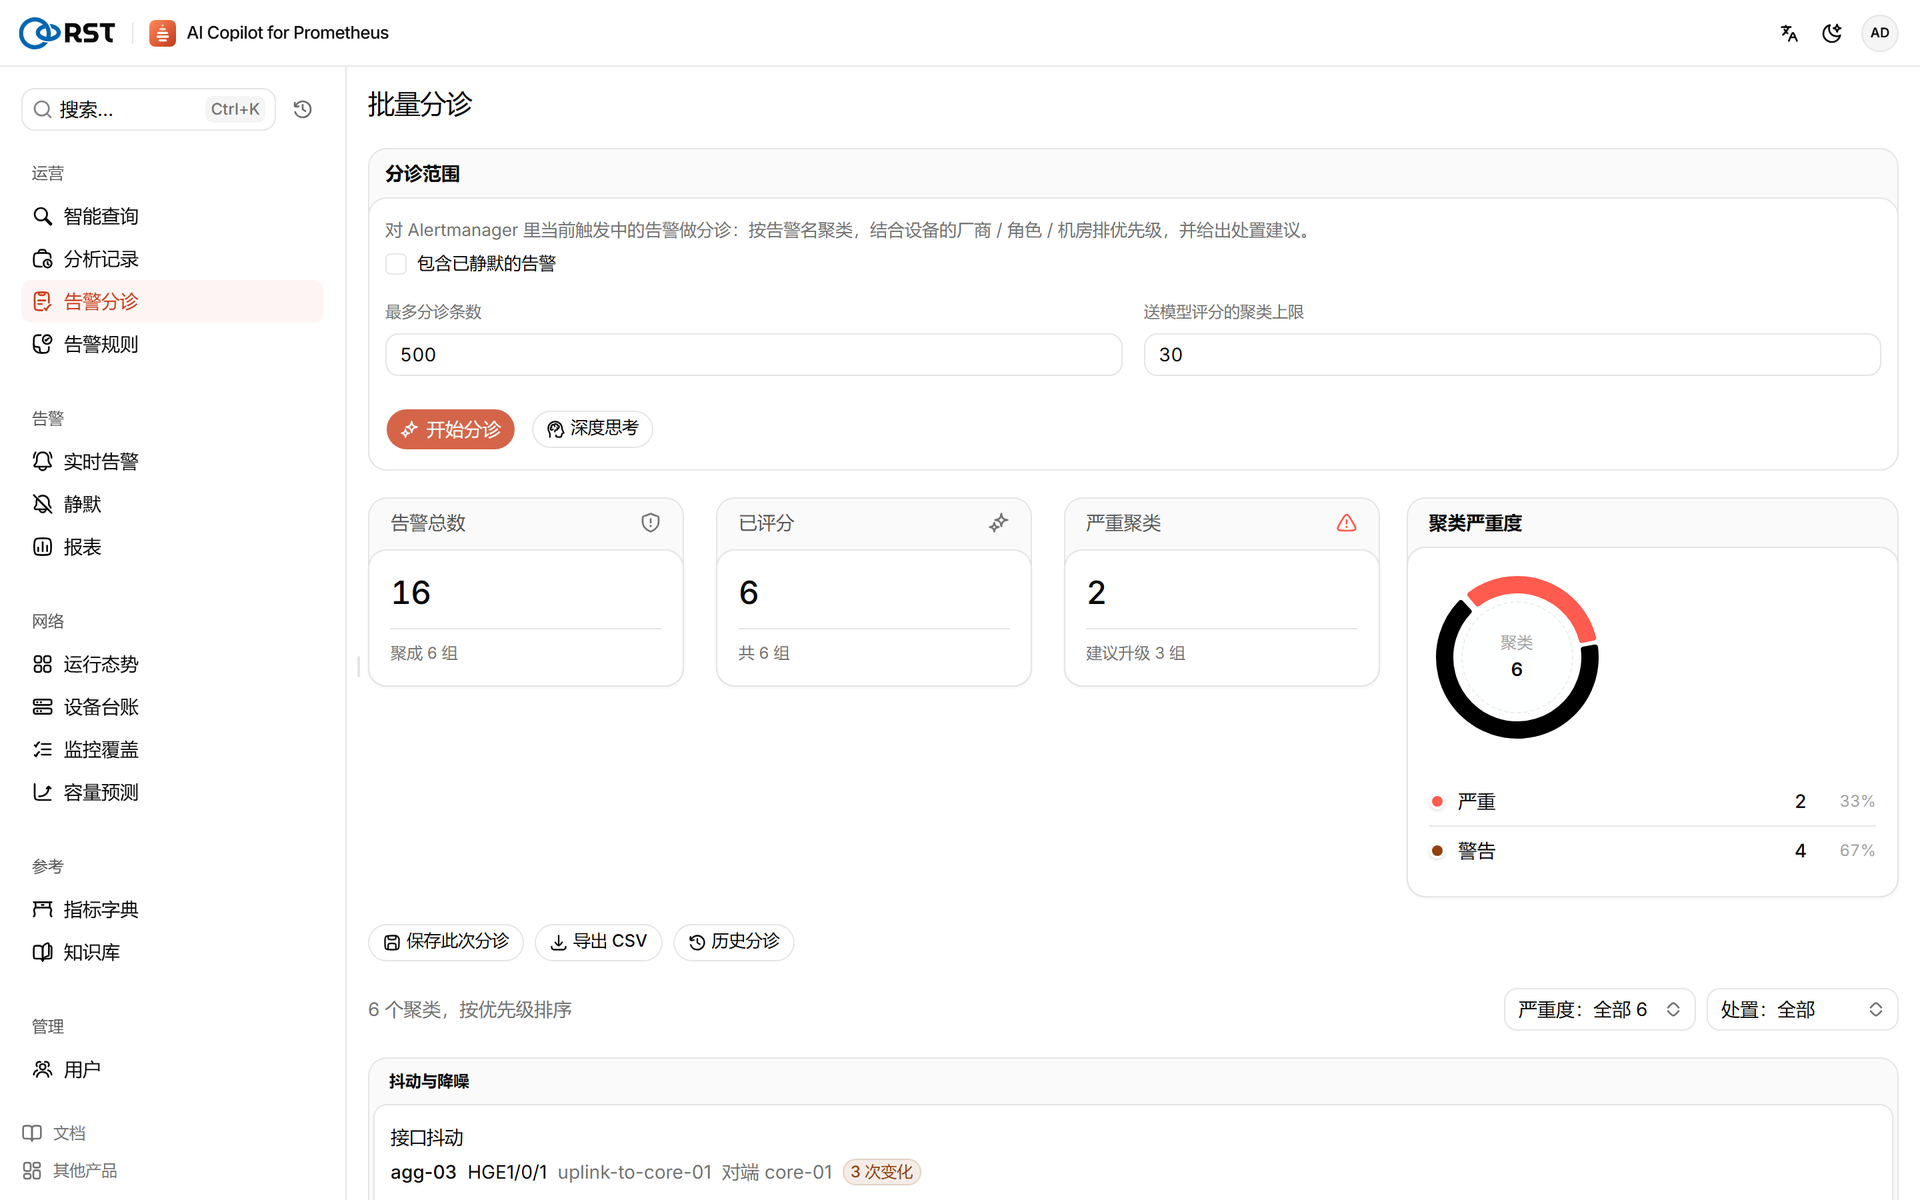
工程师在「告警分诊」中点击「开始分诊」。产品拉取当前全部告警,按(告警名,设备)聚类,附上设备台账中的厂商、型号、角色和站点,由模型完成评级、排序、误报判断和处置建议。
30 秒出结果。16 条告警聚为 6 簇,全部评分,无降级。严重 2 簇、警告 4 簇,3 簇建议升级。
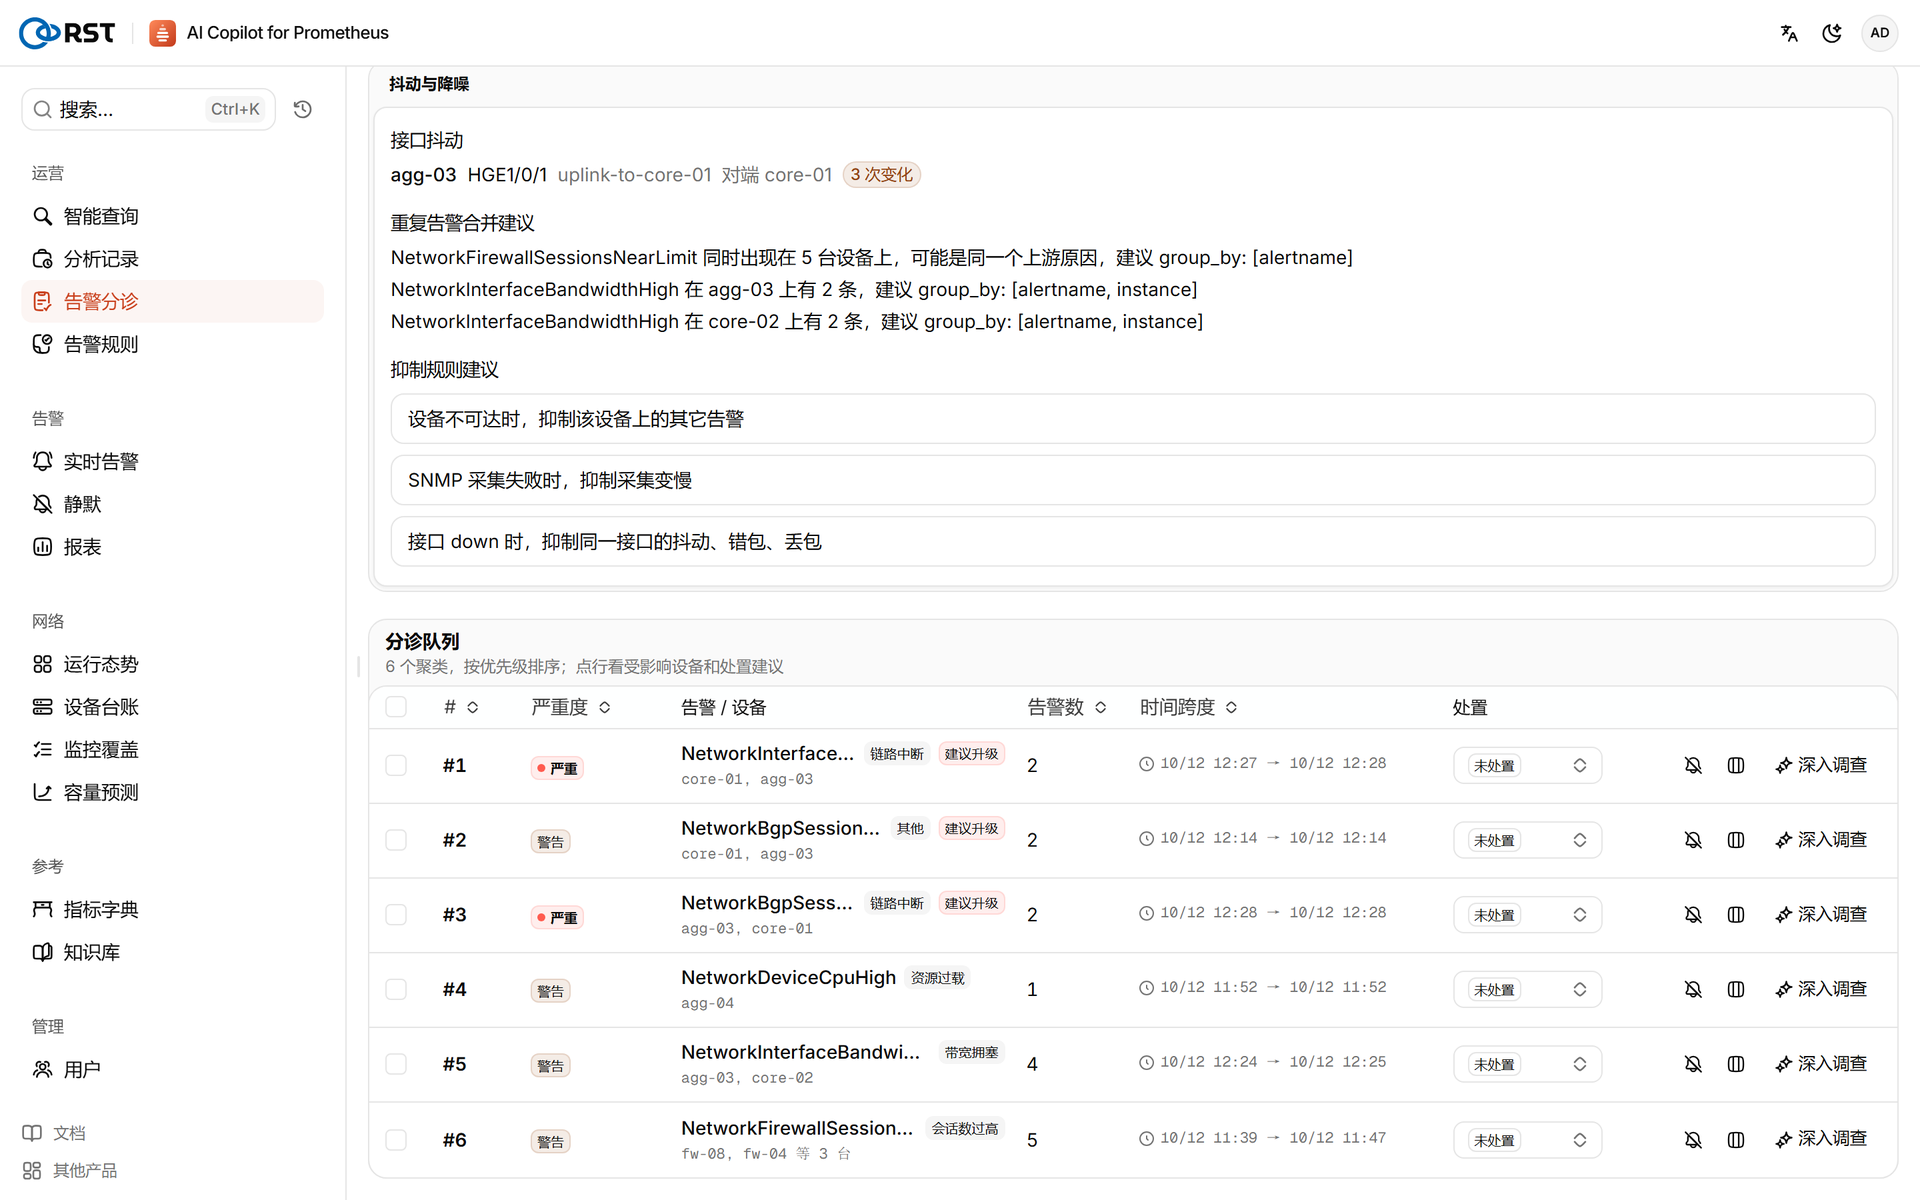
| 优先级 | 严重度 | 告警 / 设备 | 告警数 | 研判要点 |
|---|---|---|---|---|
| #1 | 严重 | NetworkInterfaceDown · core-01、agg-03 | 2 | 链路中断,建议升级;两端检查收发光功率与错包 |
| #2 | 警告 | NetworkBgpSessionFlapping · core-01、agg-03 | 2 | 建议升级;排查单链或光模块问题导致的反复建拆 |
| #3 | 严重 | NetworkBgpSessionDown · agg-03、core-01 | 2 | 标为 #1 链路的派生告警,链路恢复后 BGP 应自动重建 |
| #4 | 警告 | NetworkDeviceCpuHigh · agg-04 | 1 | 独立事件,给出 H3C 查看 CPU 的命令 |
| #5 | 警告 | NetworkInterfaceBandwidthHigh · agg-03、core-02 | 4 | agg-03 HGE1/0/2(接 core-02)出方向 88.54% |
| #6 | 警告 | NetworkFirewallSessionsNearLimit · 5 台防火墙 | 5 | 标为疑似误报(约 40 分钟未再触发),建议登录确认 |
排序与实际情况一致:接口中断排第一,BGP 中断被识别为派生告警,带宽和防火墙告警排在后面。降噪面板还列出了 core-01 侧端口的状态变化,并针对重复告警给出 Alertmanager group_by 和抑制规则建议。
分诊建议是给工程师的起点,落地前建议对照现场核对几处细节:
- #5 的流量方向:带宽升高是 #1 中断后流量绕行造成的,处置上应先恢复 #1,而不是扩容这条链路。
- #3 的会话类型:汇聚与核心之间是 eBGP,查看会话时按 eBGP 对端核对。
- #6 的误报判断:这 5 条告警在分诊时仍在 firing,按建议登录设备确认后再决定是否静默。
四、调查
工程师对排第一的簇点击「深入调查」。该簇包含同一链路两端的两条告警,先后对 core-01 端和 agg-03 端各调查一次。
调查分两步:
- 固定预取:模型介入前,服务端按告警标签执行一组查询,包括设备存活、CPU/内存/温度、端口状态和流量错包。告警带端口时,加查该端口的收光功率、预警线和
deriv(rx_power[1h])斜率;带 BGP 对端时,加查对端状态和 1 小时内的重建次数。 - 自主检索:模型根据预取结果自行编写只读 PromQL,按返回结果决定下一步。每轮可并发多条查询,最多 4 轮模型调用、120 秒。
agg-03 端:45 秒定位到 -40 dBm
agg-03 为 H3C 设备,有光模块采集数据。预取的三条光功率查询结果:
| 证据 | 值 |
|---|---|
network:transceiver_rx_power:dbm{instance="agg-03", port="HGE1/0/1"} | -40 dBm |
network:transceiver_rx_power_low_warn:dbm{…} | -13.50 dBm |
deriv(network:transceiver_rx_power:dbm{…}[1h]) * 3600 | -35.24 dB/h |
模型随后执行 10 条查询,全部成功:core-01 存活与探测、core-01 上 admin up 但 oper down 的端口、两端端口近 30 分钟状态、core-01 对应端口光功率(0 条序列,仿真环境未模拟华为光模块)、agg-03 各端口状态分布、该端口 1 小时内状态变化次数。
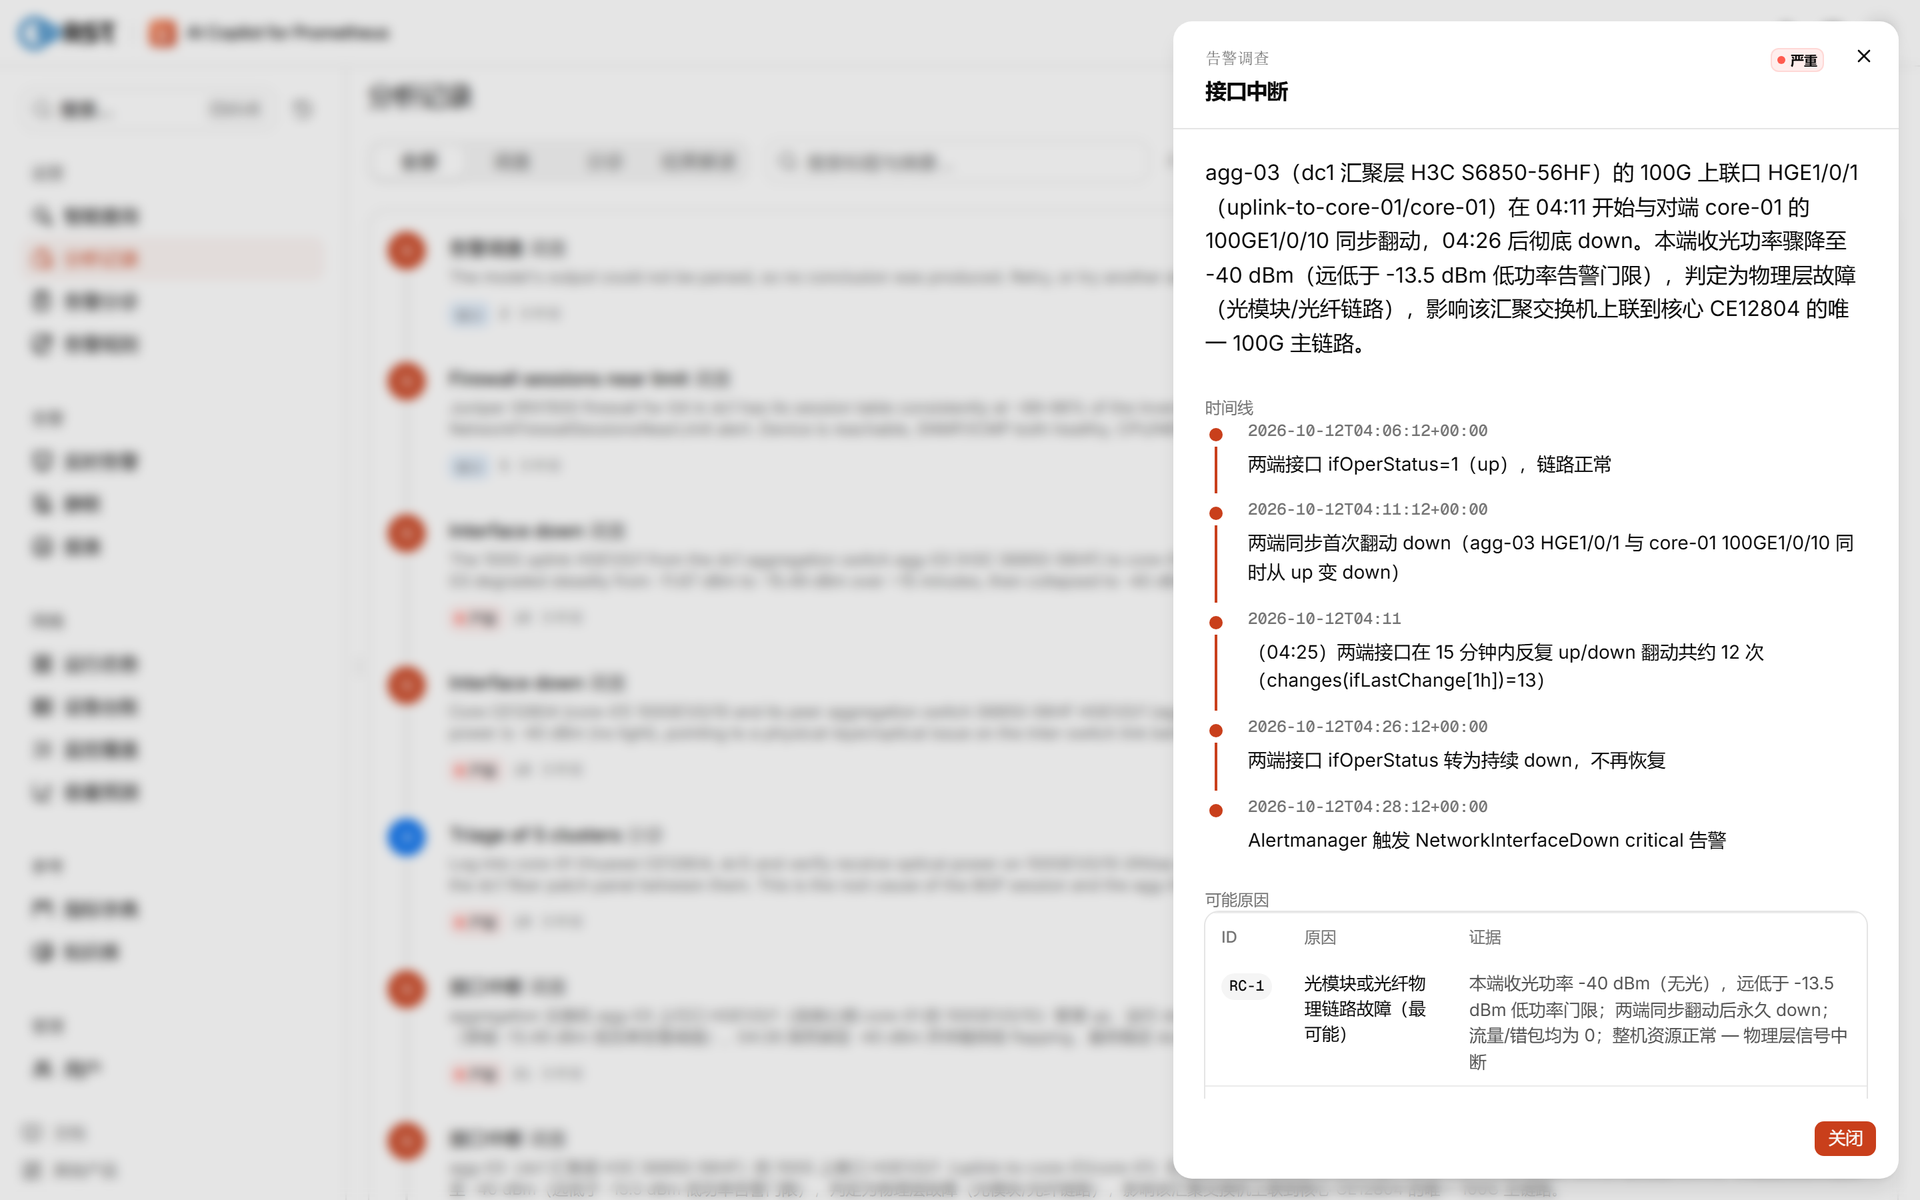
结论(置信度高,非误报):
- 摘要:agg-03 HGE1/0/1 从 04:11(UTC,即本地 12:11)起与对端 core-01 100GE1/0/10 同步翻动,04:26 后持续 down,本端收光 -40 dBm,远低于 -13.5 dBm 预警线,判定为物理层故障。
- 可能原因:RC-1 光模块或光纤链路故障(最可能);RC-2 本端 QSFP28 光模块或端口硬件故障(依据 -35.24 dB/h 斜率);RC-3 对端 CE12804 端口或模块异常;RC-4 跳线或配线架松动。
- 处置建议:两端执行
display transceiver diagnosis检查收发光;先更换 agg-03 侧光模块,再更换对端;仍未恢复则检查跳线和配线架,用光功率计或 OTDR 测量衰耗;临时可将流量切到 uplink-to-core-02。
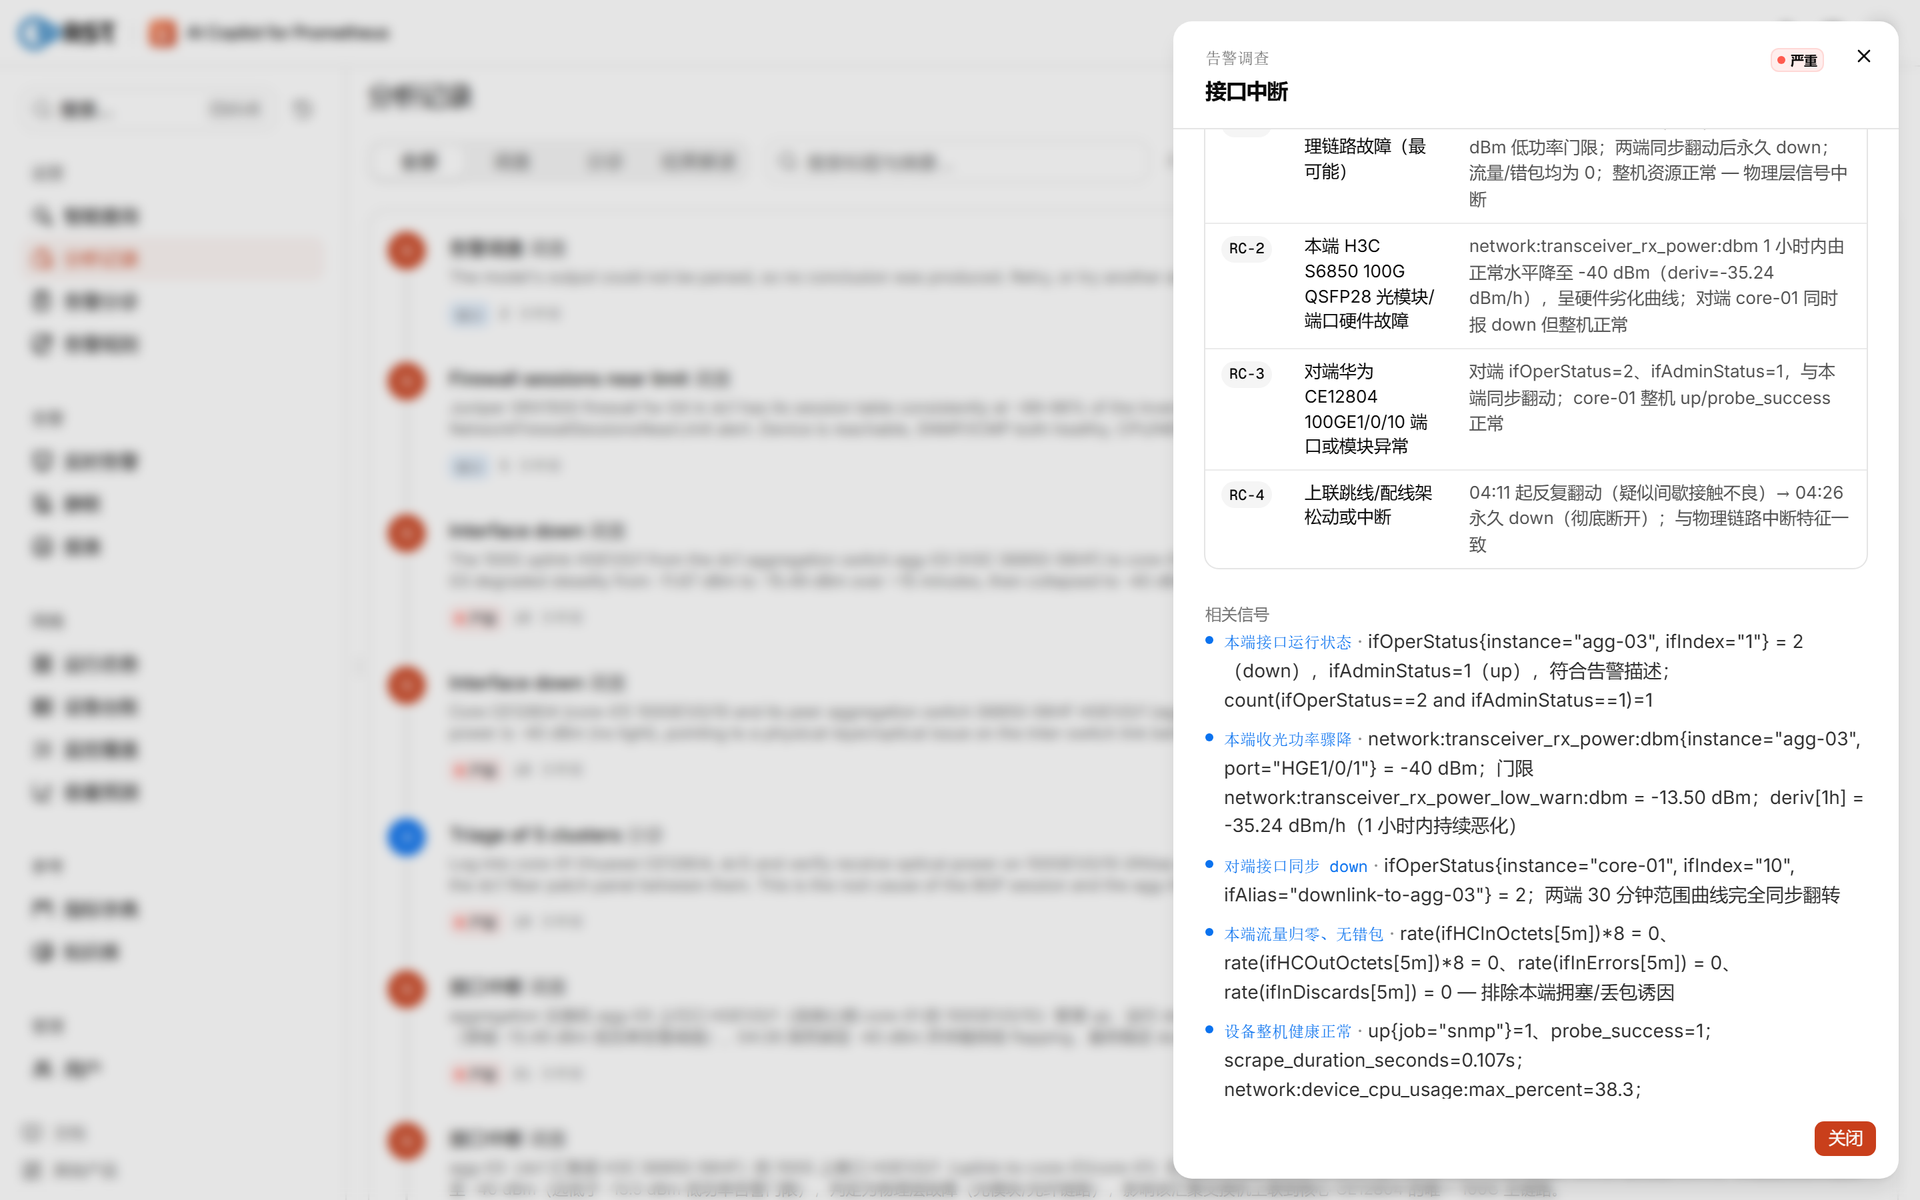
报告末尾列出全部已执行的 PromQL 及返回序列数,每条结论均可回查:
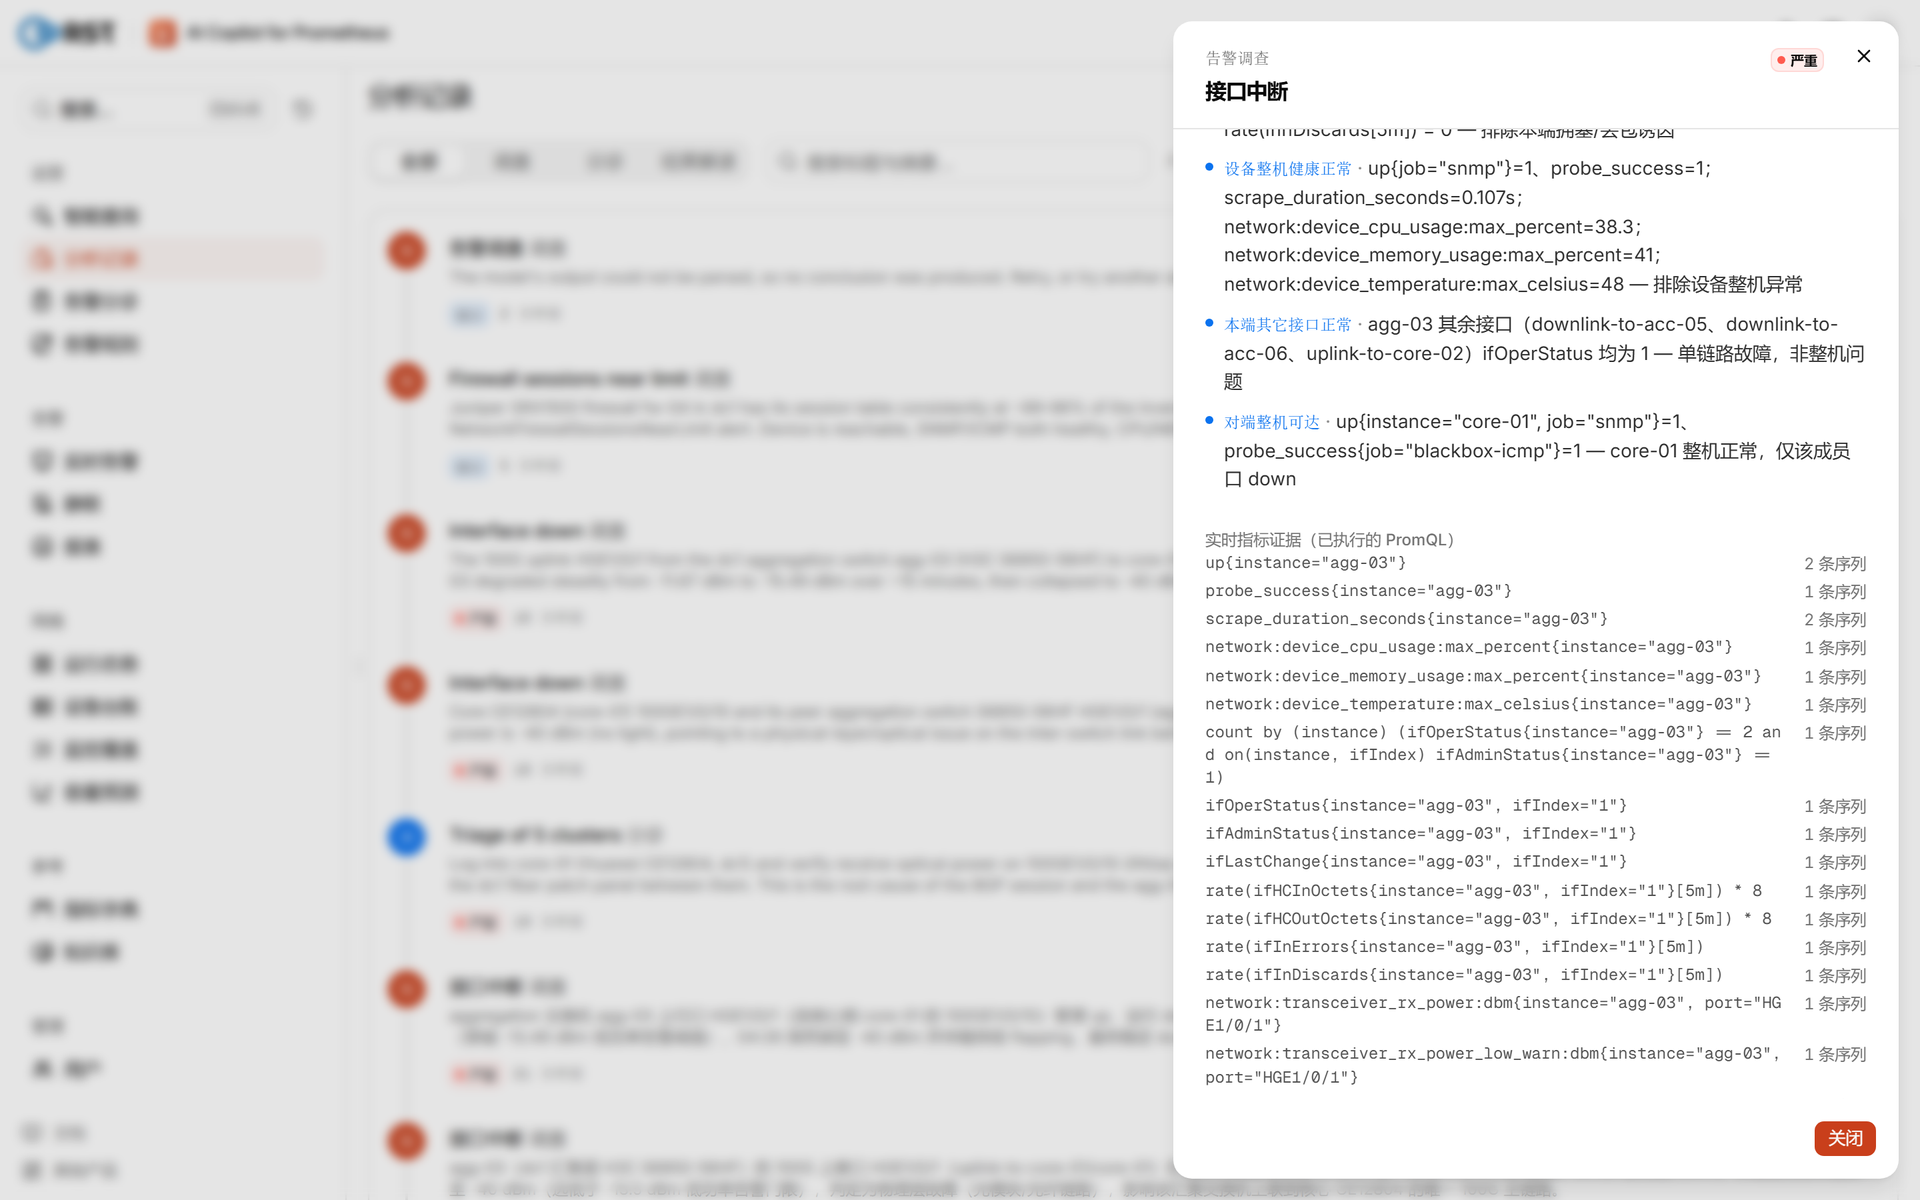
阅读报告时可以结合两点:agg-03 还有一条接 core-02 的上联,处置建议中已给出切换到这条链路的临时方案;-35.24 dB/h 是整小时斜率,包含了最后的失光,前 40 分钟的缓慢下降可以用下文的智能查询单独查看。
core-01 端:53 秒,方向正确但未查对端
core-01 为华为设备,仿真环境未采集其光模块数据,预取的光功率查询为空。模型执行 13 条查询,覆盖两端端口状态、上次变化时间、速率、1 小时内状态变化次数(两端均约 13 次)和设备运行时长,结论为"核心 ↔ 汇聚单链路持续抖动 / 中断",首要原因是光模块或光纤故障,并引用 runbooks/interface_down.md 建议优先检查收光功率。
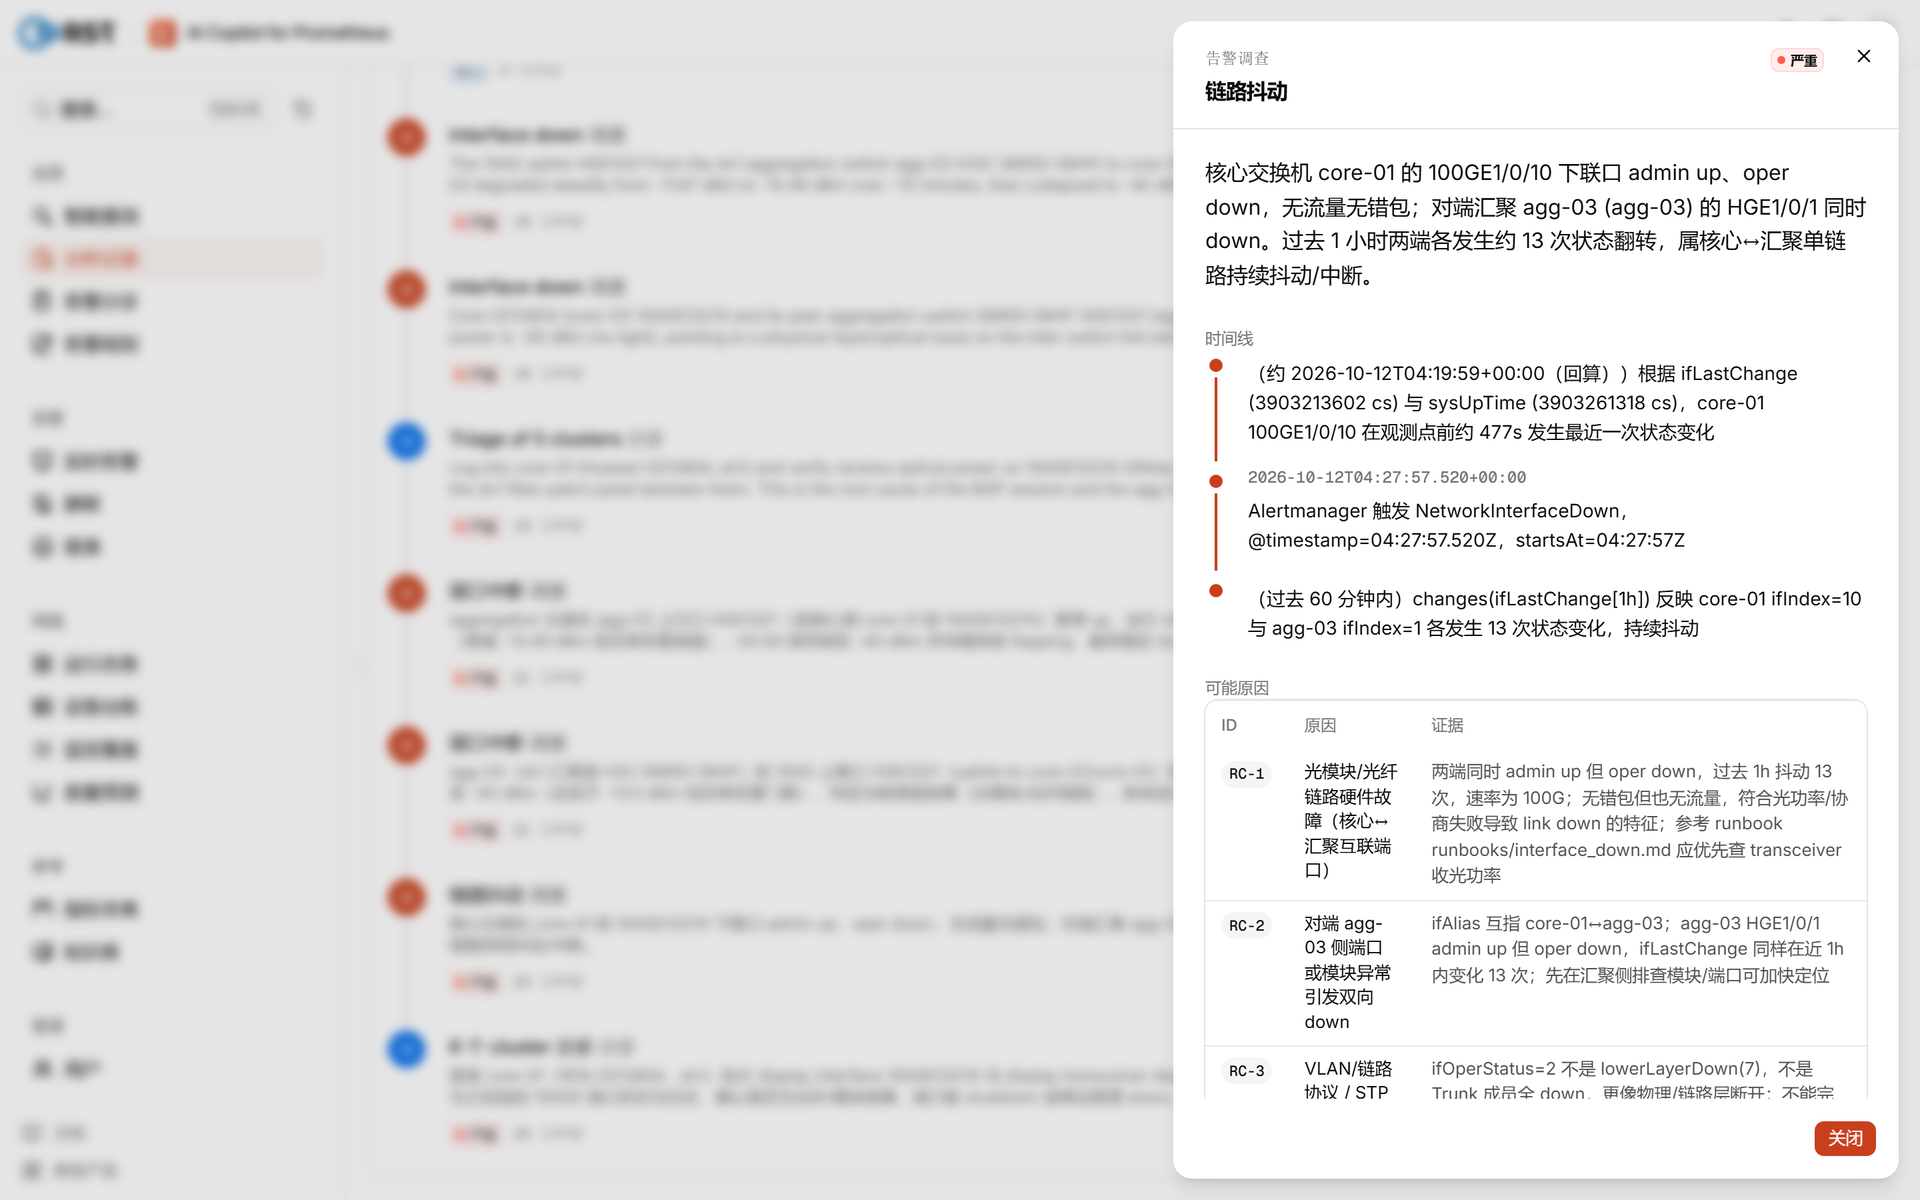
华为侧没有光功率数据,这一端的结论落在"物理层故障,请查光",下一步就是查对端 agg-03 的收光,也就是上面 agg-03 端调查给出的 -40 dBm。英文界面复跑的那一遍里,core-01 端调查直接查询了 agg-03 收光并读到 -40 dBm。实际使用中,同一条链路的告警从两端各发起一次调查,结论可以互相印证。
智能查询:还原无告警的 40 分钟
调查报告说明的是"当前无光"。要看到劣化从何时开始,可在「智能查询」中输入"过去 1 小时 agg-03 各端口收光功率的变化趋势"。25 秒后,产品生成 network:transceiver_rx_power:dbm{instance="agg-03"},返回 4 条序列:HGE1/0/1 从 11:38 起持续下降,12:25 前后跌至 -40,其余三个端口平稳。
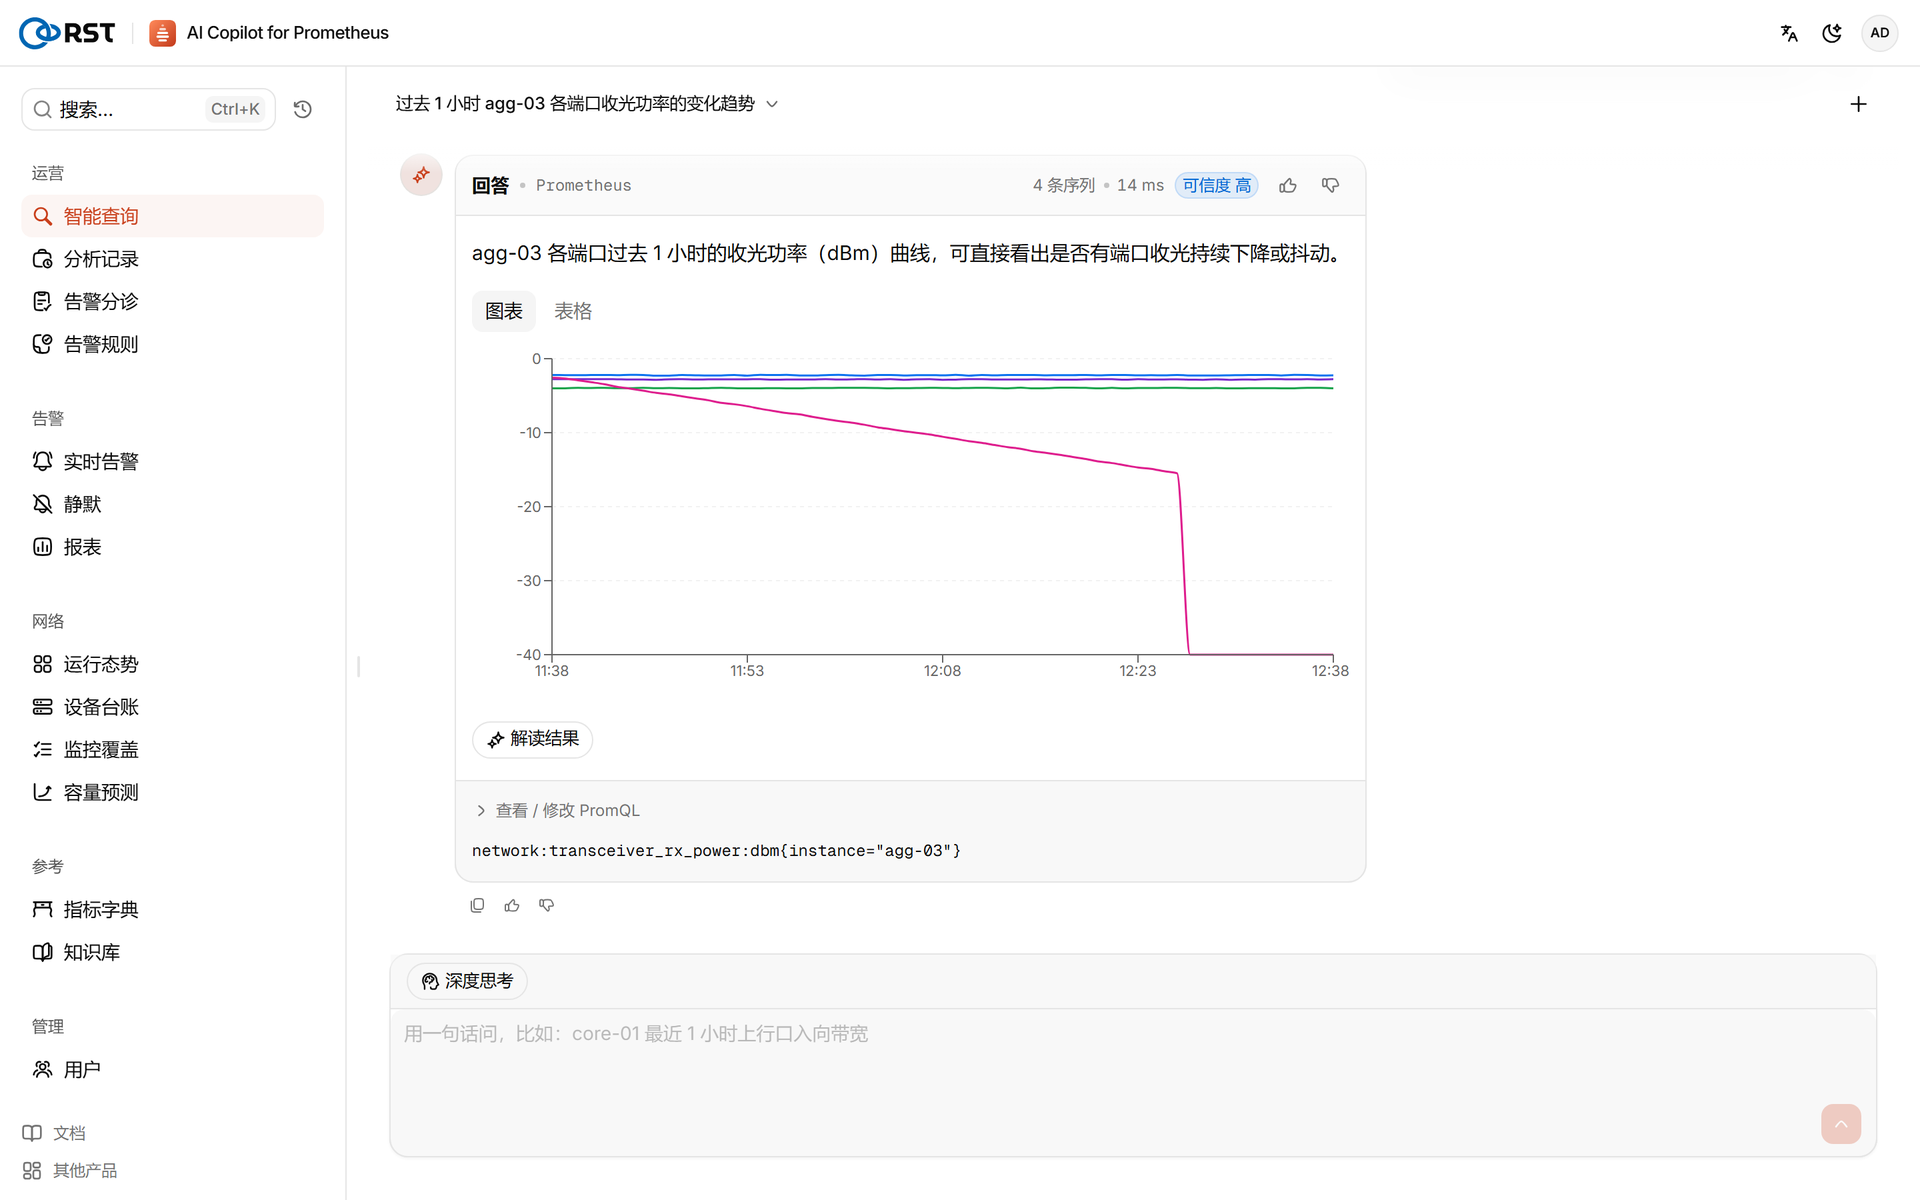
这正是双线表第一行那段无告警的劣化过程,工程师无需记住指标名或手写 instance、port 标签。
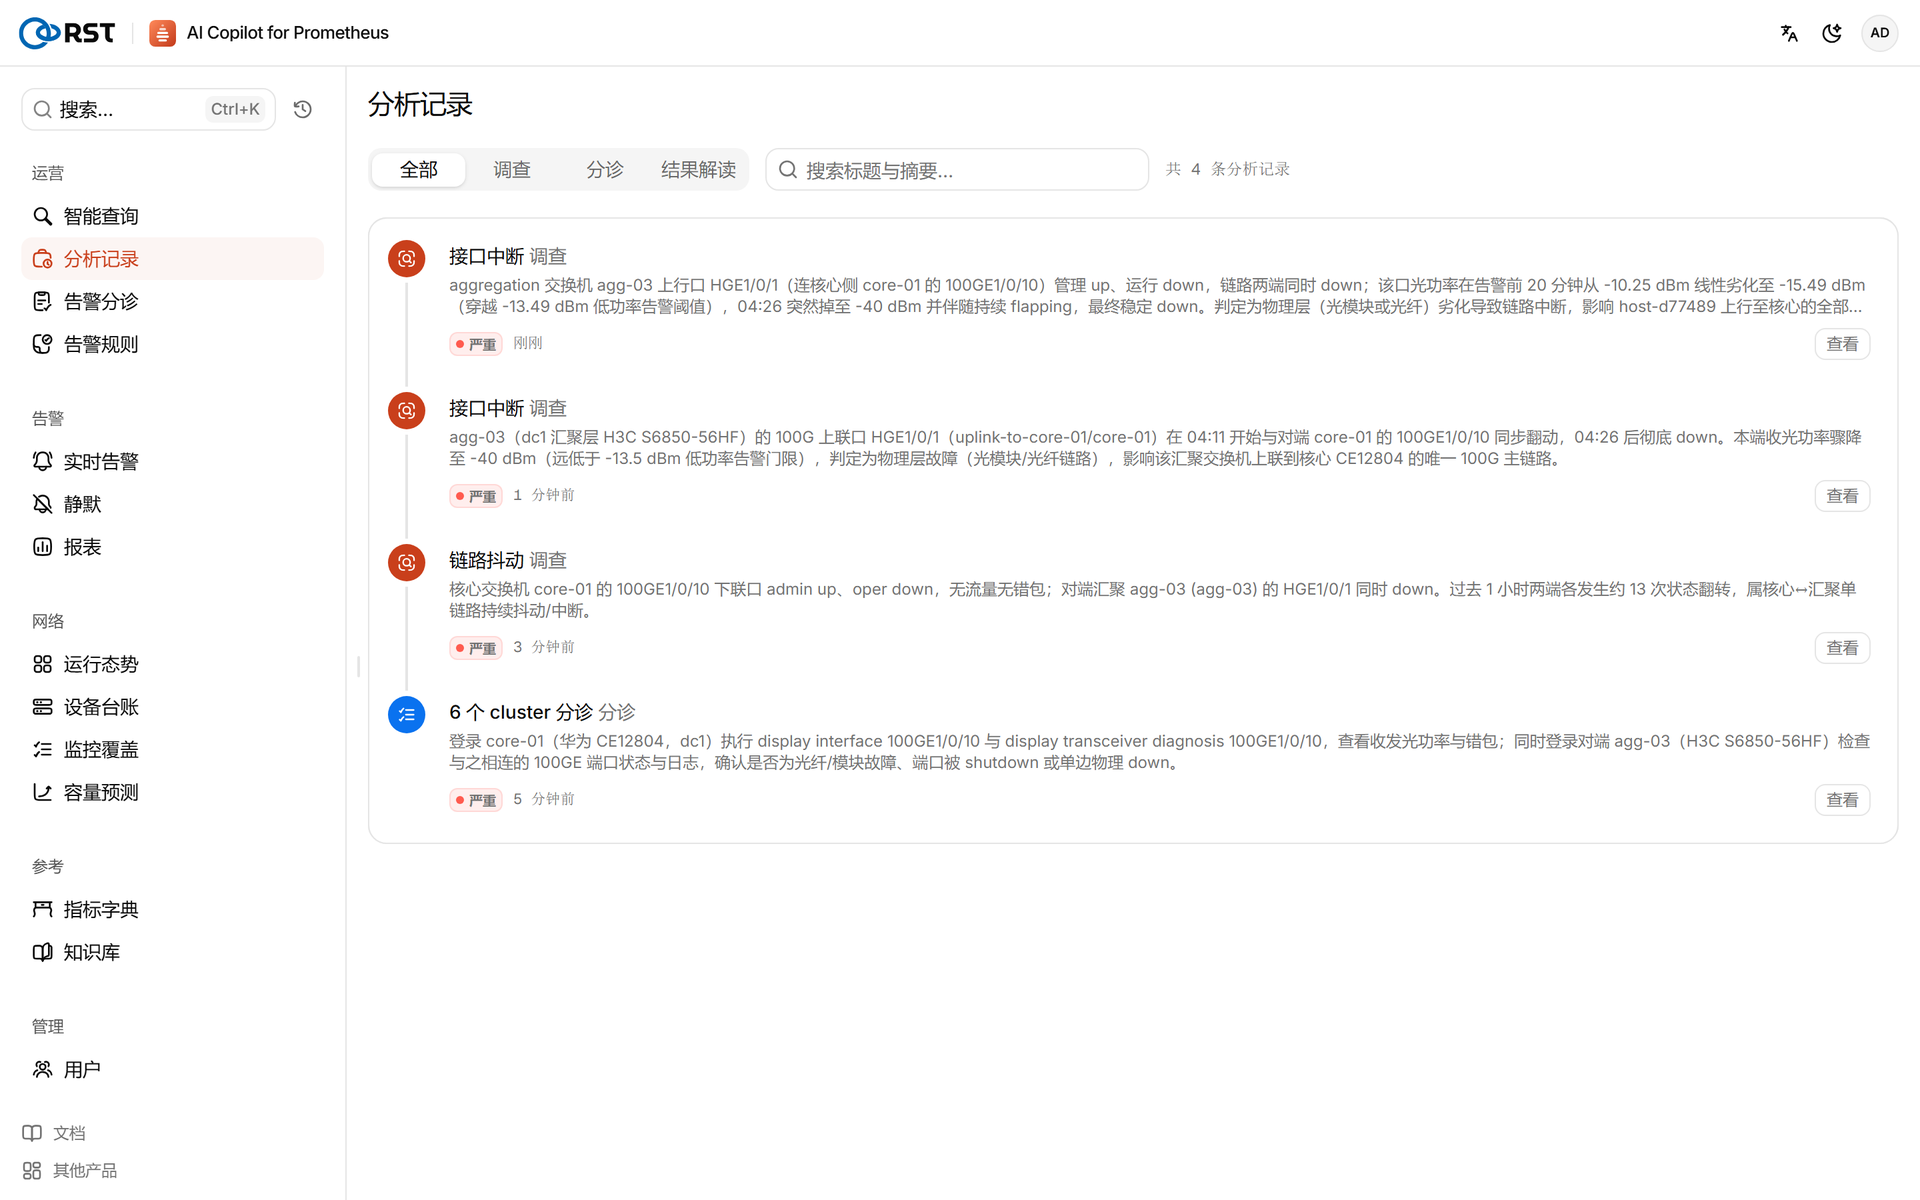
所有分诊和调查都归档在「分析记录」中,可回看复核。本文的调查报告截图均取自这里。
五、护栏
让模型自行编写 PromQL,需要防止查询过量、越界访问和内网信息外泄。本次调查受以下机制约束:
- 只读与校验:每条 PromQL 先经 Prometheus 校验语法,再通过查询接口(
/api/v1/query、query_range)执行,不调用任何写接口;可配置指标白名单。产品的写操作只有两类:工程师手动创建的 Alertmanager 静默,以及经审批后写入的自管规则文件(可回滚)。本次中文两端的 23 条查询全部通过校验。英文界面复跑时,模型写错过一条(将ifAlias=~"…"写成独立表达式),被校验拒绝,下一轮改写后返回 94 条序列。 - 返回上限与脱敏:每次查询最多向模型返回 20 条序列;主机名、IP 等标签替换为占位符后才进入提示词,结论返回时再还原。模型使用脱敏后的 IP 作为查询条件会被拦截。
- 预算:每次调查最多 4 轮模型调用、120 秒,可另设 token 预算;超限返回降级结果并明确标注。本次两端均在 1 分钟内完成,无降级。
- 证据留存:报告列出每条已执行的 PromQL 及返回序列数,每条可能原因注明依据。工程师可以逐条对照,确认结论的依据。
六、价值与结论
网络运维的主要人力成本在告警之后:读懂首屏告警、判断关联、逐条排查。这个过程慢、因人而异,且依赖资深工程师。
更快:16 条告警的排序和处置建议 30 秒完成;从接口中断查到光模块无光 45 秒。
可复现、可审计:端口状态、流量错包、光功率与斜率、BGP 对端等预取查询每次调查都会执行,所有查询和结果留存在分析记录中。
降低经验门槛:"接口中断先查光功率,再查对端和斜率"原本依赖资深工程师的经验;现在一线工程师点击「深入调查」即可得到这些结果,查看趋势只需一句自然语言。
| 环节 | 人工 | RST AI Copilot for Prometheus |
|---|---|---|
| 排优先级 | Alertmanager 不排序,凭经验逐条查看 | 30 秒聚为 6 簇并排序,标出派生告警 |
| 关联分析 | 人工比对 BGP、带宽、接口告警的设备和时间 | 同一链路两端自动聚类,建议中说明因果 |
| 根因定位 | 手写十几条 PromQL 查端口、光功率、对端 | 预取加自主检索,45 秒查到 -40 dBm 无光 |
| 趋势分析 | 需熟悉指标名和标签,手写 deriv | 一句自然语言,25 秒出曲线 |
| 数据安全 | — | 只读查询、语法校验、返回上限、标签脱敏 |
本次实跑中,Prometheus 和 Alertmanager 覆盖了所有可告警的环节;RST AI Copilot for Prometheus 30 秒完成 16 条告警的排序并识别派生告警,45 秒将排第一的接口中断定位到"agg-03 HGE1/0/1 收光 -40 dBm,光模块或光纤故障",并用一句自然语言还原了前 40 分钟的劣化曲线。
每条结论都附带实际执行过的查询和返回结果,工程师可以对照证据复核后再动手。产品不自动处置,更换光模块、切换流量等决定仍由人做出。告警交给 Prometheus,研判交给 RST AI Copilot for Prometheus,决策留给人。