

网络
运行态势总览、设备台账与接口告警口径、监控覆盖基线,以及接口抖动与告警降噪。
侧栏 网络 组有四个页面:运行态势、设备台账、监控覆盖和容量预测。
运行态势
运行态势 一屏总览网络当前的状况。
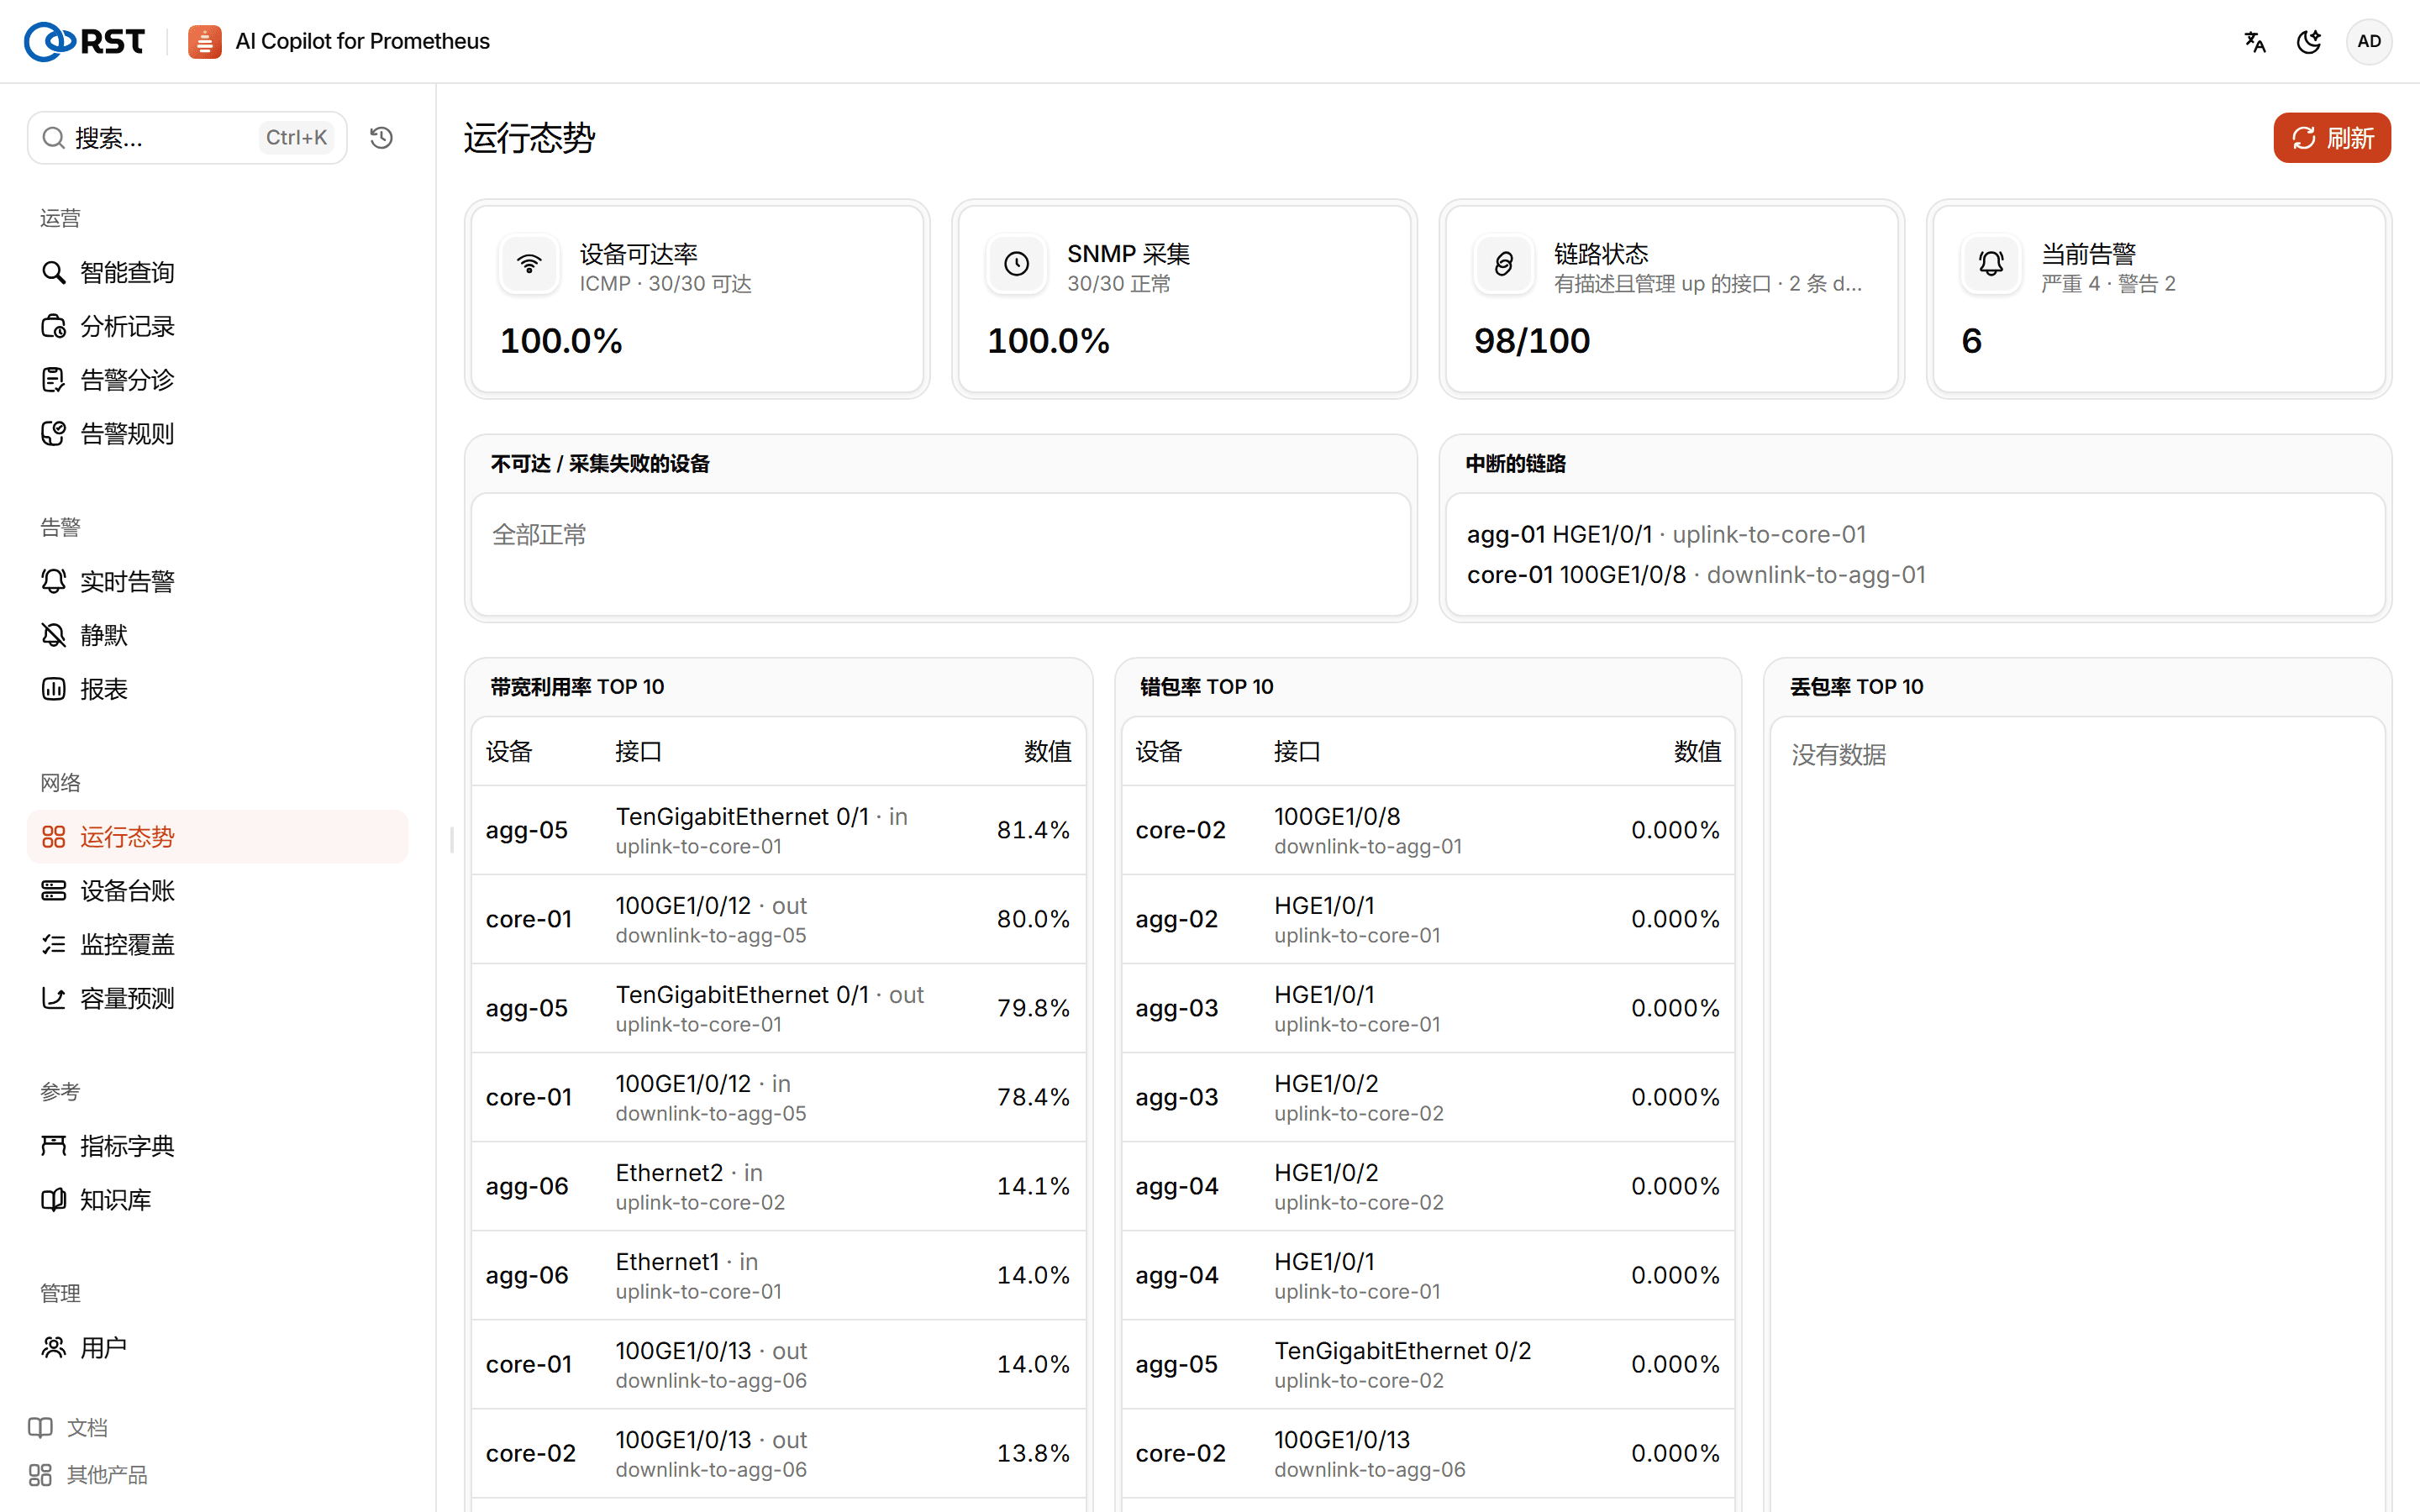
| 区块 | 内容 |
|---|---|
| 设备可达率 | ICMP 探测可达的设备数 |
| SNMP 采集 | 采集正常的设备数 |
| 链路状态 | 有描述且管理 up 的接口中 down 的条数 |
| 当前告警 | 严重和警告告警数 |
| MTTA、MTTR | 选定时间窗内的平均确认时间和平均恢复时间 |
| TOP 10 | 带宽利用率最高、丢包率最高的接口 |
| 异常清单 | 中断的链路,不可达或采集失败的设备,告警最多的规则 |
抖动与降噪
需要专业版许可。识别接口抖动(状态变化次数和对端),给出两类建议:
- 重复告警合并:同一告警在同一台设备上出现多条,或同时出现在多台设备上(可能是同一个上游原因)时,建议 Alertmanager 的
group_by。 - 抑制规则:例如设备不可达时抑制该设备上的其他告警,接口 down 时抑制同一接口的抖动、错包和丢包告警。建议可以直接贴进 Alertmanager 配置,页面显示是否已配置以及当前可抑制的告警数。
设备台账
设备台账 是设备和接口的清单,也是网络规则包判断告警口径的依据。
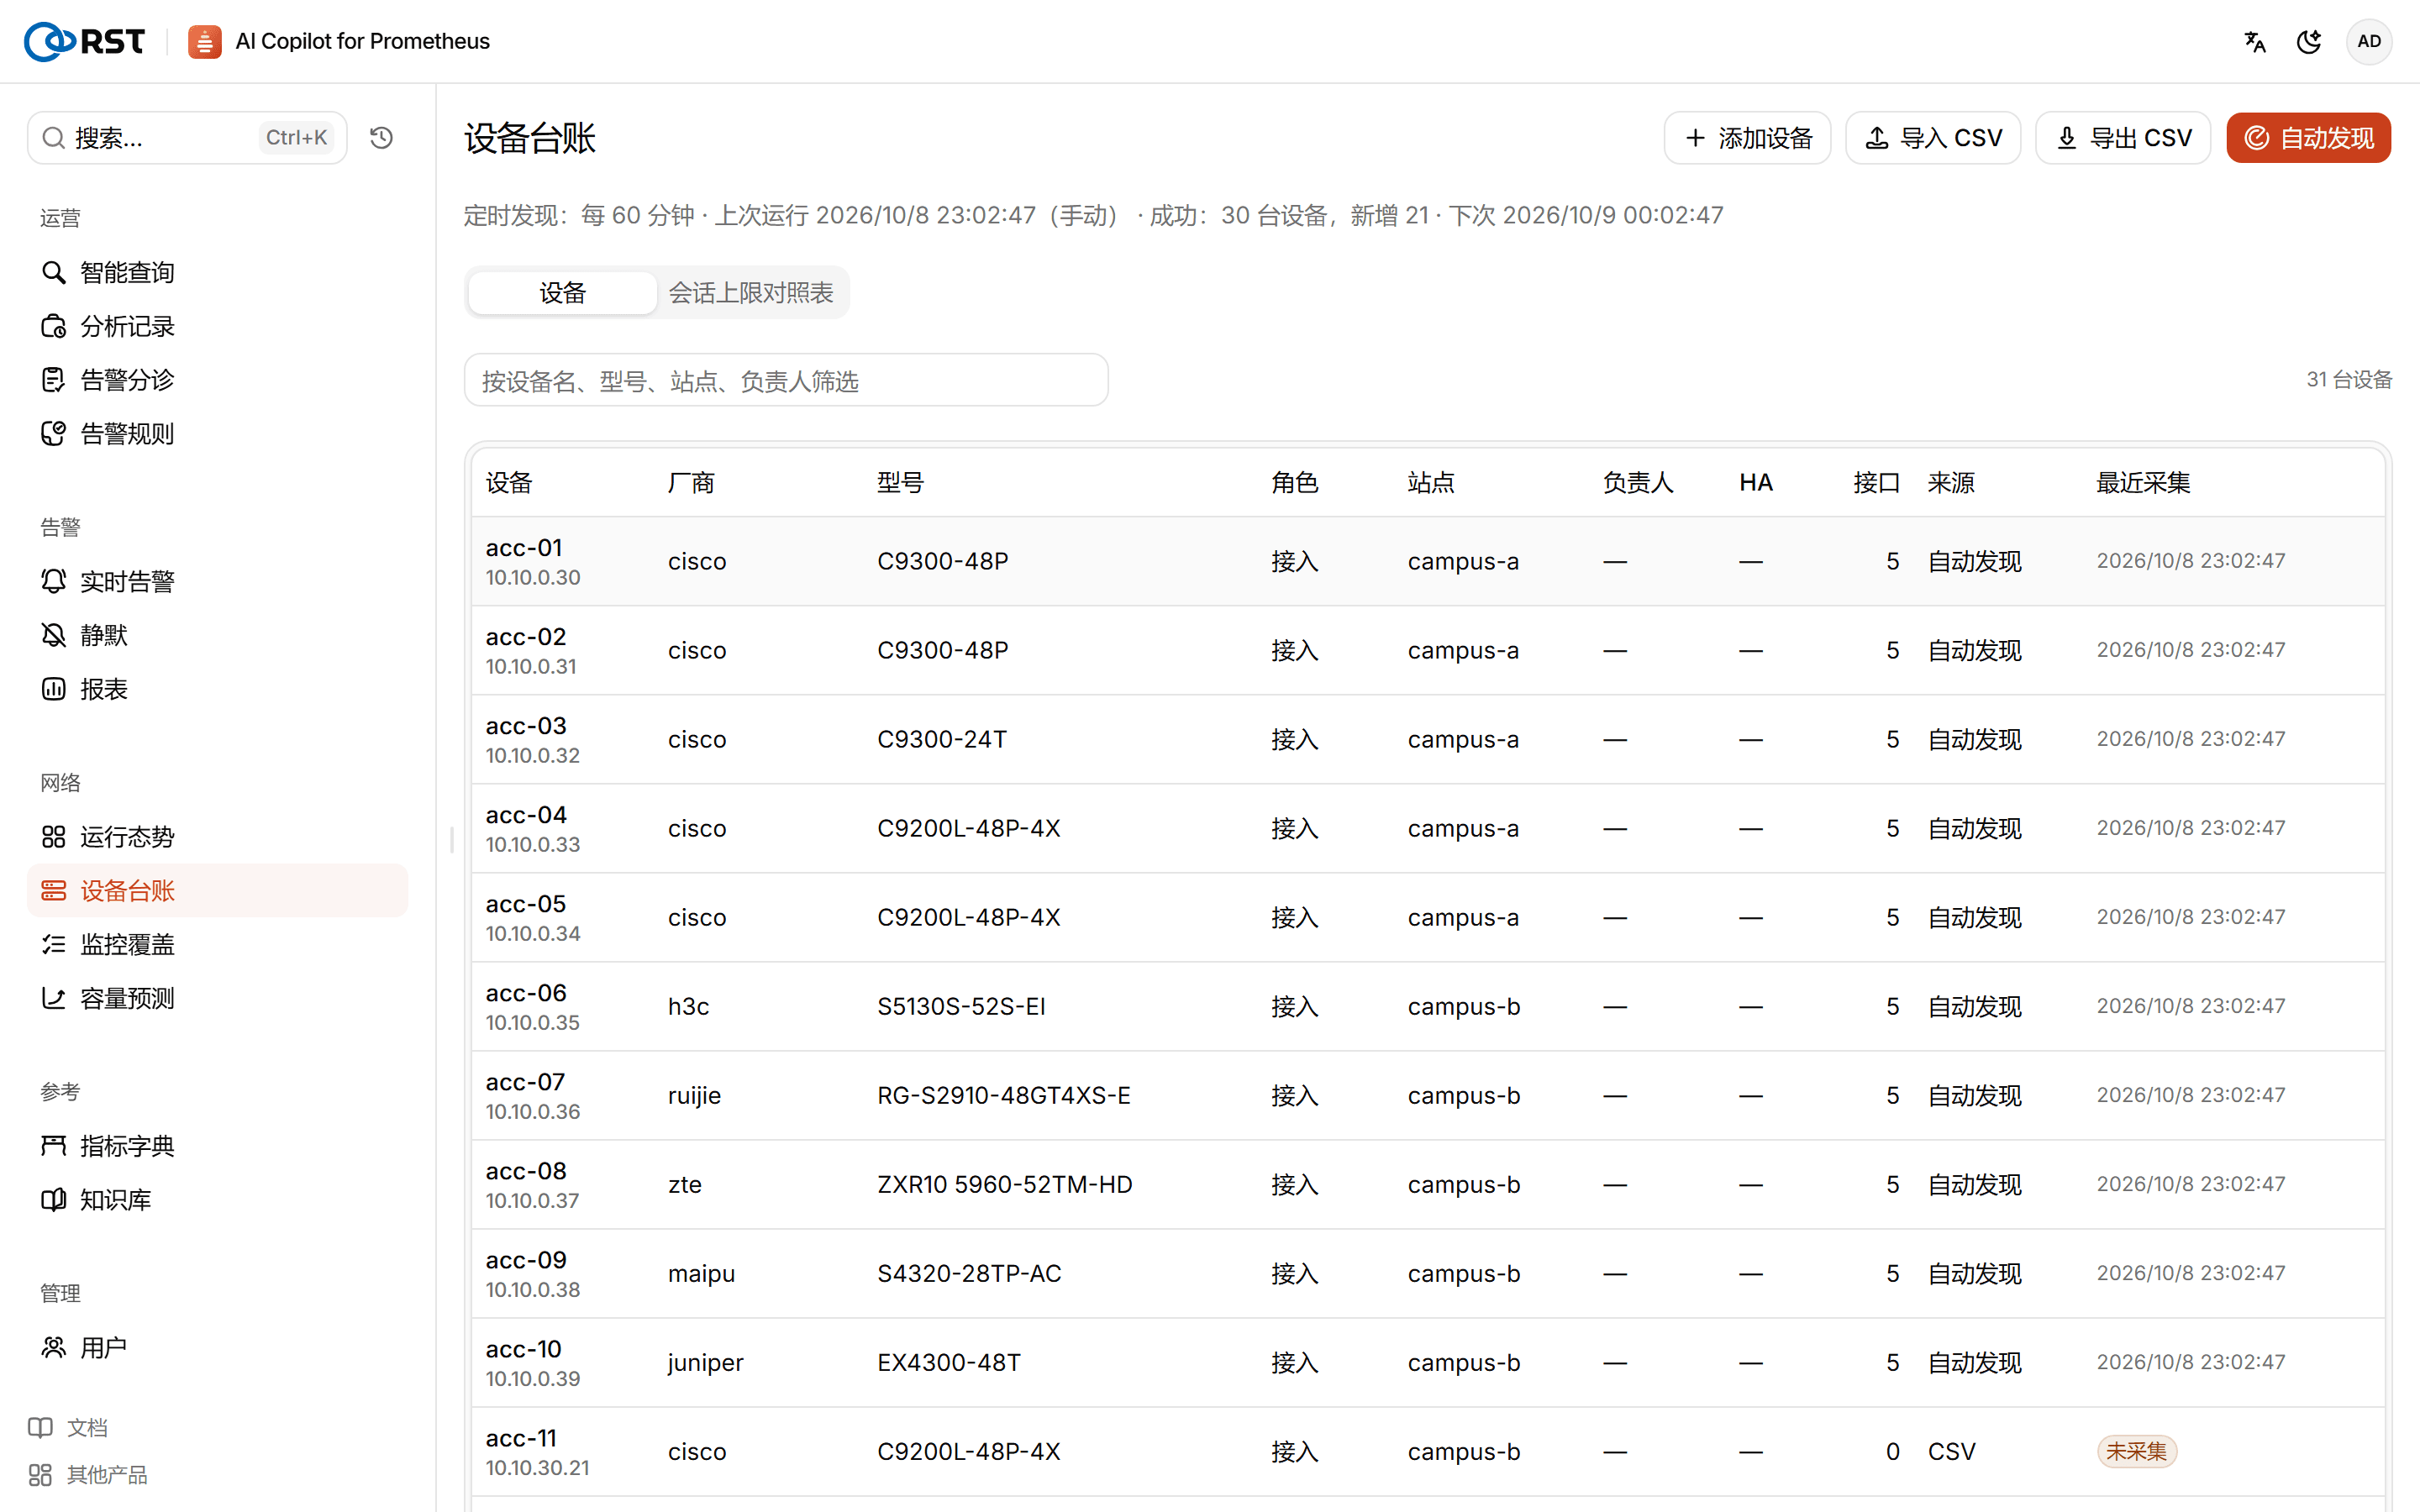
- 自动发现:从 Prometheus 的采集目标和 SNMP 指标中发现设备和接口,按
sysObjectID识别厂商。默认每小时定时运行一次,也可以手动运行。识别结果与采集标签不一致、或取不到sysObjectID的设备会单独列出。 - 导入 CSV、导出 CSV、添加设备:手工维护设备名、管理 IP、厂商、型号、角色、站点、机柜、负责人和是否配置 HA。手工改过的字段,自动发现不再覆盖。
- 接口告警口径:每个接口可以设为默认、关键或忽略。默认:只有写了描述的接口 down 才告警;关键:没有描述也告警;忽略:该接口的 down、抖动、带宽和错包告警都不报。
- 会话上限对照表:防火墙型号对应的会话上限,预置值来自厂商规格,请核对。
- 只有标记了已配置 HA 的设备才报 HA 单元异常。
台账通过 /metrics/inventory 导出给 Prometheus,规则包依赖这些指标,见数据源准备。
监控覆盖
监控覆盖 对照台账、采集目标和已加载的告警规则,找出监控的缺口。点 重新检查 刷新。
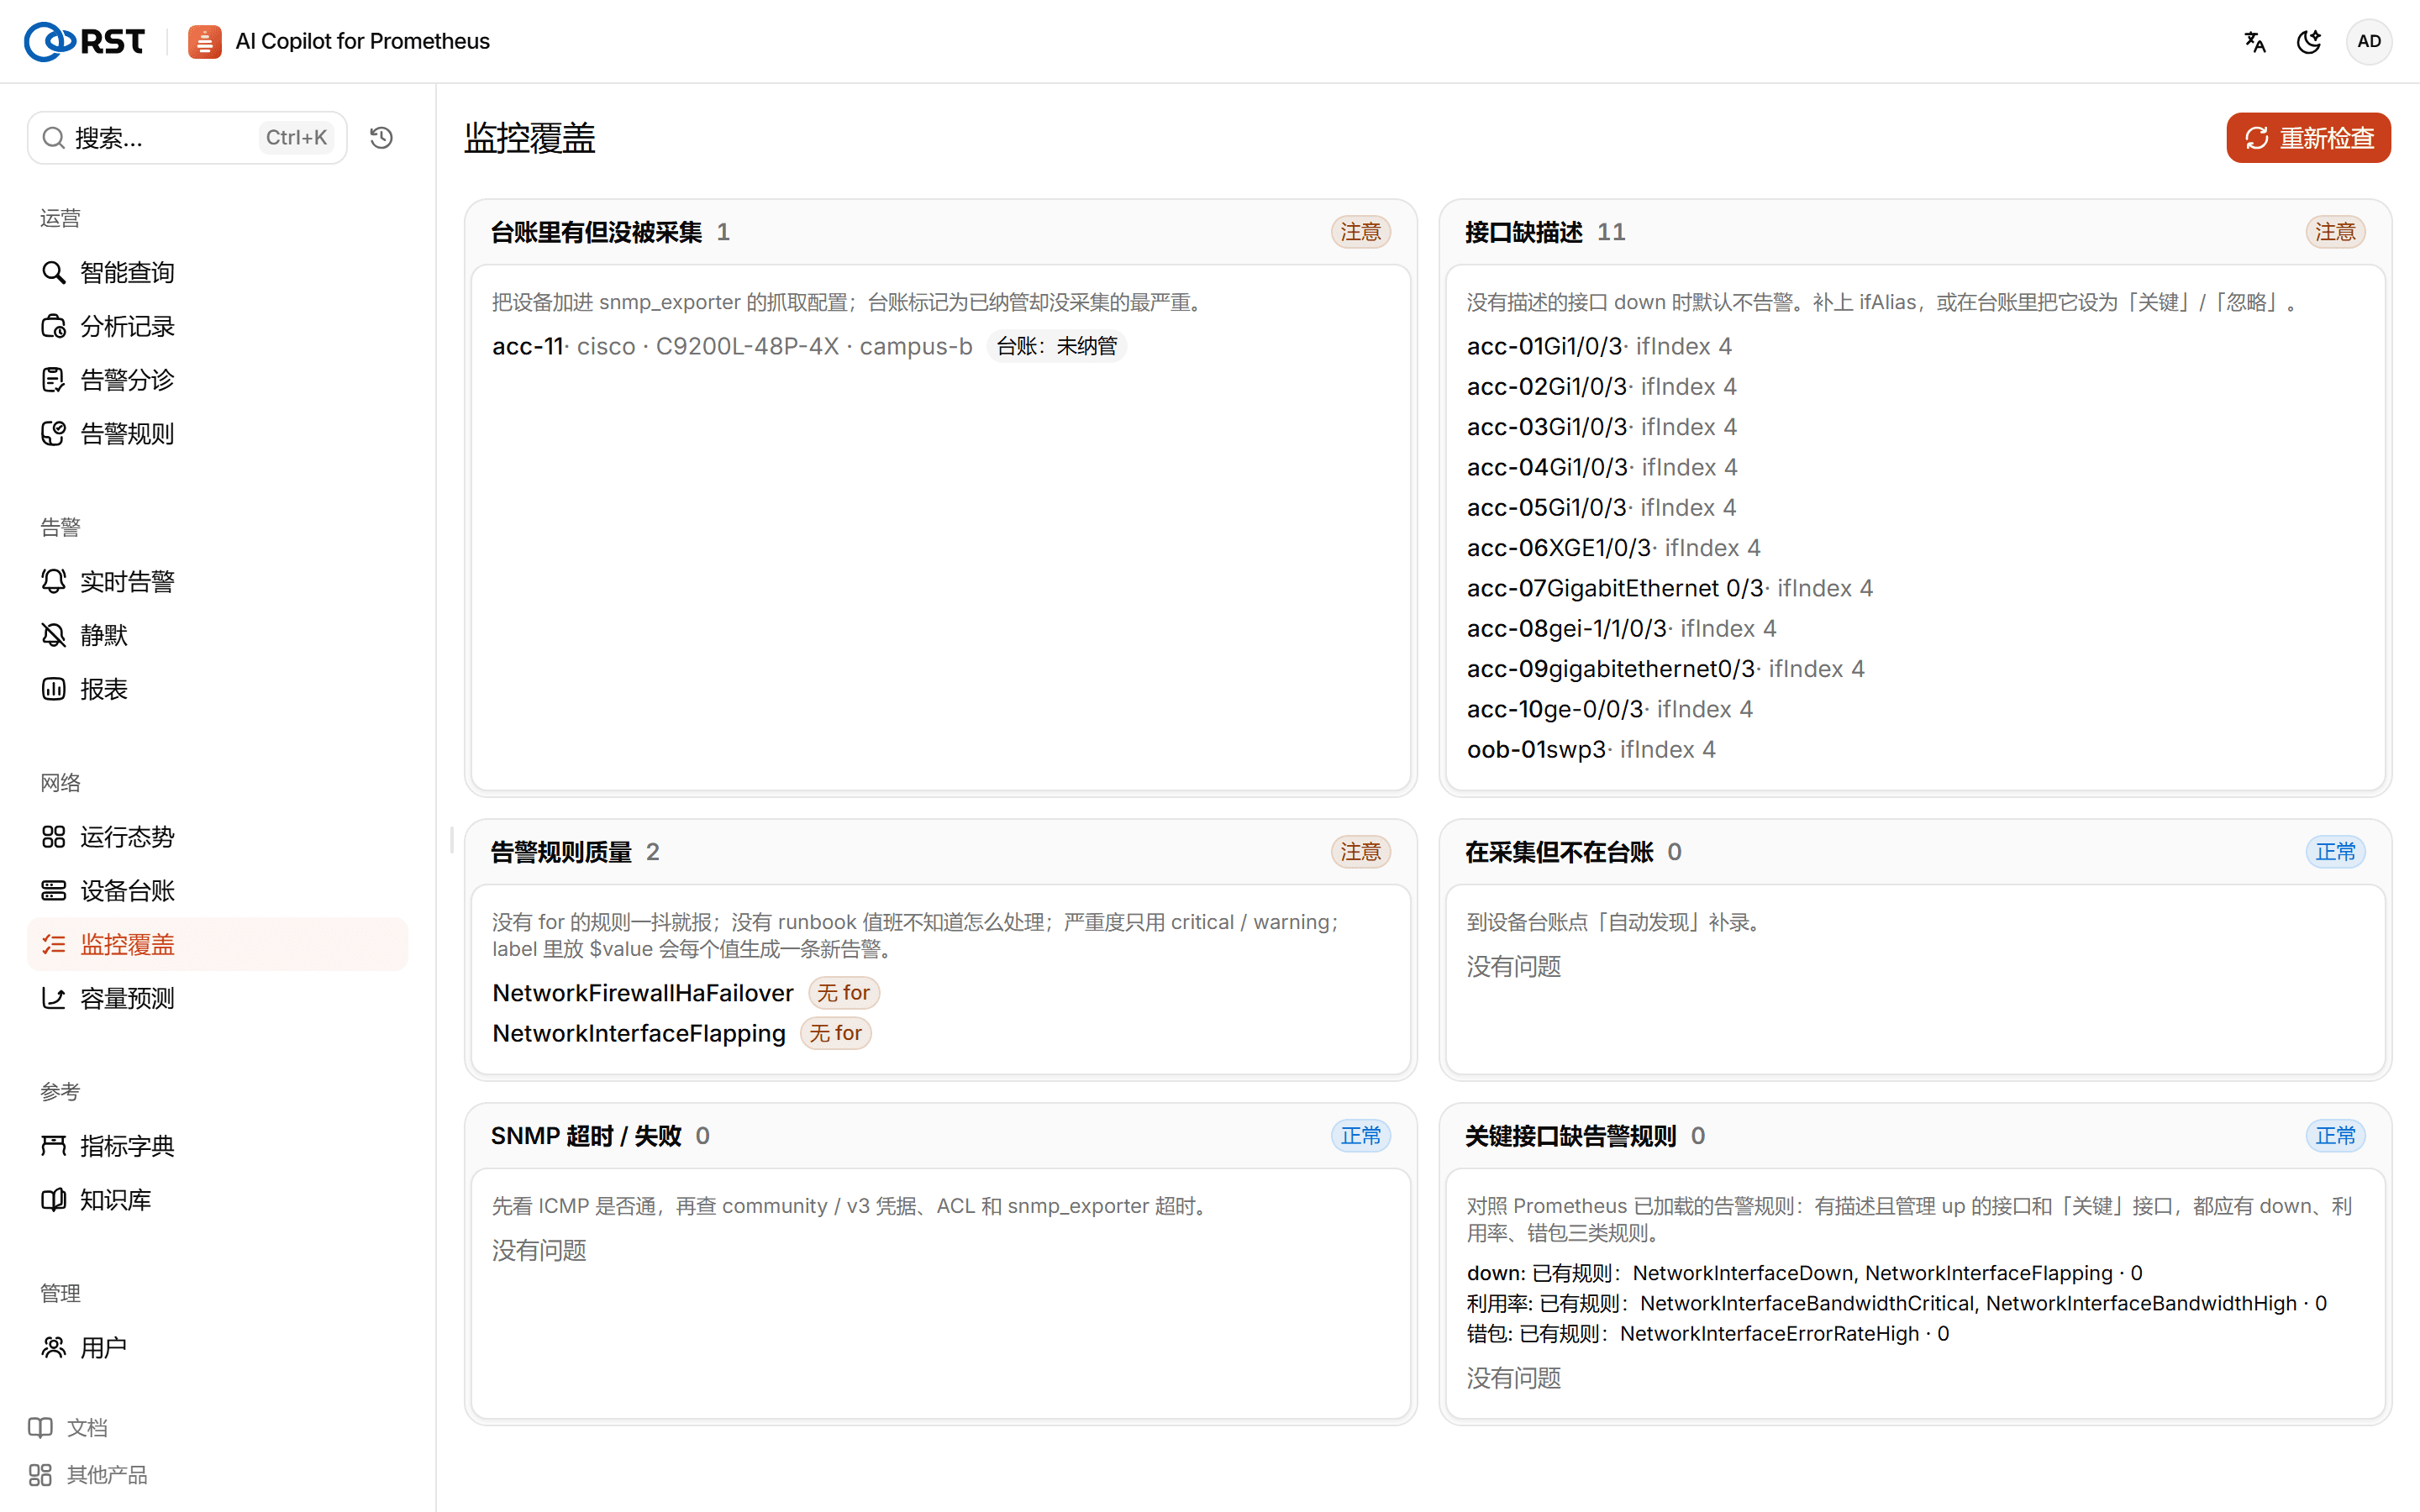
| 检查项 | 处理 |
|---|---|
| 台账里有但没被采集 | 把设备加进 snmp_exporter 的抓取配置。台账标记为已纳管却没有采集的最严重 |
| 在采集但不在台账 | 到设备台账运行自动发现补录 |
| 接口缺描述 | 没有描述的接口 down 时默认不告警。补上 ifAlias,或在台账中把接口设为关键或忽略 |
| 关键接口缺告警规则 | 有描述且管理 up 的接口和关键接口,都应有 down、利用率等告警规则 |
| 告警规则质量 | 没有 for 的规则一抖就报;没有 runbook 值班不知道怎么处理;严重度不是 critical 或 warning;标签中含 $value 会造成高基数 |