

字段字典
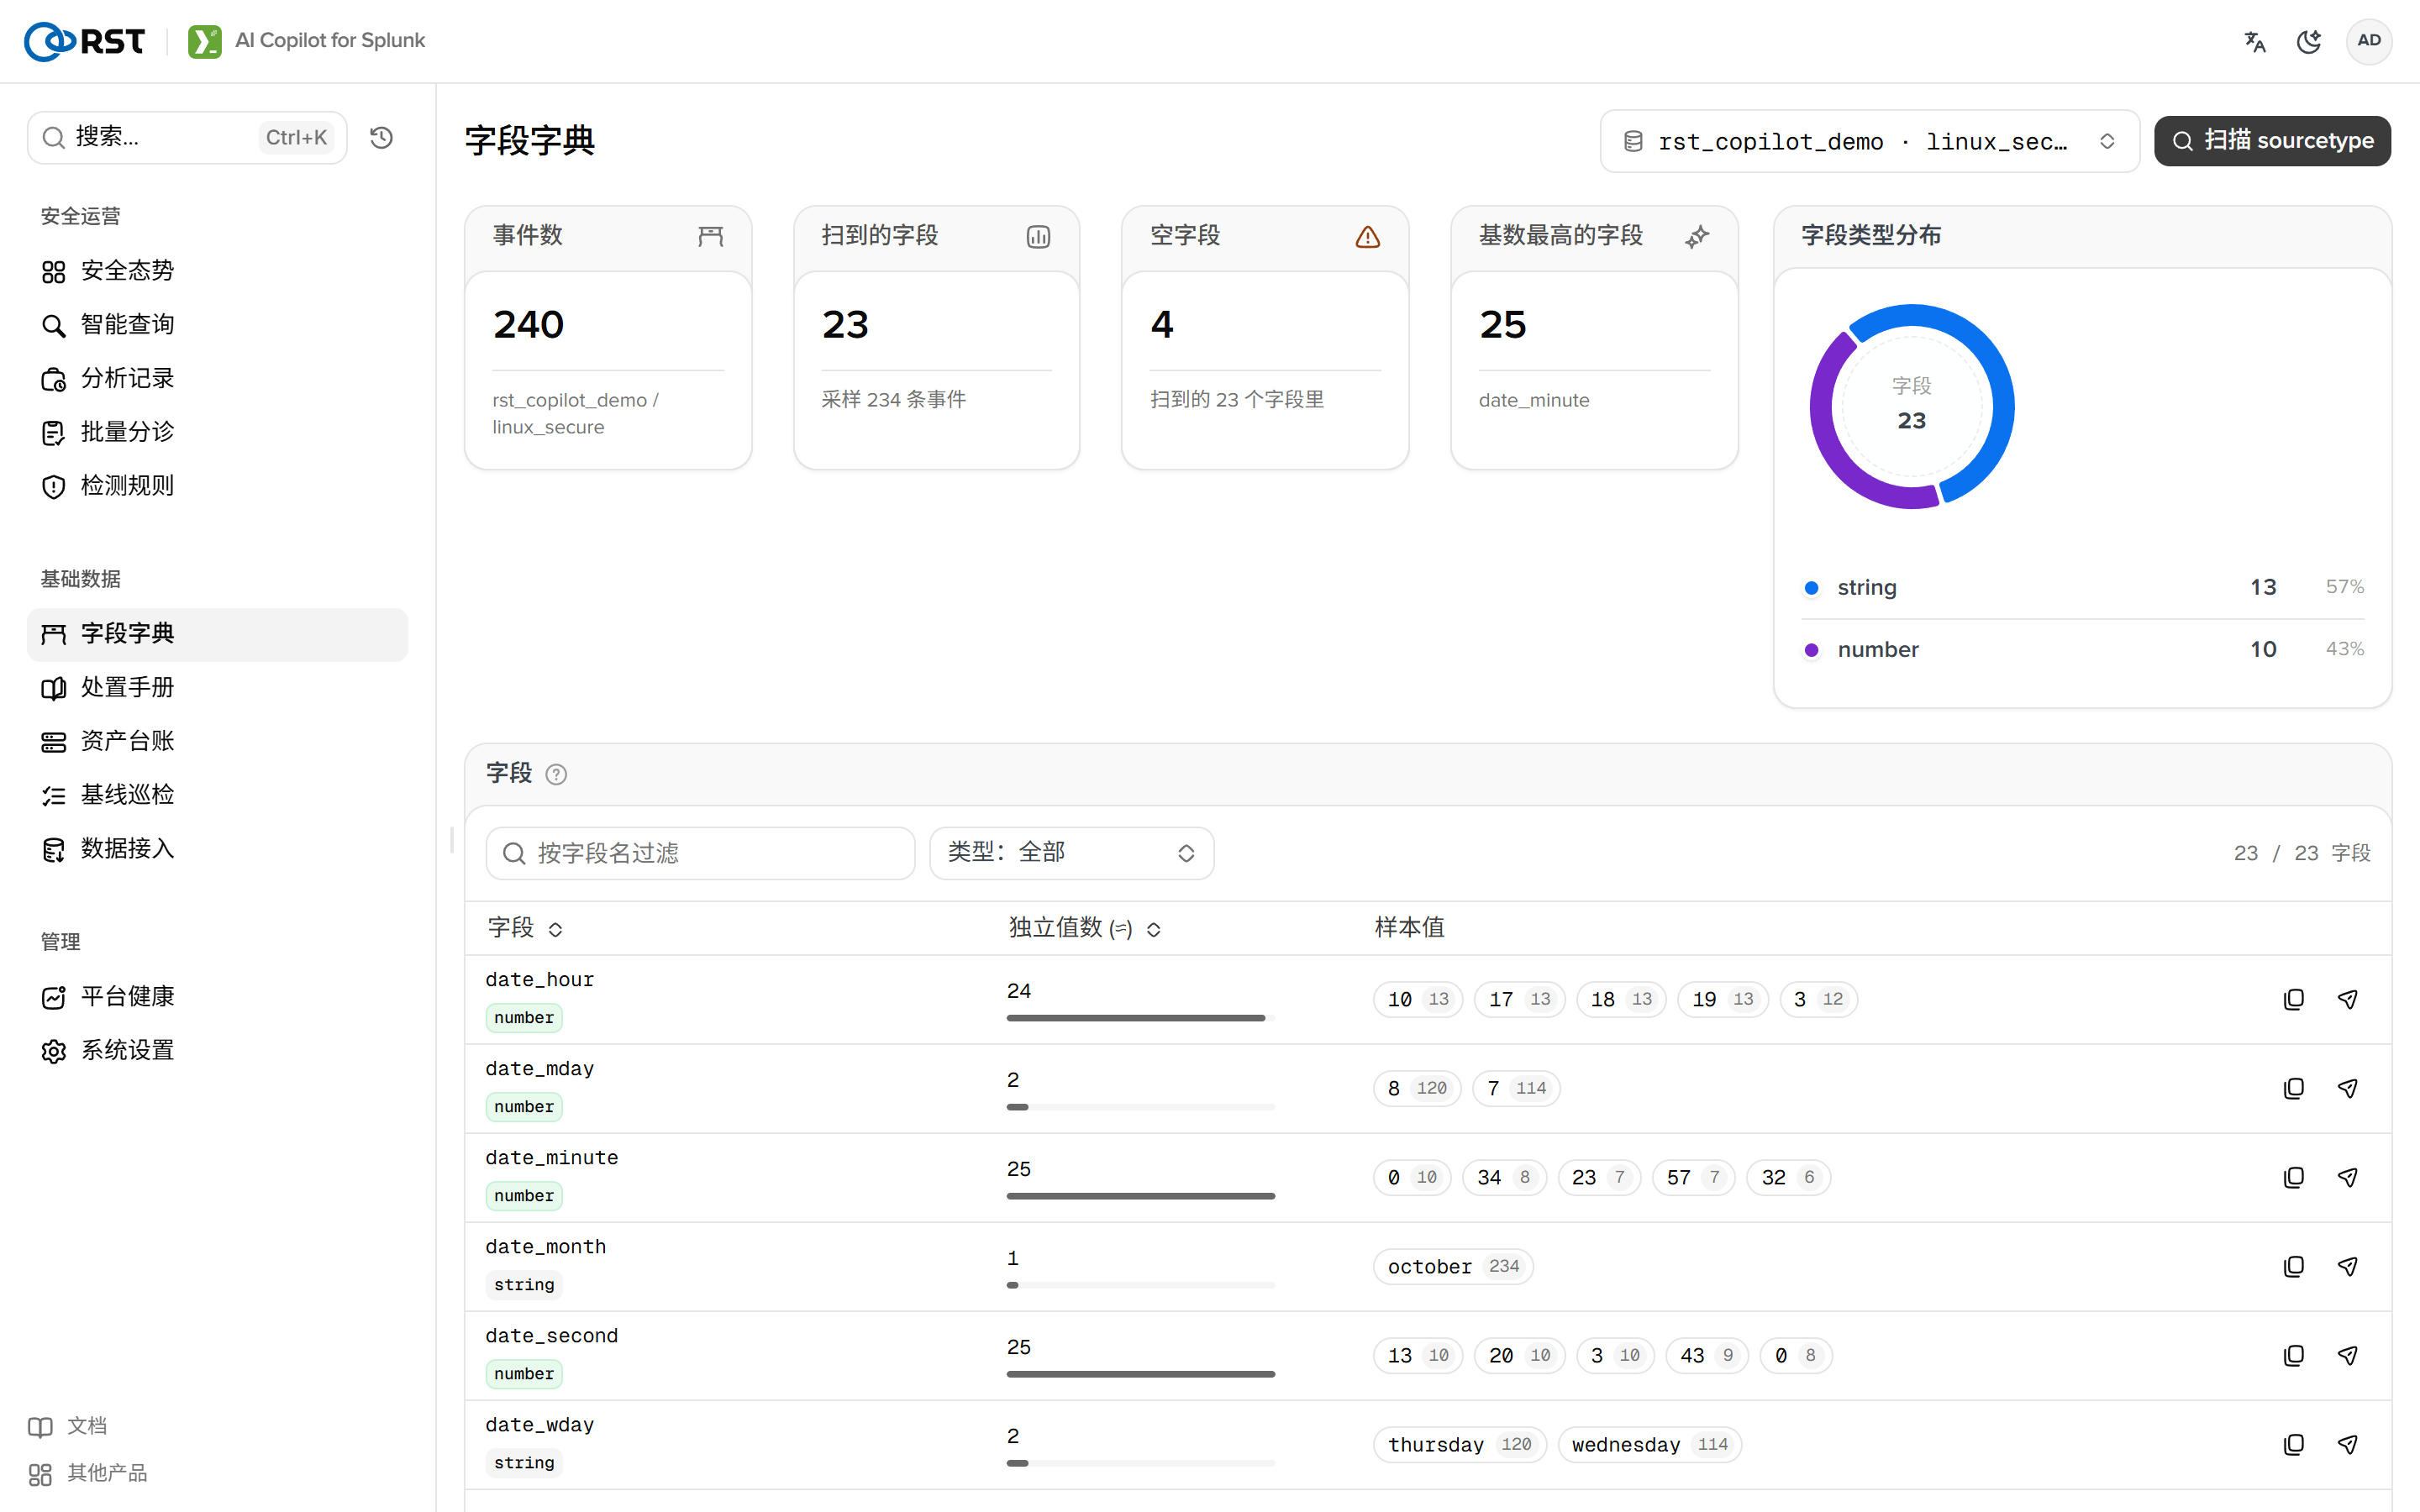
index、sourcetype、字段三级下钻,显示覆盖率、类型、样例值。数据来自 Splunk 的实时元数据。
字段字典列出一个 sourcetype 实际包含的字段和取值样本。模型生成 SPL 时读取同一份数据(agentic 的 get_fields 工具)。所有版本可用。
三级选择
| 级 | 来源 |
|---|---|
| index | | eventcount summarize=false index=*,按白名单过滤 |
| sourcetype | | metadata type=sourcetypes index=<index>,带事件数与最近时间 |
| 字段 | | fieldsummary(近 24 小时,最多 500 条采样);tstats 补充索引时字段 |
选到 sourcetype 后显示四格(事件数、字段数、覆盖率不低于 90% 的字段数、类型分布)和字段表。
字段表
| 列 | 说明 |
|---|---|
| 字段 | 名称,选中复制 |
| 类型 | number、ip、time、string,从 fieldsummary 的数值计数与样例推断 |
| 覆盖率 | 采样事件中包含该字段的比例 |
| 去重数 | distinct count |
| 样例 | Top 值与计数,按当前脱敏档位处理 |
空字段在 Splunk 上几乎恒为 0:fieldsummary 只列出出现过的字段。样例限近 24 小时,与 Elastic 版基于 mapping 的粒度不同;超出范围的数据在智能查询中提问。
用途
| 场景 | 说明 |
|---|---|
| 提问前 | 确认字段名(src 还是 src_ip),避免模型猜测 |
| 数据接入之后 | 写入 props.conf 后回到本页确认新字段是否抽取 |
| 在智能查询里问 | 把 index 与 sourcetype 带到首页 |