

数据接入
粘一段原始日志 → 识别格式 → 生成 props.conf / transforms.conf / rex / CIM 映射 → 在真数据上试跑覆盖率 → 写入 local/ 并可回滚。1.7.0 起。
新 sourcetype 进来要写 props.conf、抽字段、映射 CIM,是 Splunk 管理员最耗时的活。数据接入把它变成三步,每一步的产物都能看、能改、能在真数据上验。需要许可(与检测规则同档);写入需要管理员。
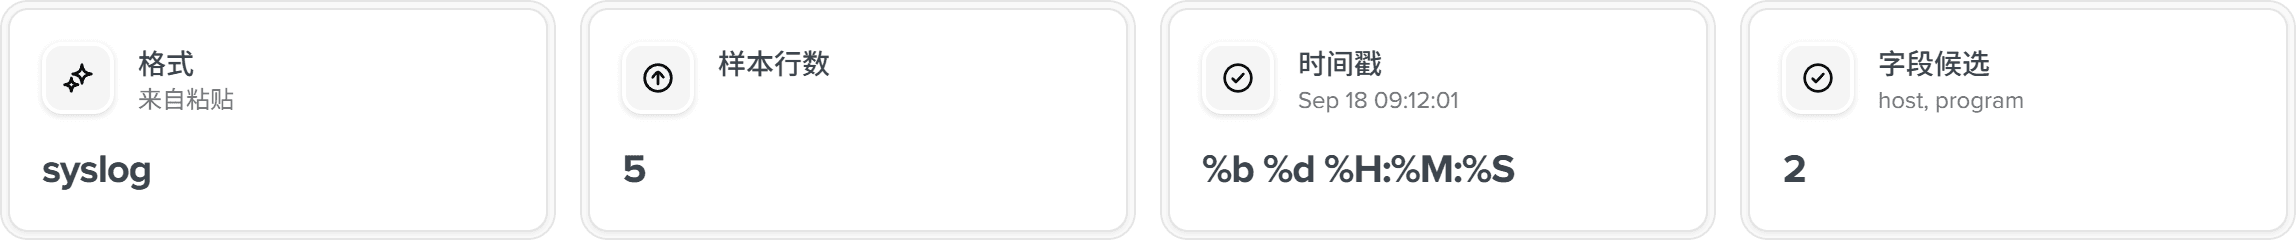
第一步:识别
粘贴 20–50 行原始日志,或选一个已有的 index + sourcetype 让它自己采样([onboard] sample_rows,默认 50 条)。识别是纯规则,不调模型:
| 输出 | 说明 |
|---|---|
| 格式 | json / kv / csv / syslog / multiline |
| 时间戳 | 候选字段与 TIME_FORMAT(如 %b %d %H:%M:%S、%Y-%m-%dT%H:%M:%S,含无时区 ISO) |
| 换行 | LINE_BREAKER / SHOULD_LINEMERGE |
| 字段候选 | kv / json 直接得到;syslog 类给正则候选 |
第二步:生成
模型(agentic)根据识别结果写配置,并用 run_spl 在样本 sourcetype 上跑 | rex 自验字段能抽出来:
| 产物 | 内容 |
|---|---|
props.conf | TIME_FORMAT / LINE_BREAKER / KV_MODE / EXTRACT-* / EVAL-* / FIELDALIAS-* |
transforms.conf | 只在 csv 或需要 REPORT- 时生成 |
| rex 列表 | 每个 EXTRACT- 对应的正则与目标字段 |
| CIM 映射 | 推荐的数据模型(Authentication / Network_Traffic / Web / Endpoint …)与字段对应表,必填字段缺失会标出 |
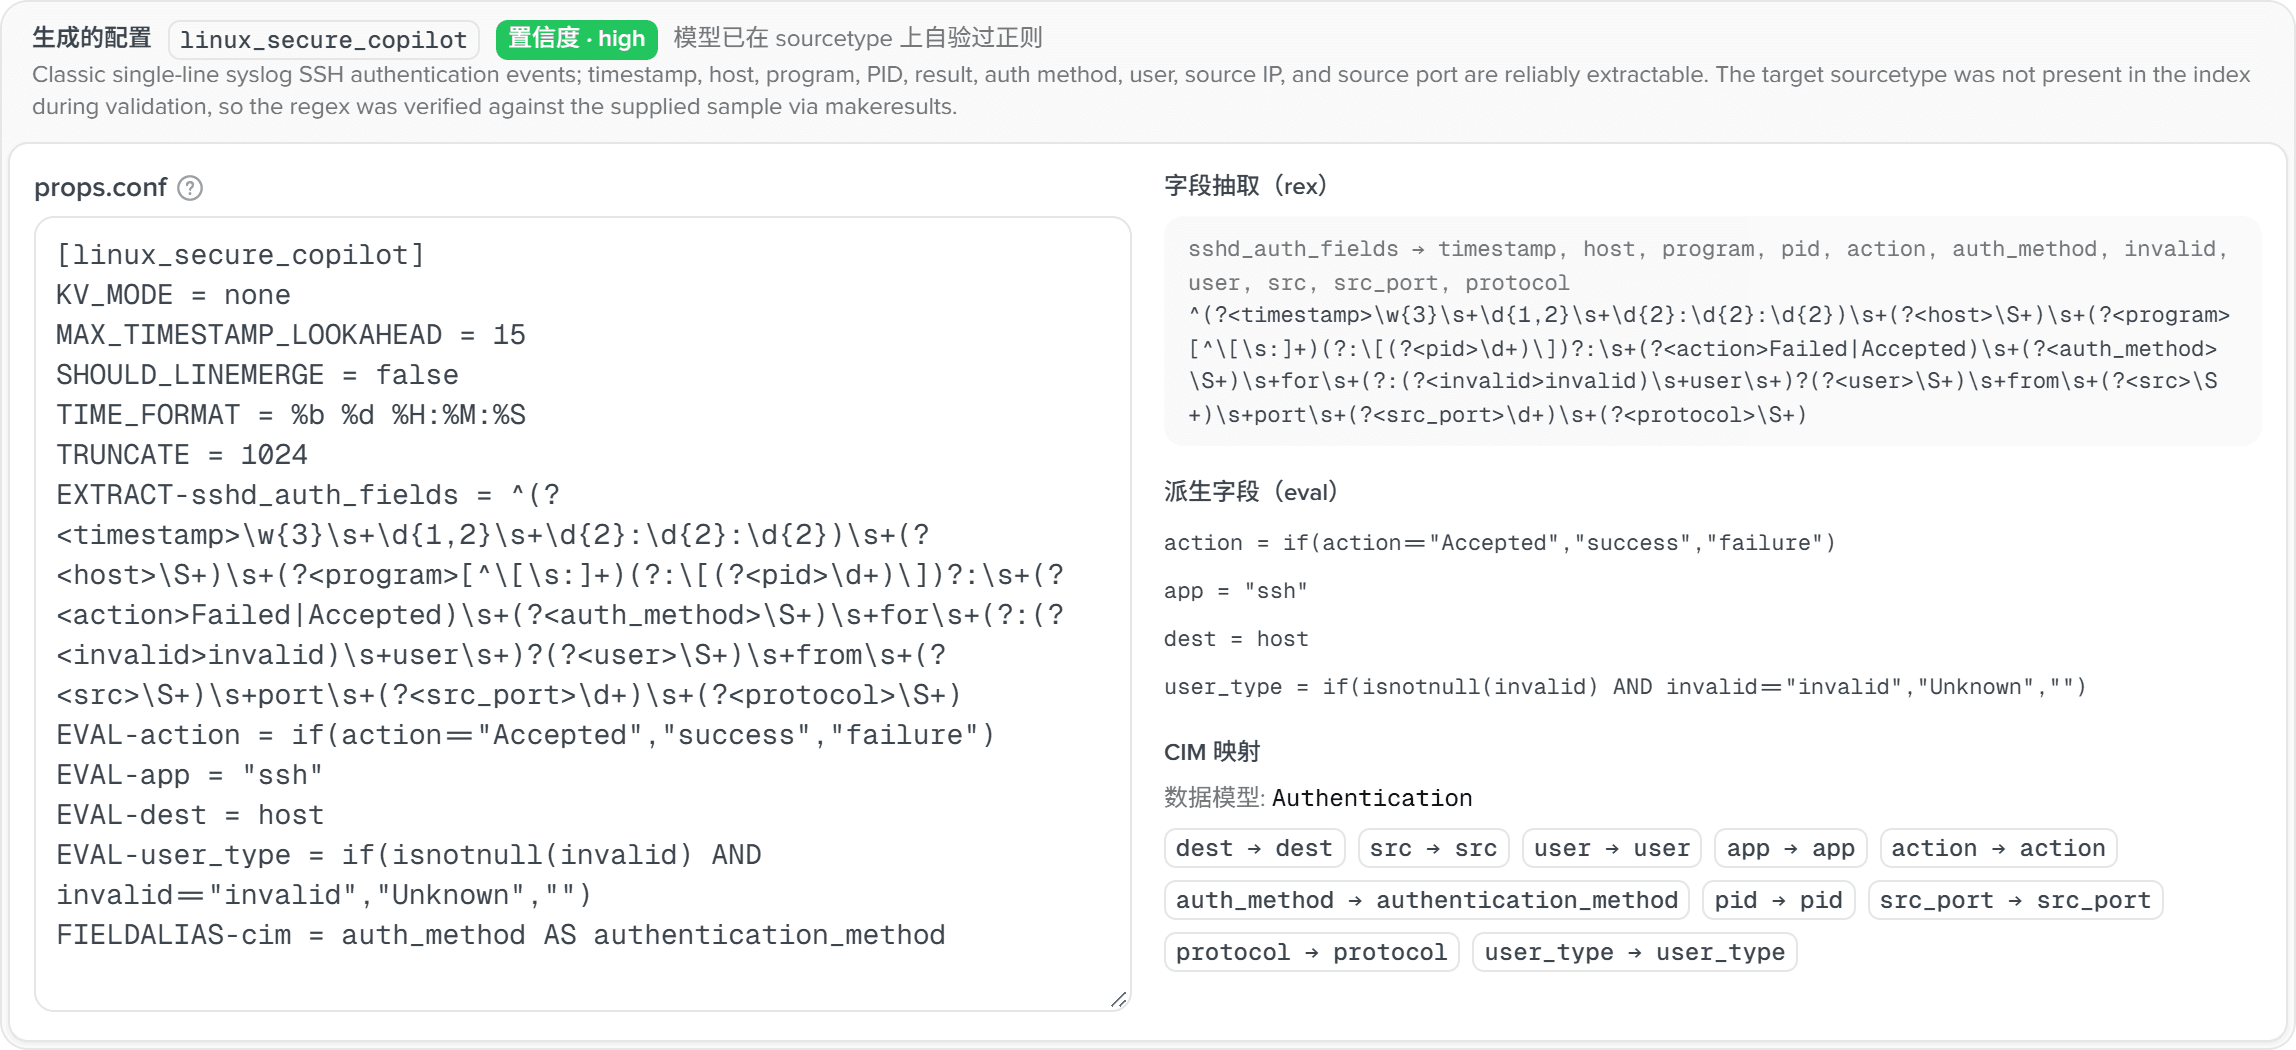
配置块可直接编辑。1.9.0 真机 sshd 样本约 21–29 秒。
第三步:试跑
对指定 index / sourcetype 近 1000 条(dryrun_rows,上限 5000)跑一遍抽取,每个字段给:抽取率、空值率、首个样例;CIM 页签对照数据模型的字段清单(装了 CIM 读真清单 /datamodel/model,没装用内置最小表)。真机:sshd 样本 15 个字段覆盖率 93.9%,pan:traffic 100%。
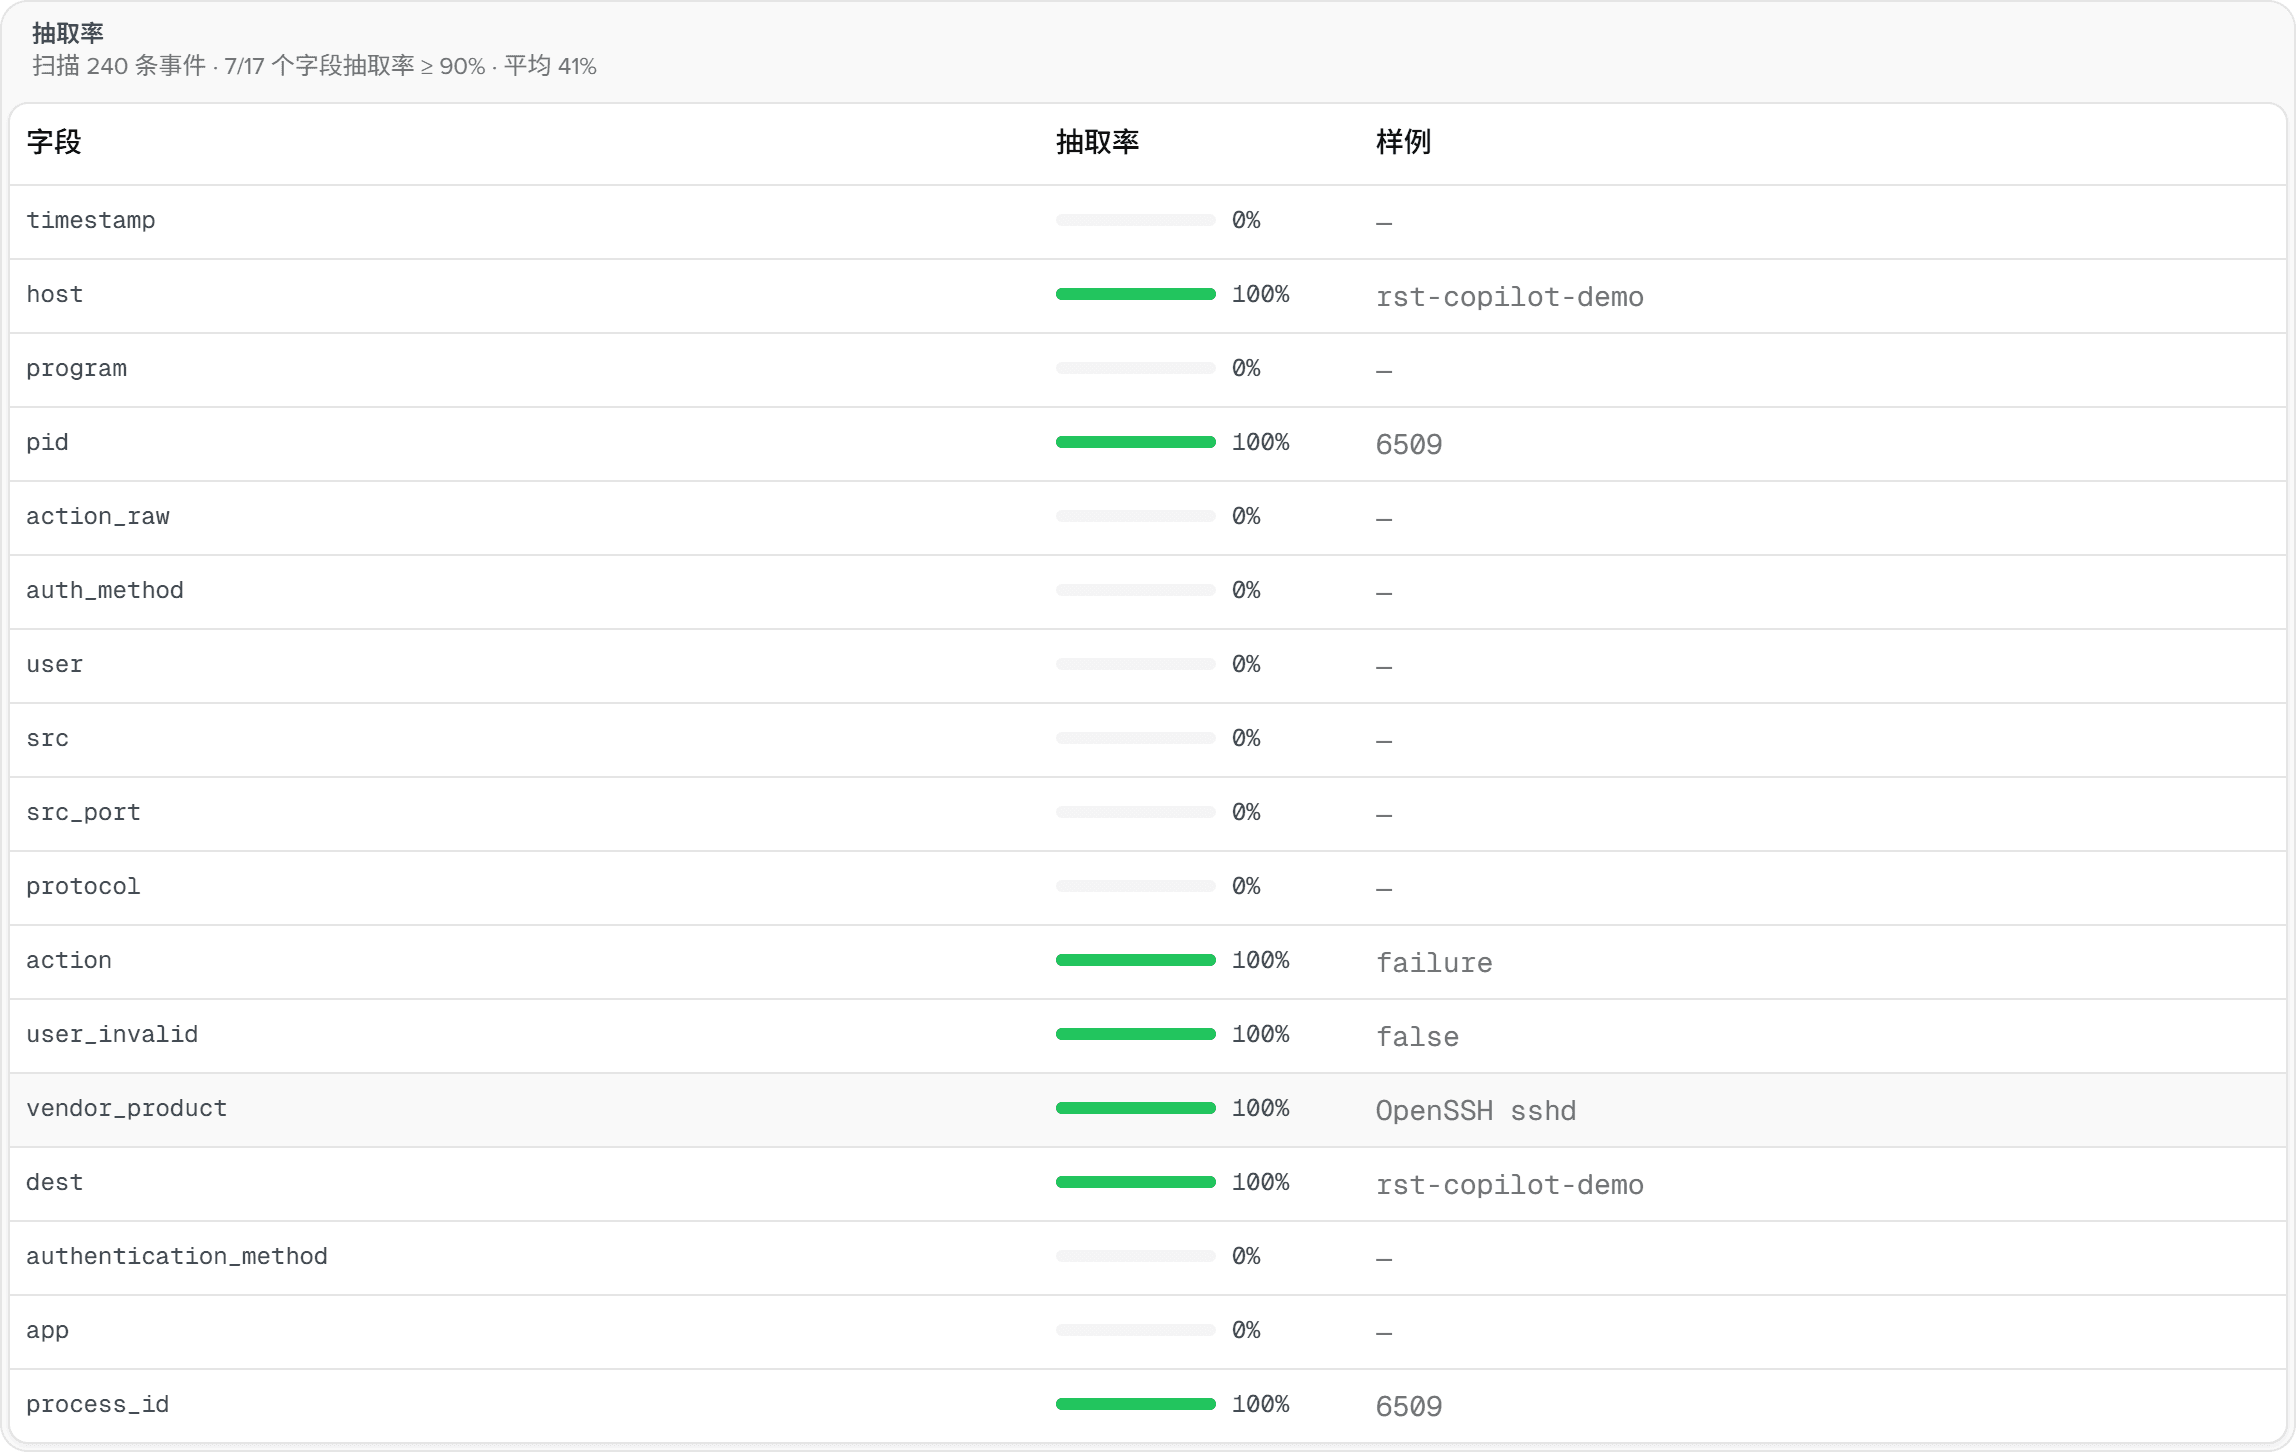
写入与回滚
「写入」把 props.conf / transforms.conf 写到目标 app(默认 search,[onboard] default_app)的 local/,先备份成 *.conf.bak-<时间戳>,然后 _reload;本次新建的文件带 .created-by-copilot 标记。「回滚」只动有备份或有标记的文件,不会删客户原有的配置。「下载」拿到两个 conf 自己放。
写入后到字段字典看新字段;tstats 只对索引时字段有效,search-time 抽取用 | stats count by <字段> 验。