

智能查询
一句话查日志。网关翻译成 Elasticsearch DSL、只读校验、试跑后执行;结果为空时给出原因和改法。
智能查询是首页,所有版本都有;未激活时计入每日额度。
从提问到结果
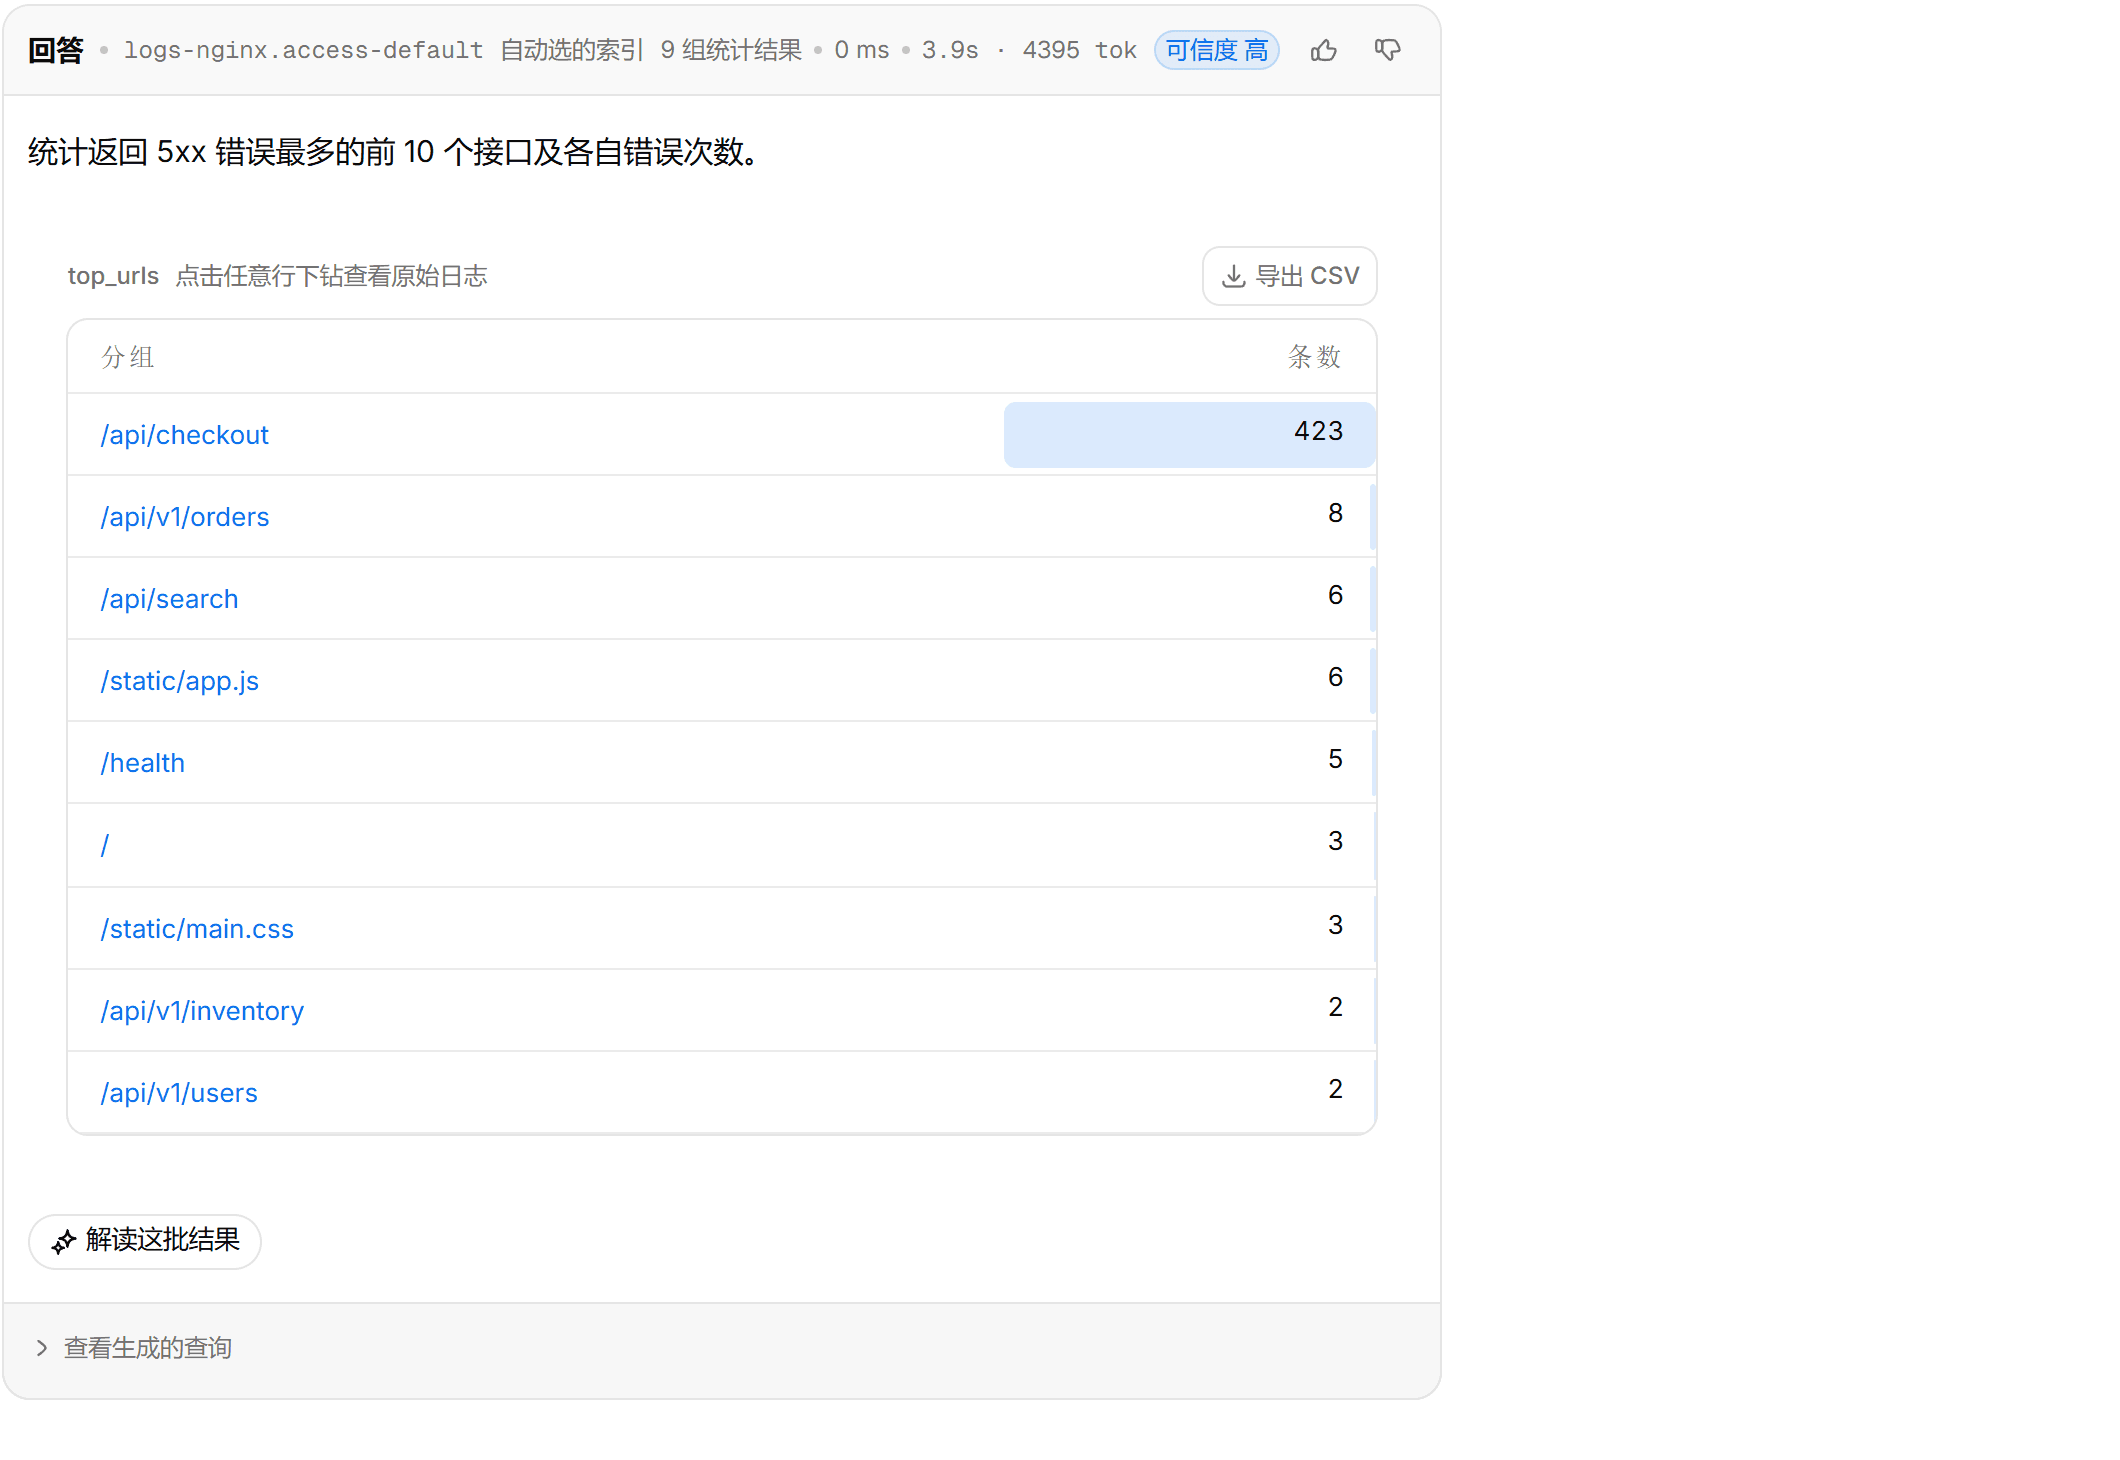
- 理解问题:判断索引、时间范围、统计维度。索引默认「自动」,路由按问题挑最像的一个;也可以在输入框左侧指定。
- 生成 DSL:只读校验拒绝写操作和脚本,然后在目标索引上
size=0试跑。试跑报错就把错误喂回模型修一轮。 - 执行:返回明细表或聚合表。卡片头部标出索引(自动选的还是指定的)、命中数、耗时、token 用量,以及模型对这条查询的可信度自评:高可直接用,中建议展开核对 DSL,低多半要换个问法。
生成过程中显示「理解问题 → 生成查询 → 执行」三段进度;思考模型的推理内容折叠在「AI 在想」里。
输入
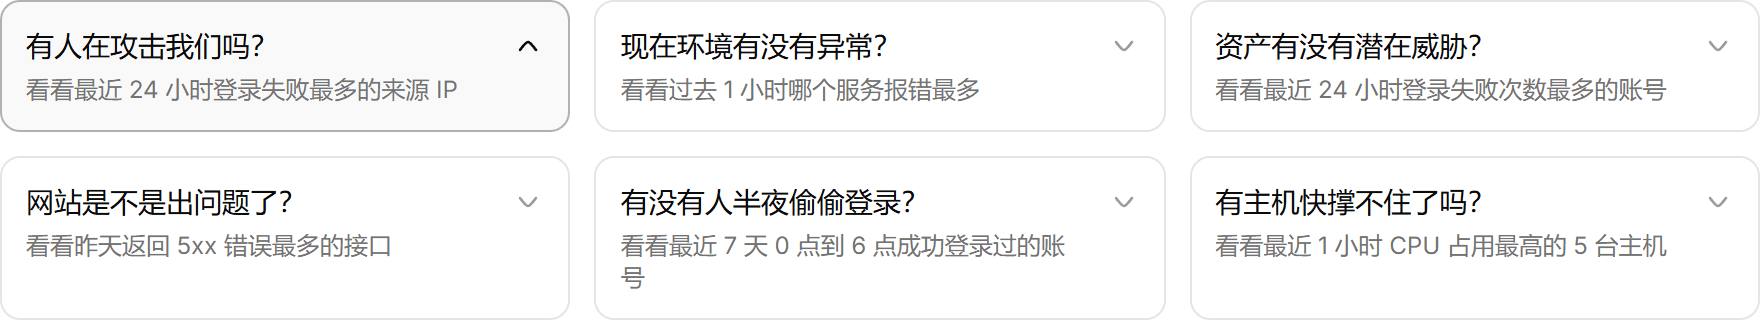
首页给六类起始问题,每类四个现成问法,点问法直接发送。保存过的快捷查询在「我的常用」里。
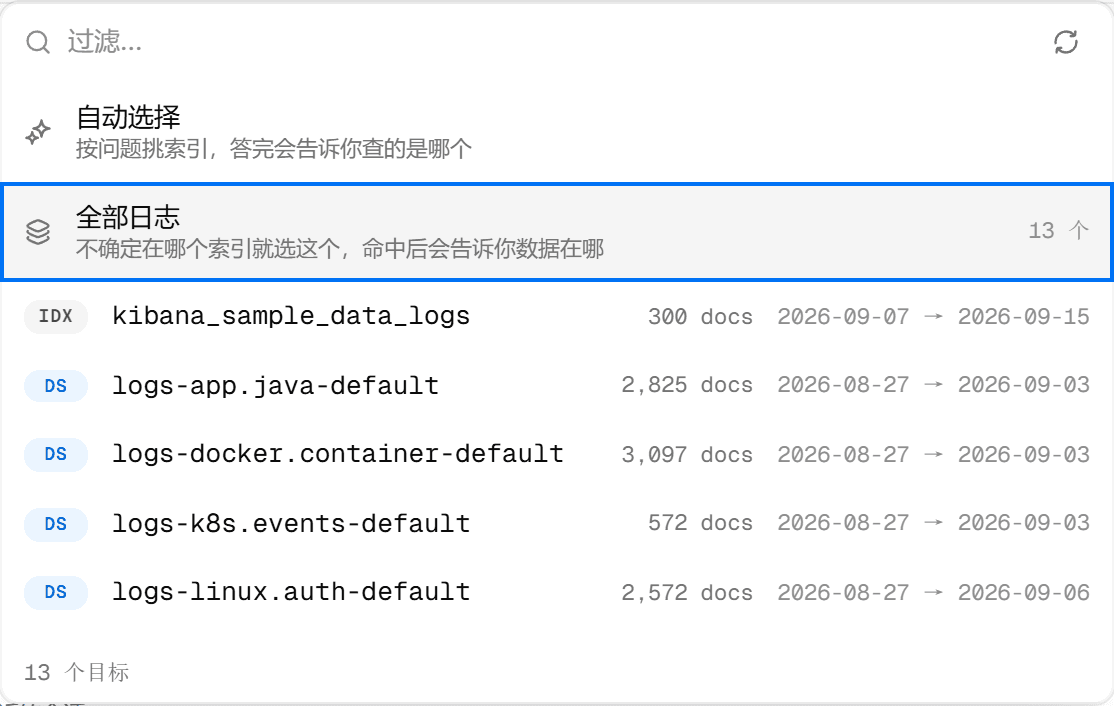
- 索引:默认「自动」;可从白名单里挑一个。
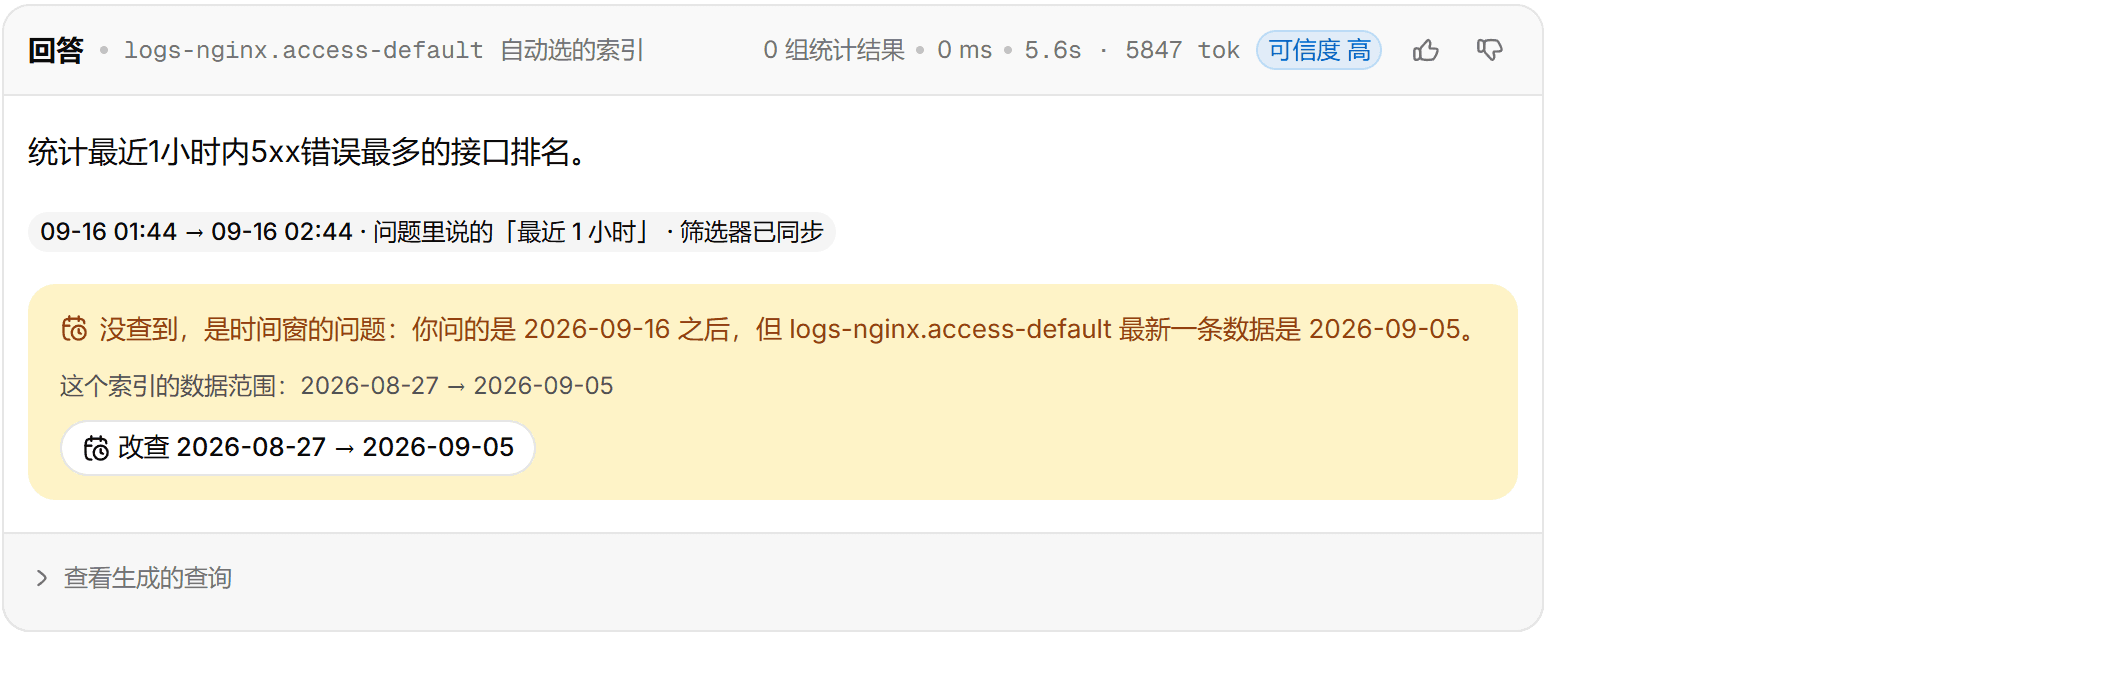
- 时间范围:默认「全部时间」。选了范围后,问题里的「最近 1 小时」和它取交集,卡片标明是「筛选器已同步」「已覆盖问题里的时间条件」还是「在问题的时间条件之内」。
- 回车发送,
Shift+Enter换行。
结果
| 结果类型 | 能做什么 |
|---|---|
| 聚合表(「最多的 10 个 …」) | 点任意一行下钻到该分组的原始文档,「返回统计」回来;「导出 CSV」 |
| 明细表 | 列集按索引记忆;单行「解读」让模型解释这条日志 |
| 生成的查询 | 展开完整 DSL:编辑后重跑(标「已手改」)、复制、「在 Kibana 中打开」(需配置 Kibana 地址)、「存为快捷查询」 |
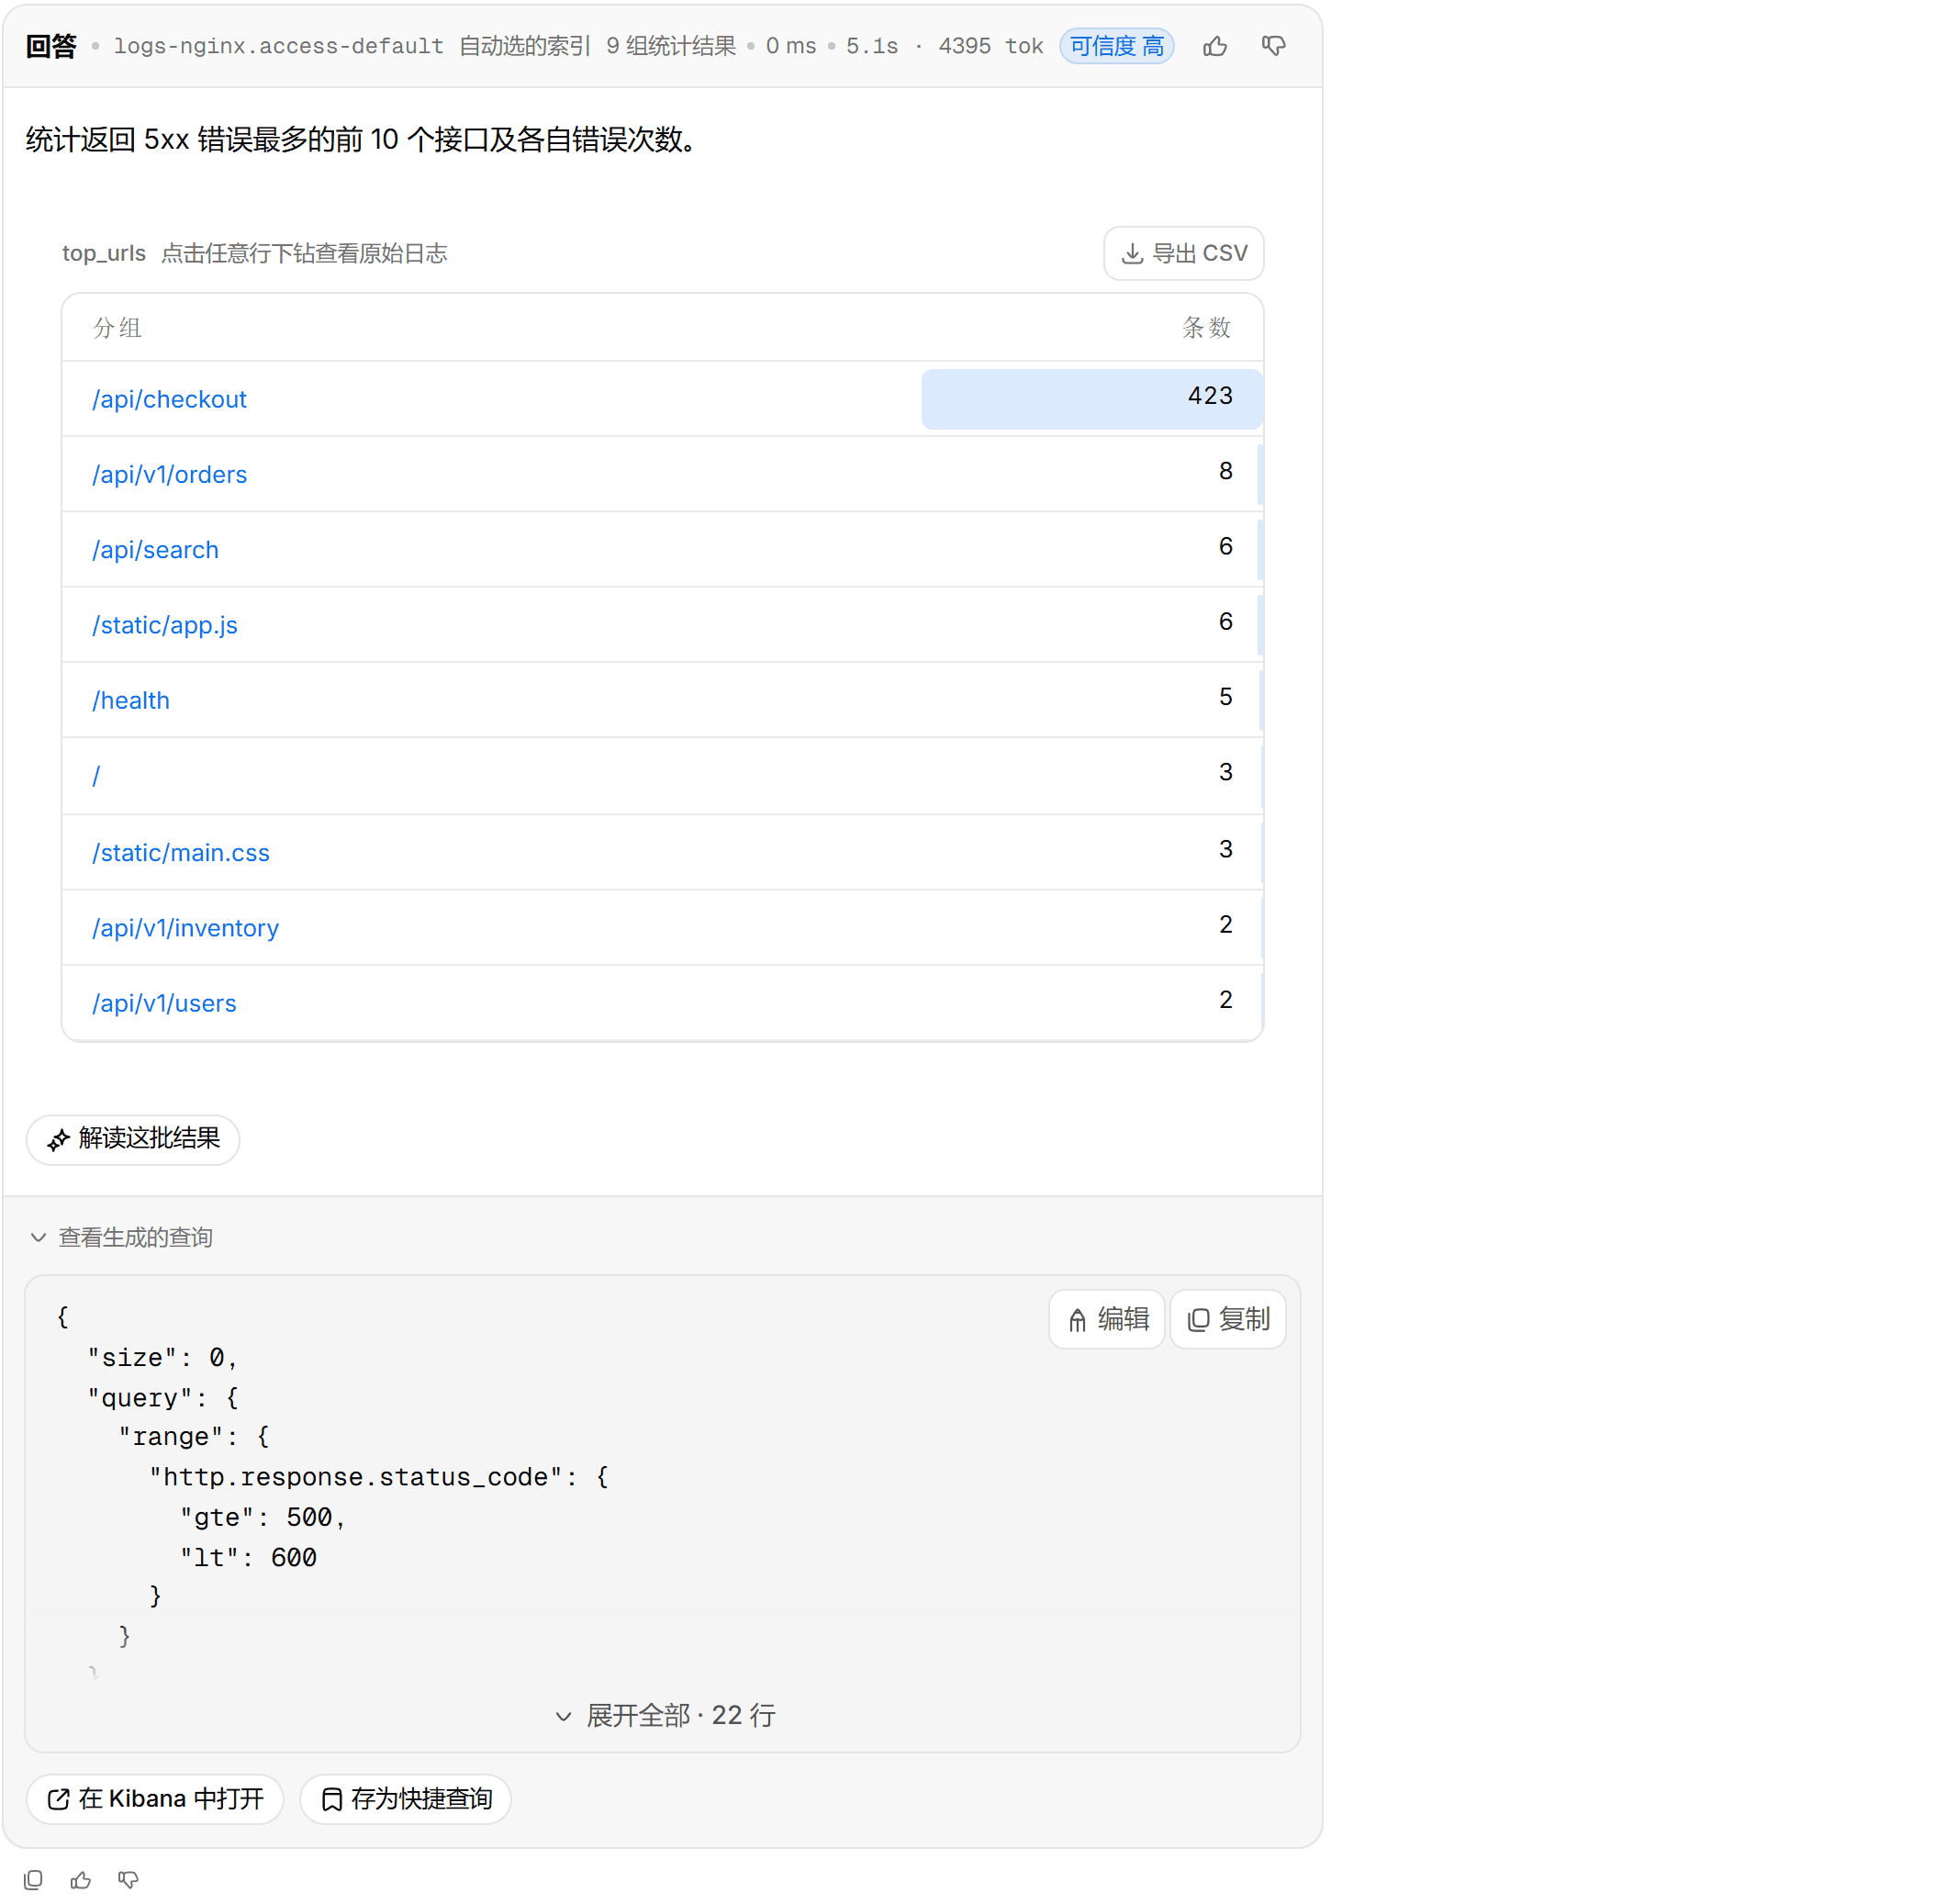
结果下方:「解读这批结果」让模型总结;「送去分诊」把命中的告警送到批量分诊;👍 / 👎 反馈进入学习库,👎 可以附上正确的查询,同类问题下次按它生成。
结果为空
网关区分「真的没有」和「问法 / 数据的问题」,四种情况分别处理:
| 情况 | 表现 | 处理 |
|---|---|---|
| 时间窗不对 | 问「最近 1 小时」,索引最新数据是十天前 | 给出索引的数据范围和「改查 ⟨范围⟩」按钮一键重跑;索引里有「未来」日志(采集端把本地时间当 UTC 写入)也会指出 |
| 条件卡住 | 多个条件、结果为空 | 逐个放宽条件试,列出「去掉某条件后有 N 条」,点一条按放宽后的条件重跑。典型原因是日志原文和问法用词不同(Out of memory 而不是 OOM) |
| 索引选错 | 这个索引没有 | 在其他索引里找同样的条件,列出索引和条数,点索引名只查它;都没有就建议「在全部日志里重新生成」 |
| 多源部分未命中 | 问题涉及几个索引 | 指出哪个数据源一条都没匹配上,提示可能是字段值写法不同 |
多轮追问
同一会话里继续问,模型带上一轮的上下文:沿用索引(卡片标「沿用上一轮的索引」),理解「第一名」「那个 IP」这类指代。换话题点右上角「+」开新会话。
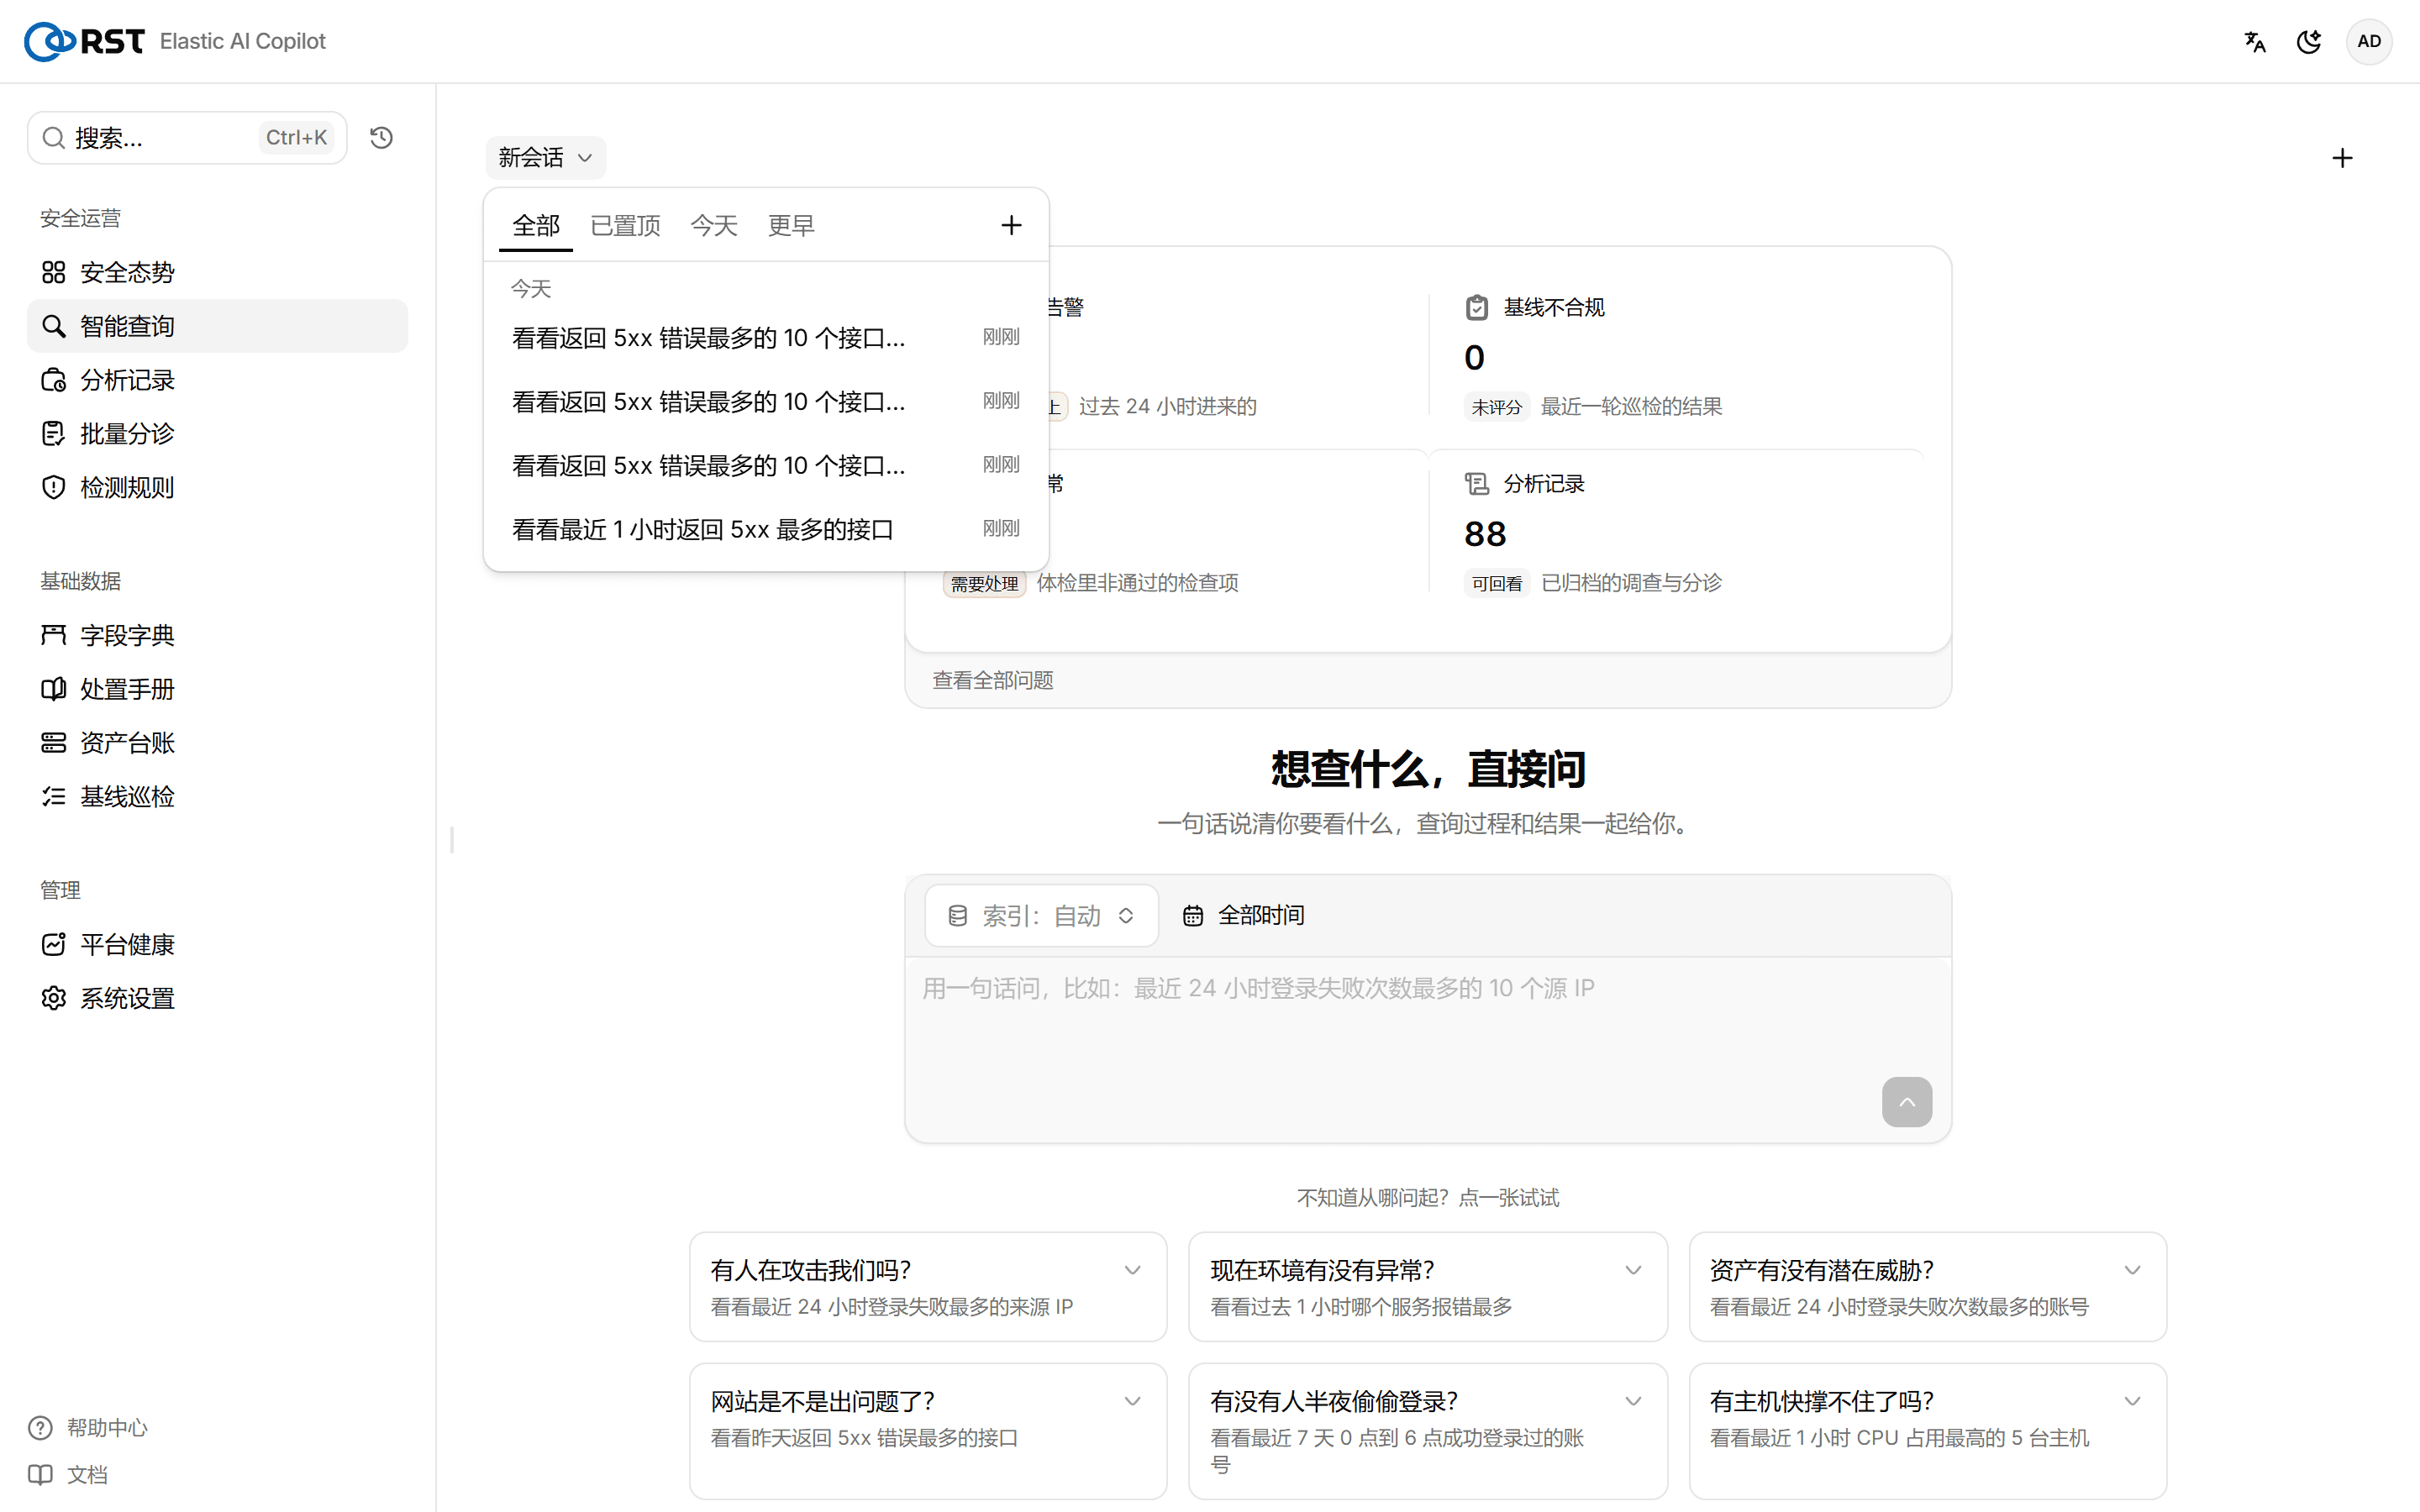
会话存在网关侧(ES 的 .rst_copilot_conversations,7 天不活动后过期),换浏览器可续。左上角会话名下拉列出历史会话,角标标出上次失败 / 已中断 / 生成中。
首字超时
模型 45 秒内没有首字,请求中止并提示重试(RST_LLM_FIRST_TOKEN_TIMEOUT_S,0 = 不限)。多数是模型端拥塞;连续出现就去 AI 配置把该 provider 的推理强度调低或换一个。
脱敏
发给模型之前按系统设置里的档位处理:云端模式把 IP、账号等替换成占位符(结果里的 10.30.x.x),私有模式放宽,离网模式不出网。三档所有版本都有。