

AI 配置
引擎状态、provider 卡与故障转移链、思考模式、语义检索(embeddings)、24 小时调用趋势。
AI 配置位于系统设置的页签中,管理员可见。
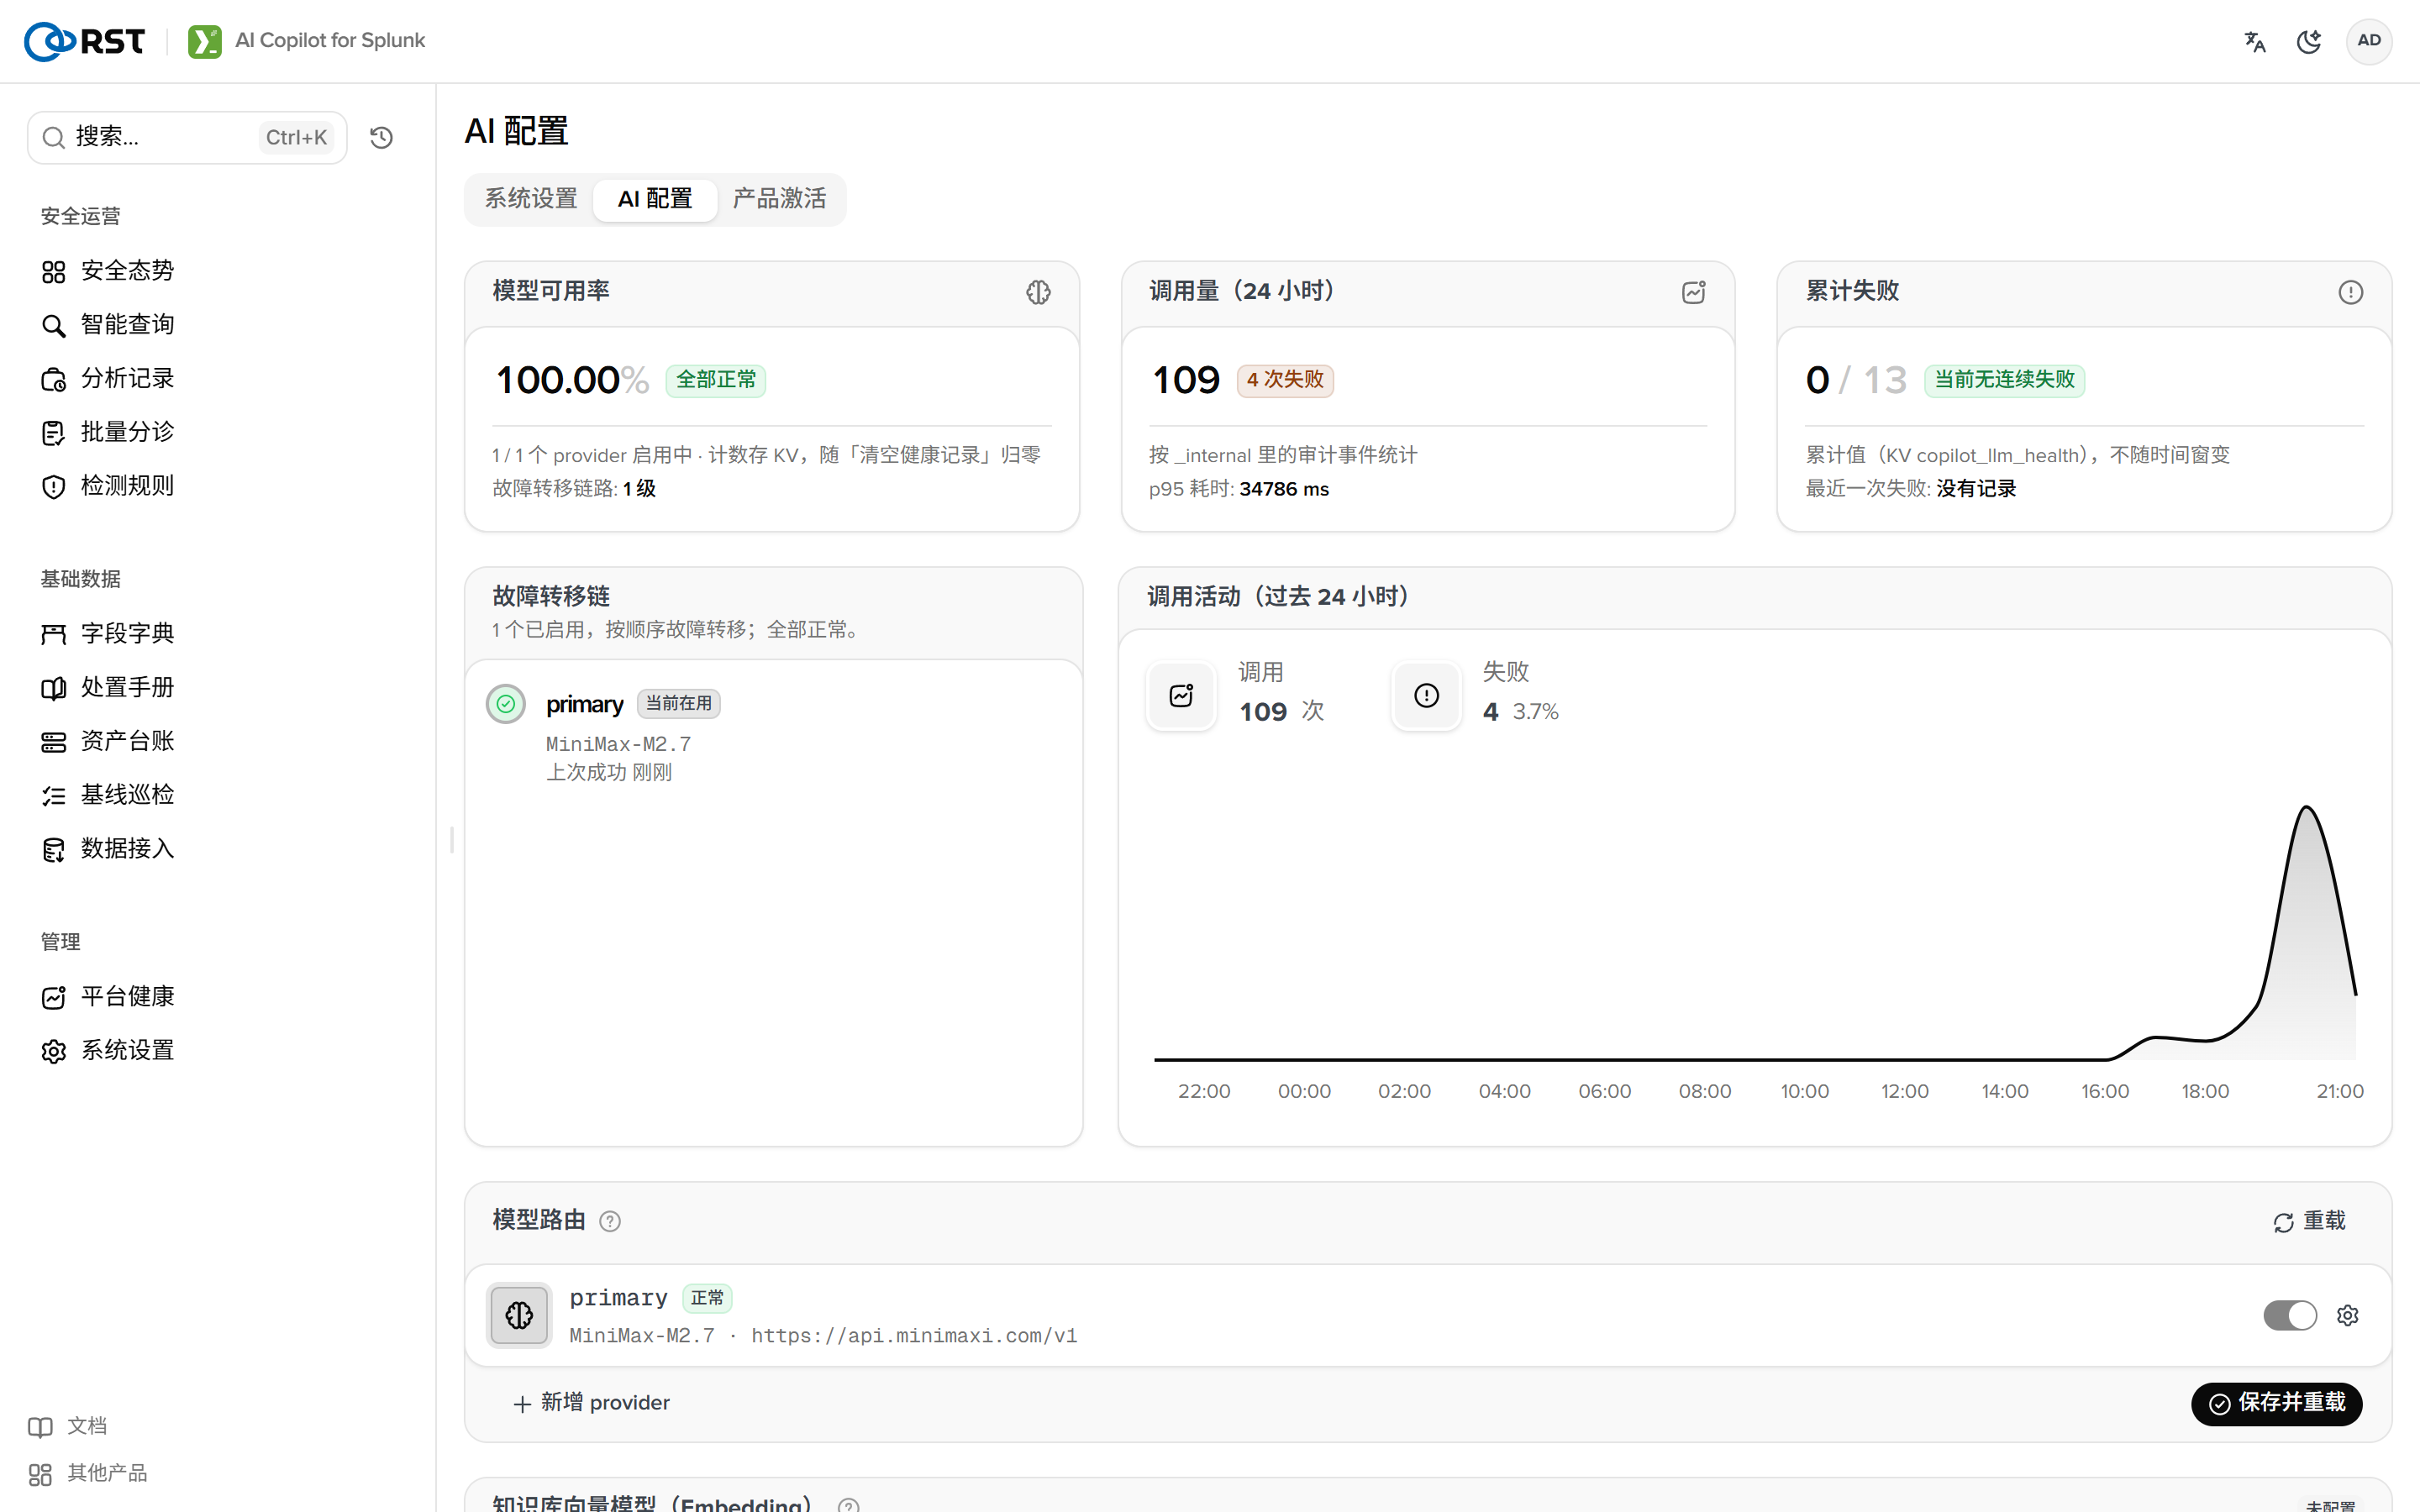
引擎
顶部卡显示当前引擎:agentic(splunklib.ai Agent,模型自主调用只读工具)或 requests fallback,以及 fallback 的原因(python_too_old、splunklib_ai_missing、import_error)。两者功能相同,差别见系统要求。
Provider
故障切换自 2.0.14 起正式发布(此前为 Beta)。卡住不响应的 provider 在 [llm] timeout_seconds 后即切换,审计日志记录实际处理请求的 provider。
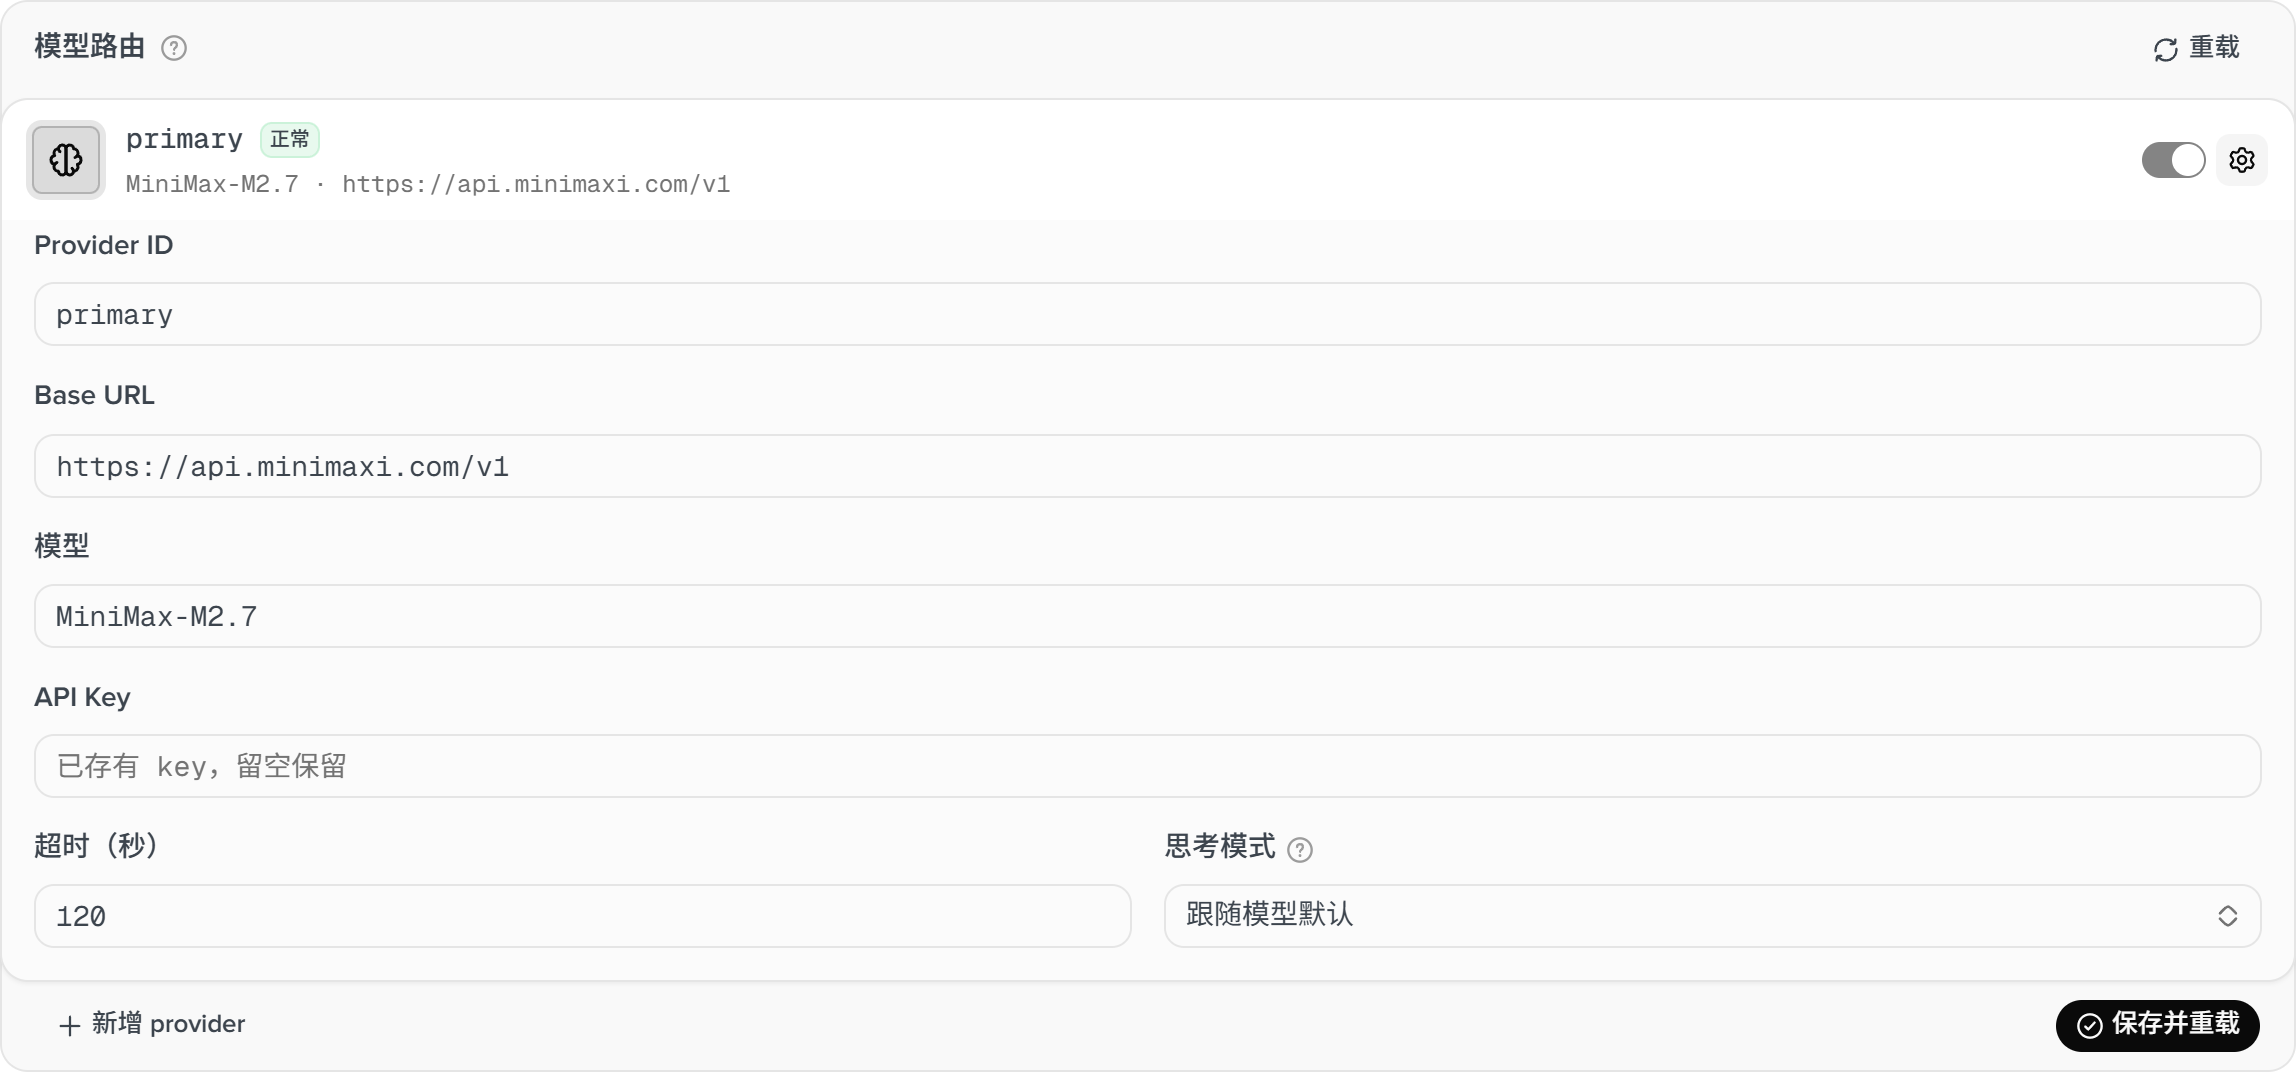
主 provider 加任意数量的备用,按顺序故障转移:连续失败(超时、传输错误、5xx、限流)触发熔断,切换到下一个,主 provider 恢复后切回。每张卡的字段:
| 字段 | 说明 |
|---|---|
| 类型 | OpenAI 兼容。router 只识别该协议;Anthropic 协议的端点走其兼容层 |
| URL | 带到版本路径 |
| 模型 | |
| API key | 存入 storage/passwords,界面显示已存有 key,留空保留 |
| 思考模式 | 见下节 |
| 超时 | timeout_seconds |
测试连接发一条最小请求,显示往返时间。健康视图显示 24 小时调用数、失败数、P95,数据来自审计。
思考模式
| 档 | 行为 |
|---|---|
| 关闭(默认,推荐) | 发送关闭思考的参数。本产品每次调用都是固定格式的 JSON 输出,思考不提高准确率。方舟实测同一提示词从 29 秒降到 5.8 秒 |
| 跟随模型默认 | 不发送参数 |
| 低 / 高 | 固定档 |
参数按模型家族翻译:doubao、ark-、seed 对应 thinking;OpenAI o 系列与 gpt-5 对应 reasoning_effort;千问对应 enable_thinking;Anthropic 对应 thinking.budget_tokens。无法识别的模型(方舟上的 kimi、glm、minimax)不发送任何参数,避免 400。
语义检索
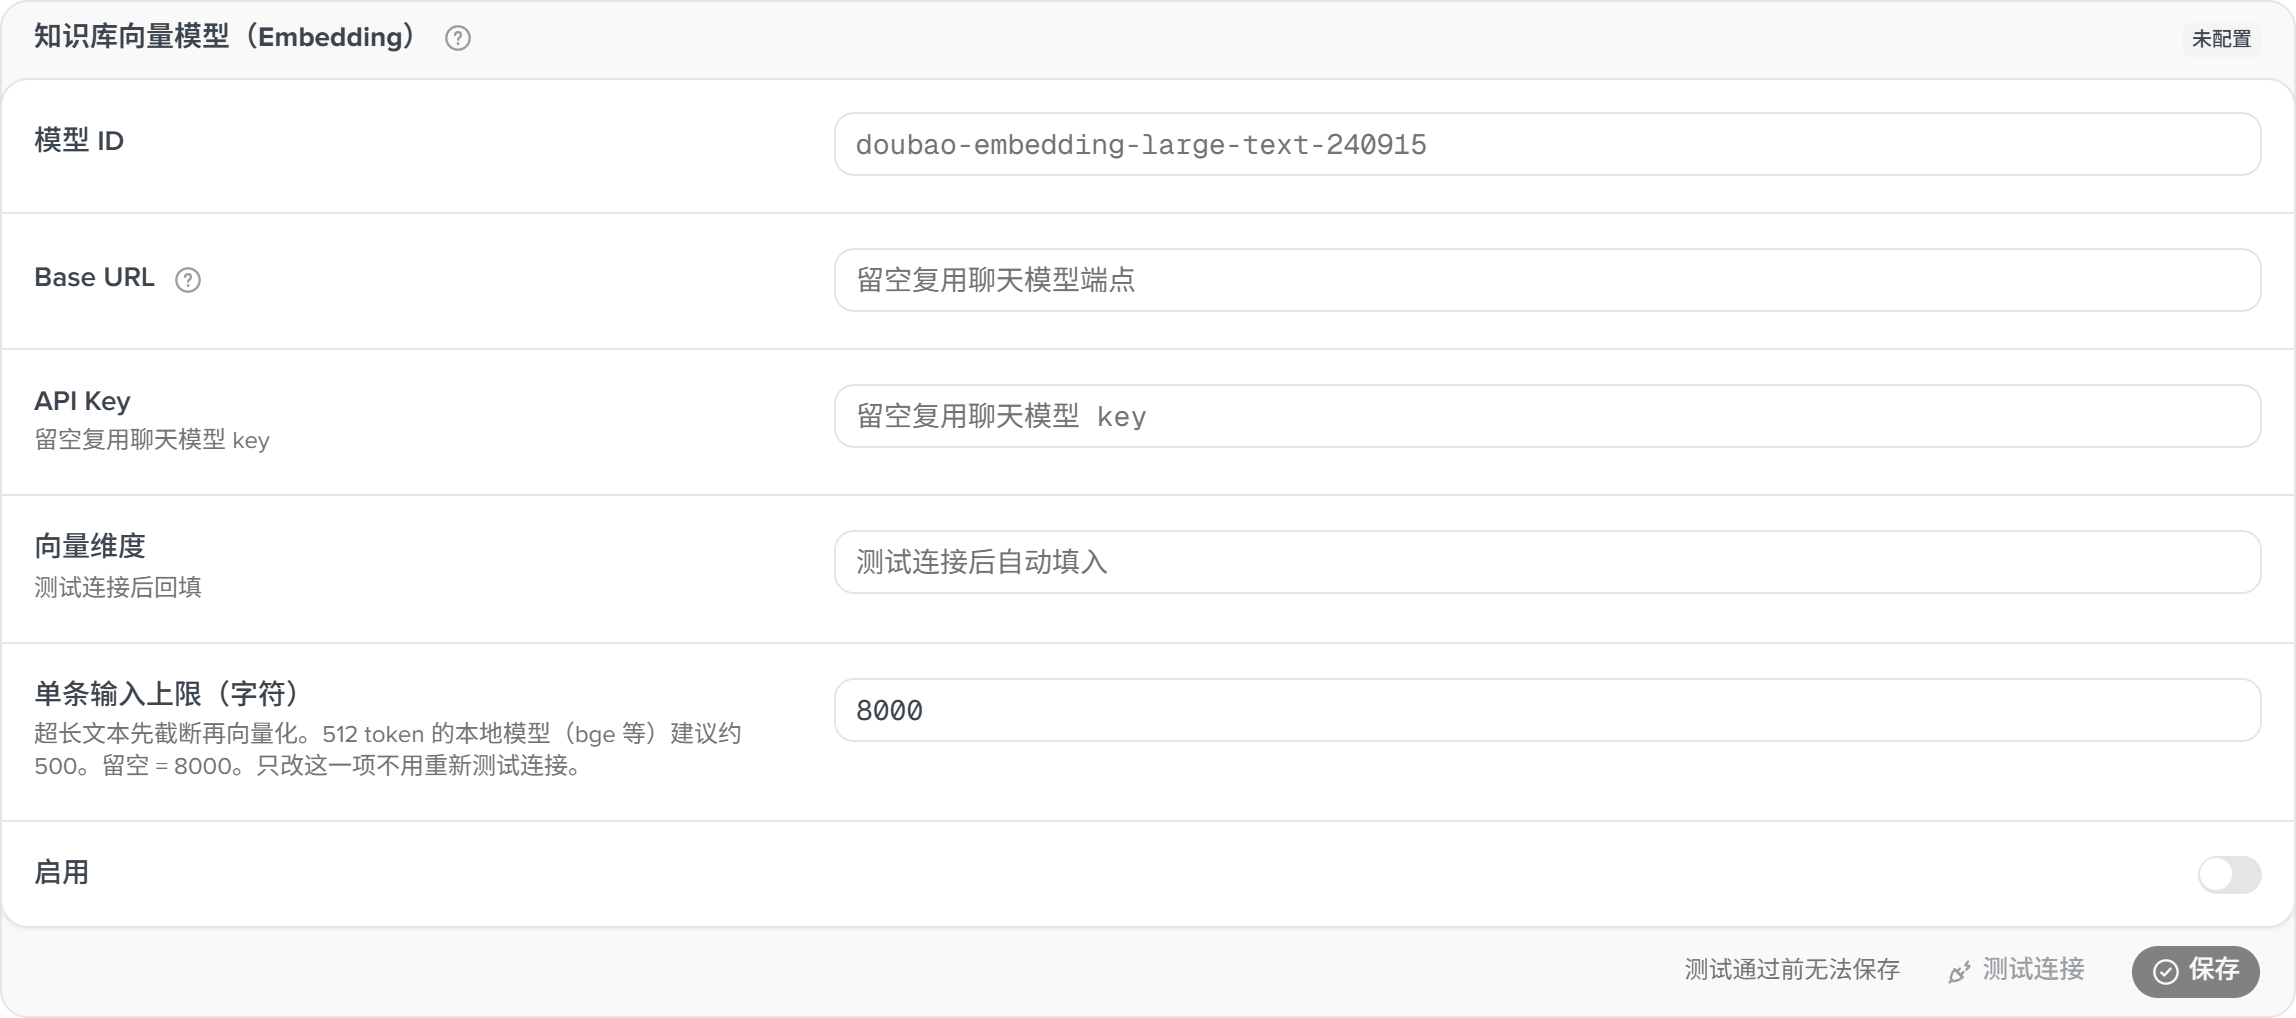
Embeddings 端点(URL、模型、key;key 留空复用 LLM 的)。测试连接探出的向量维度随保存写入。开启后知识库、解法库按语义相似排序;未开启时走关键词。更换模型后已有向量维度不一致,需重新上传文档。
调用趋势
24 小时调用折线(成功与失败)、P95、token,与调用审计同源。