

AI 配置
接入的大模型 provider、故障转移顺序、推理强度,每个 provider 的健康状态与 24 小时调用量。
AI 配置是 系统设置 页的一个标签,管理网关调用的大模型,修改需要管理员角色。每个 provider 是一个 OpenAI 兼容端点或 Azure OpenAI 部署。配置保存在网关的状态卷中,API key 加密存储。.env 中的 LLM_* 只在首次启动时作为第一个 provider 的初始值。
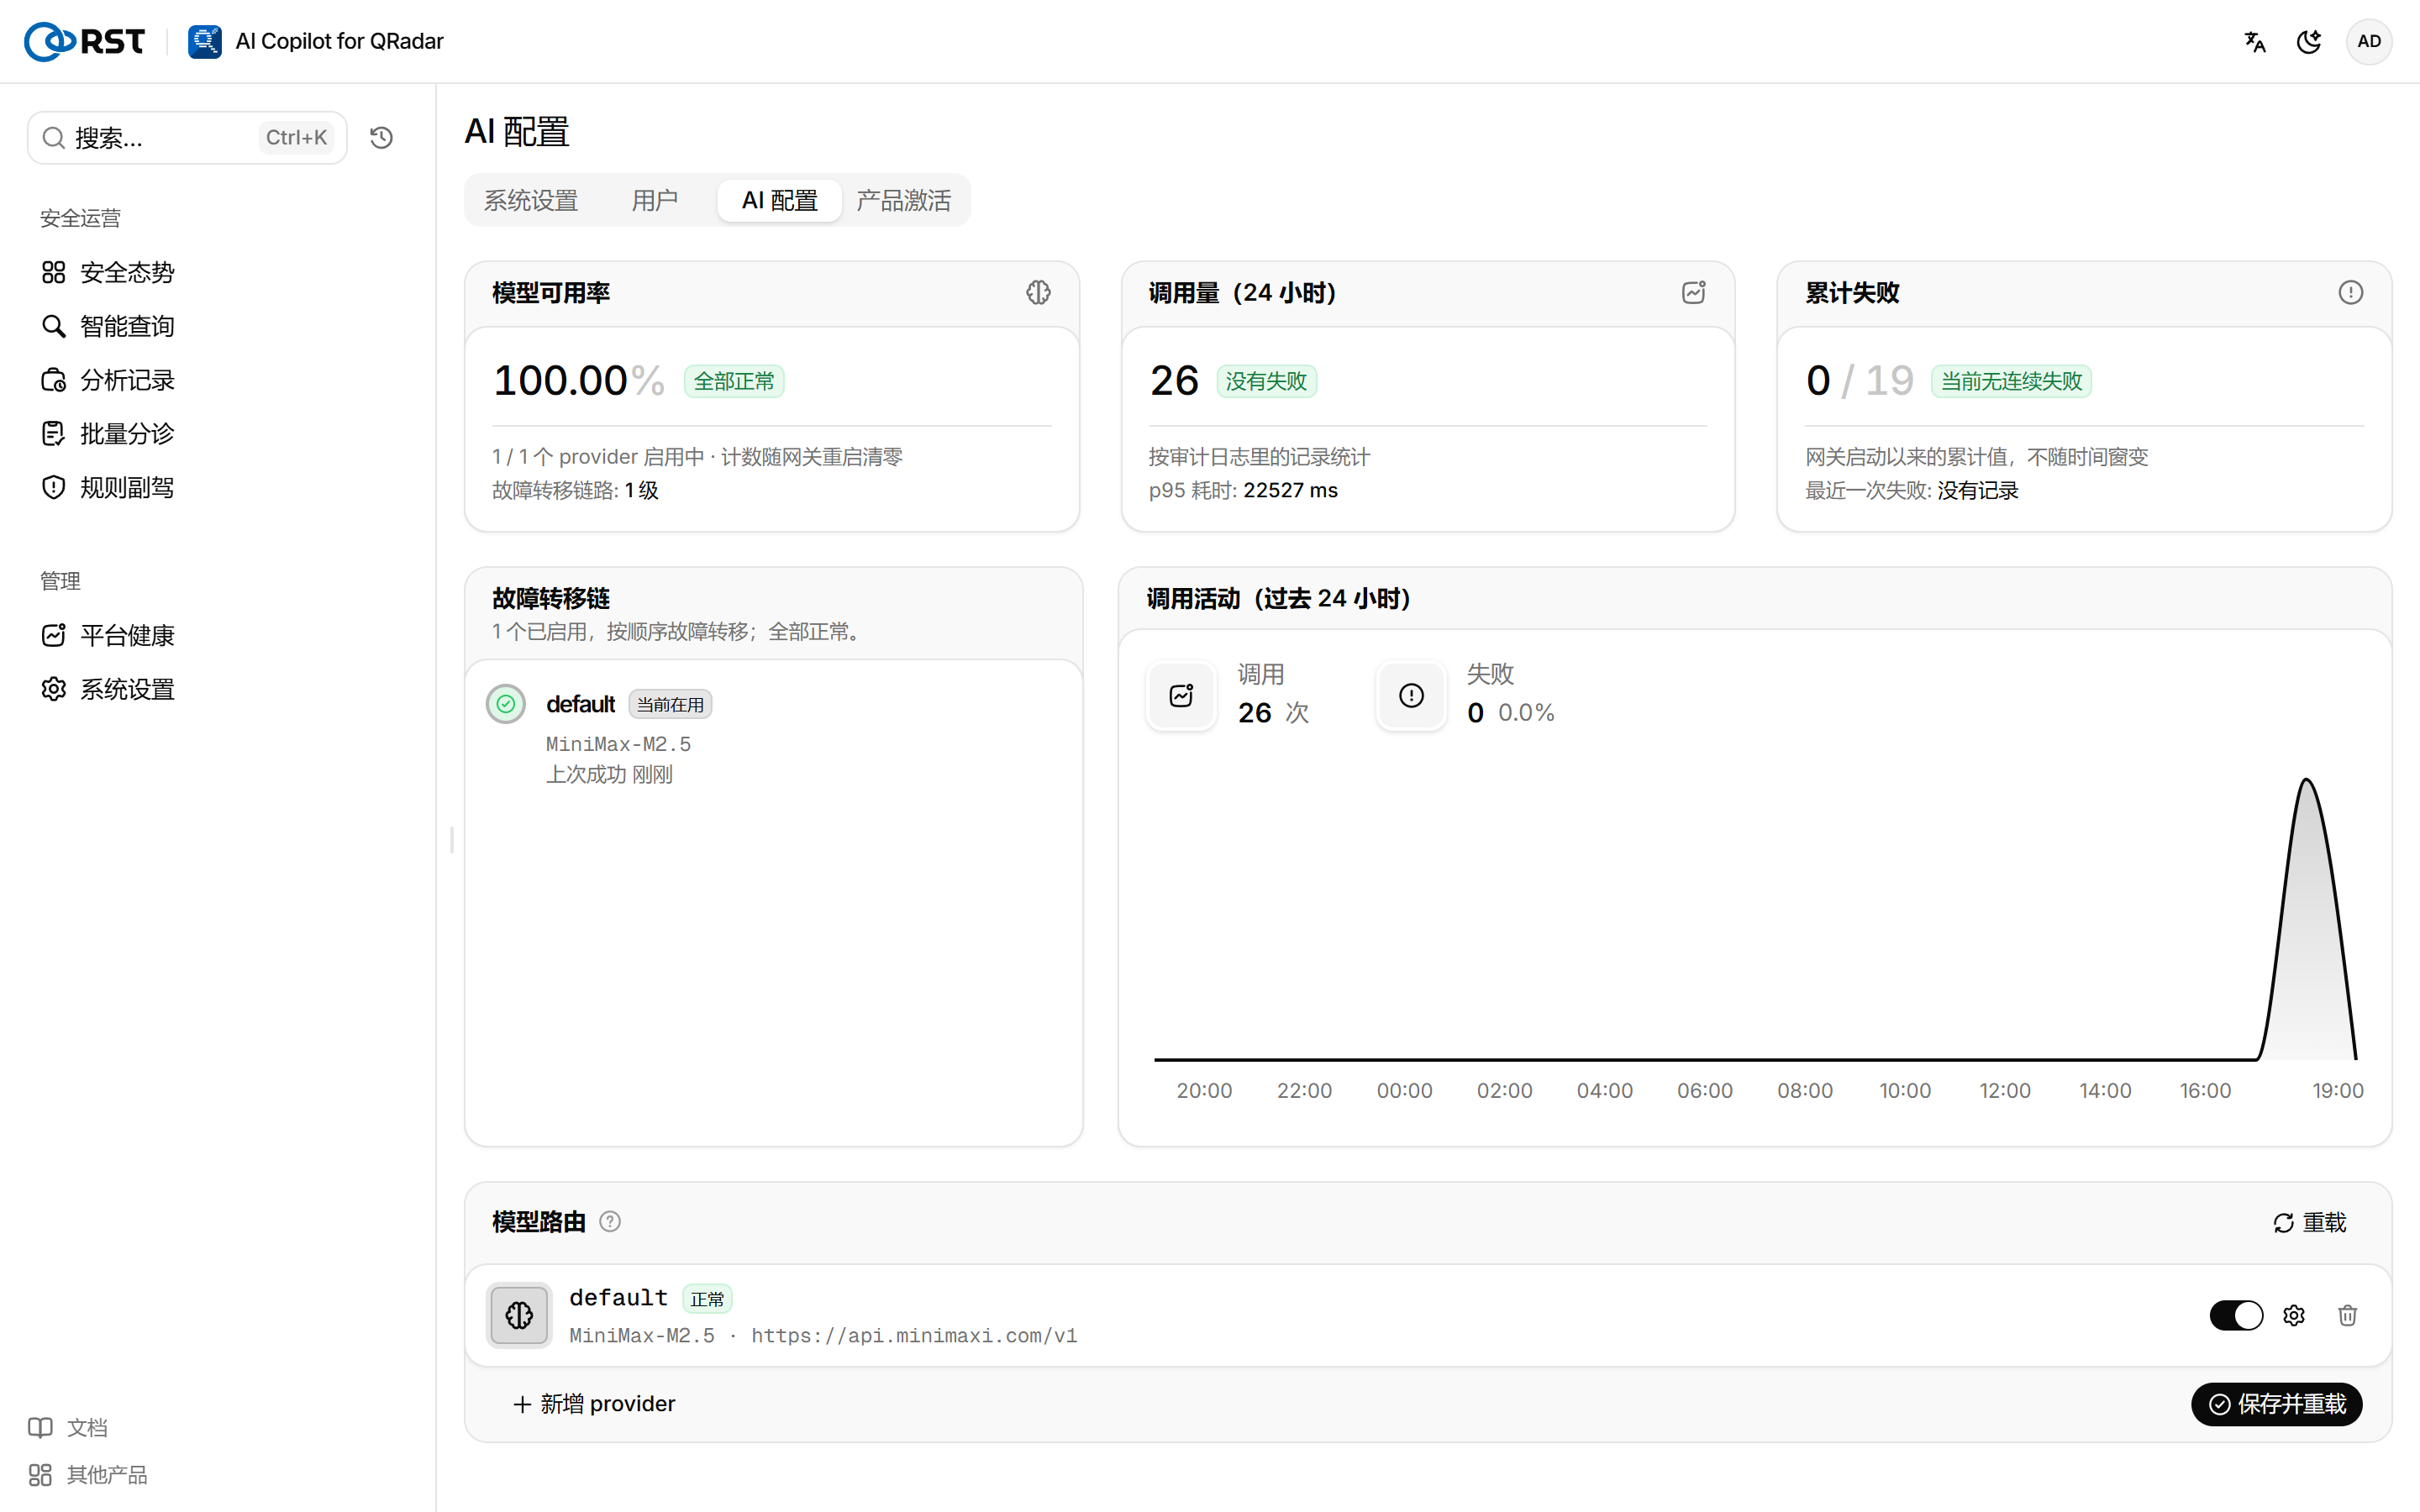
启用多个 provider 时,网关按列表顺序调用,一个 provider 连续失败后切换到下一个。故障转移是企业版功能:其他版本只使用第一个启用的 provider。
添加或替换 provider
前提条件
- 管理员角色。
步骤
- 在 模型路由 中选择 新增 provider。
- 展开设置,选择 类型,填写 模型、Base URL 和 API key,按需设置 超时(秒) 和 推理强度。
- 打开该 provider 的启用开关。
- 替换时,选择旧 provider 的 移除。
- 选择 保存并重载。
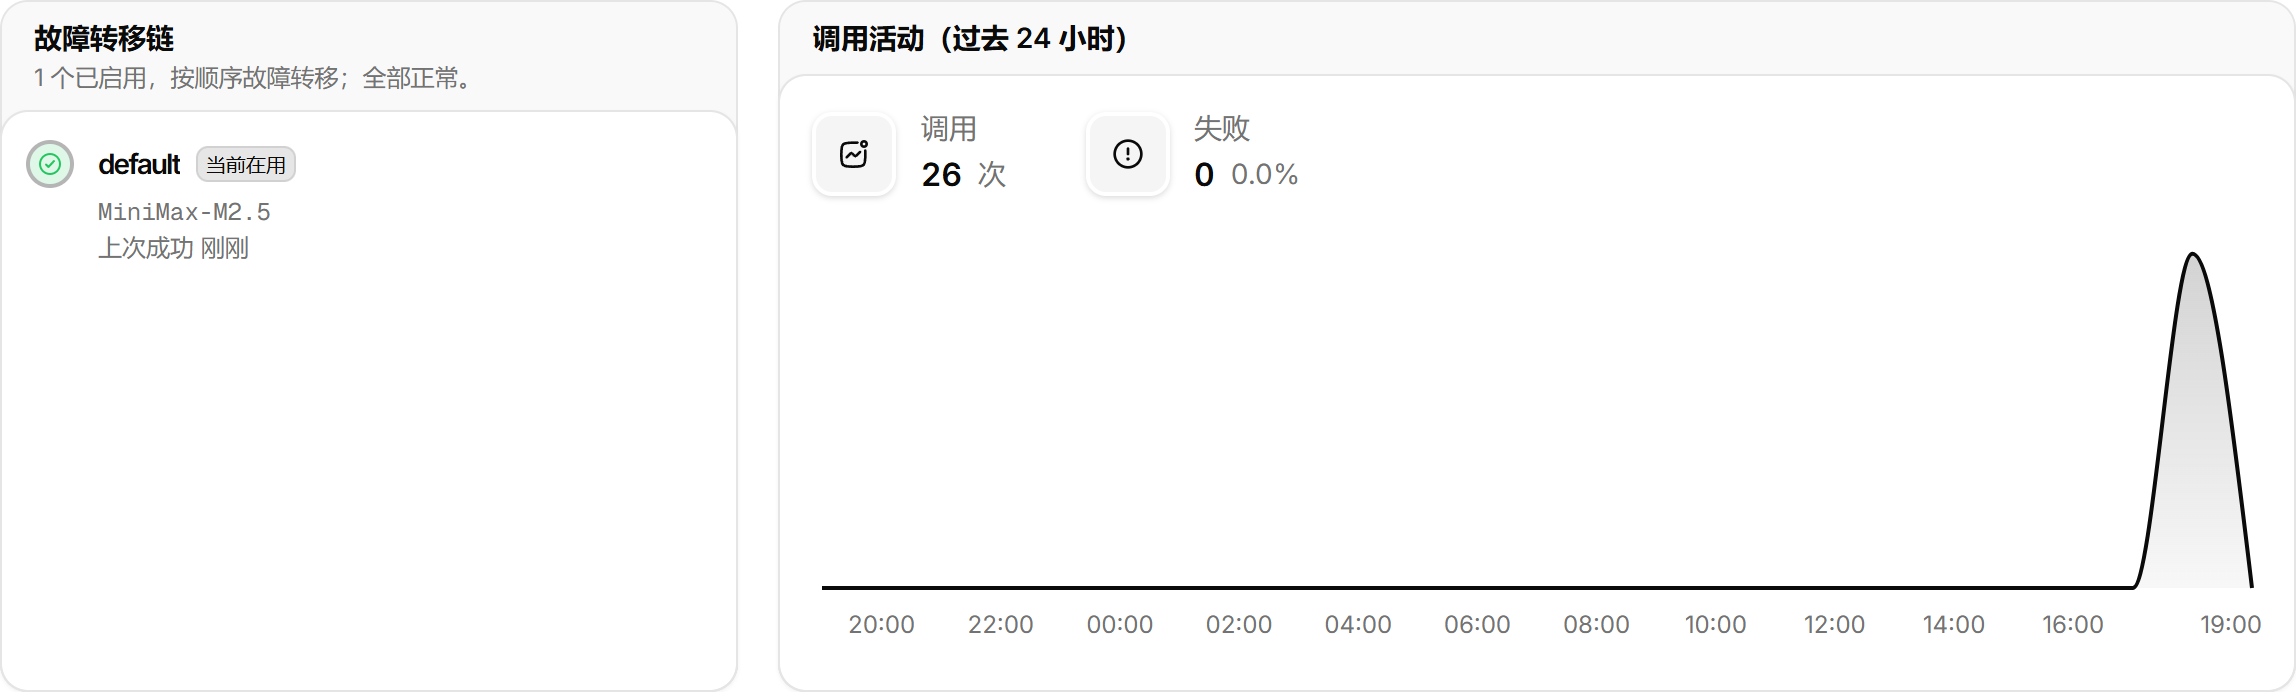
列表顺序即故障转移顺序,拖动调整。列表为空时保存会让所有模型调用失败,所以替换时先添加新的,再移除旧的,最后保存。
| 字段 | 说明 |
|---|---|
| 类型 | openai(含兼容网关) 适用于火山方舟、DeepSeek、通义、Ollama、vLLM 等。azure 需要填写 API 版本 和 部署名(不是模型名) |
| 模型 | 火山方舟 coding 计划填 ark-code-latest,自建 endpoint 填 endpoint id |
| API key | 粘贴新 key。已保存时留空保留现有 key,界面显示尾 4 位 |
| 标签 | 例如 primary,cloud,只用于标记 |
| 超时(秒) | 单次调用上限,默认 180。研判、调查、规则生成在思考模型上单次可达几分钟,慢模型设为 300 以上 |
| 推理强度 | 见下文 |
设置推理强度
思考模型(豆包、GPT-5、Claude、Qwen3、Gemini 2.5 等)先推理再作答,每次多耗时几十秒。推理强度 按 provider 设置:
| 档位 | 行为 |
|---|---|
| 自动(推荐) | 按任务决定。起标题、生成角度、Offense 摘要不推理;生成 AQL 为低推理(RST_NL2AQL_REASONING);Offense 调查、研判、规则设计为高推理 |
| 关 | 所有任务都不推理 |
| 低、高 | 所有任务都使用该档位 |
网关按 Base URL 和模型名识别供应商,把档位换算为该供应商的参数。无法识别的模型不发送推理参数;带参数的请求被拒绝(HTTP 400)时,去掉参数重试一次。OpenAI o 系列与 GPT-5 选择高时计费高于默认。
研判经常超时时,先把该 provider 的推理强度改为低并比较结果,再决定调大超时还是更换模型。
模型运行概览
| 指标 | 含义 |
|---|---|
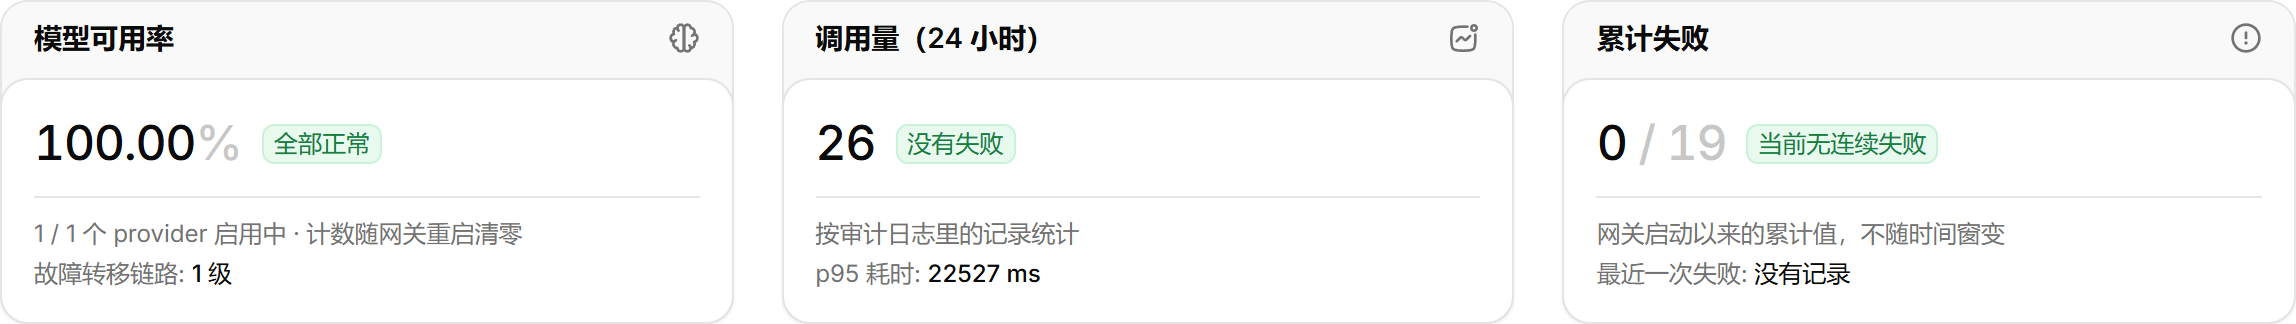
| 模型可用率 | 启用中的 provider 有几个正常,故障转移链路有几级。计数随网关重启清零 |
| 调用量(24 小时) | 按审计记录统计的调用次数、失败次数和 p95 耗时。审计未开启时无此项 |
| 累计失败 | 网关启动以来的累计失败、是否有 provider 正在连续失败、最近一次失败 |
故障转移链与调用活动 按顺序列出 provider、当前在用的一个、上次成功时间和连续失败次数,旁边是过去 24 小时的调用曲线。调用曲线只有管理员可见。