

字段字典
扫描一个索引,列出字段、类型、基数与样本值。写查询和规则前确认字段名。
字段字典读取索引的 mapping 和一批采样文档,列出集群中实际存在的字段和取值,与 ECS 规范是否定义无关。智能查询 和 检测规则 内部使用同一套扫描结果。所有版本都可以使用。
以下情况先查字段字典:
- 写检测意图前,确认字段是
event.action还是event.type,值是login_failure还是failed。 - 智能查询没有结果时,看样本值中写的是
ERROR还是error。 - 评估一个索引能否接入时,空字段过多或基数异常说明采集端的 mapping 有问题。
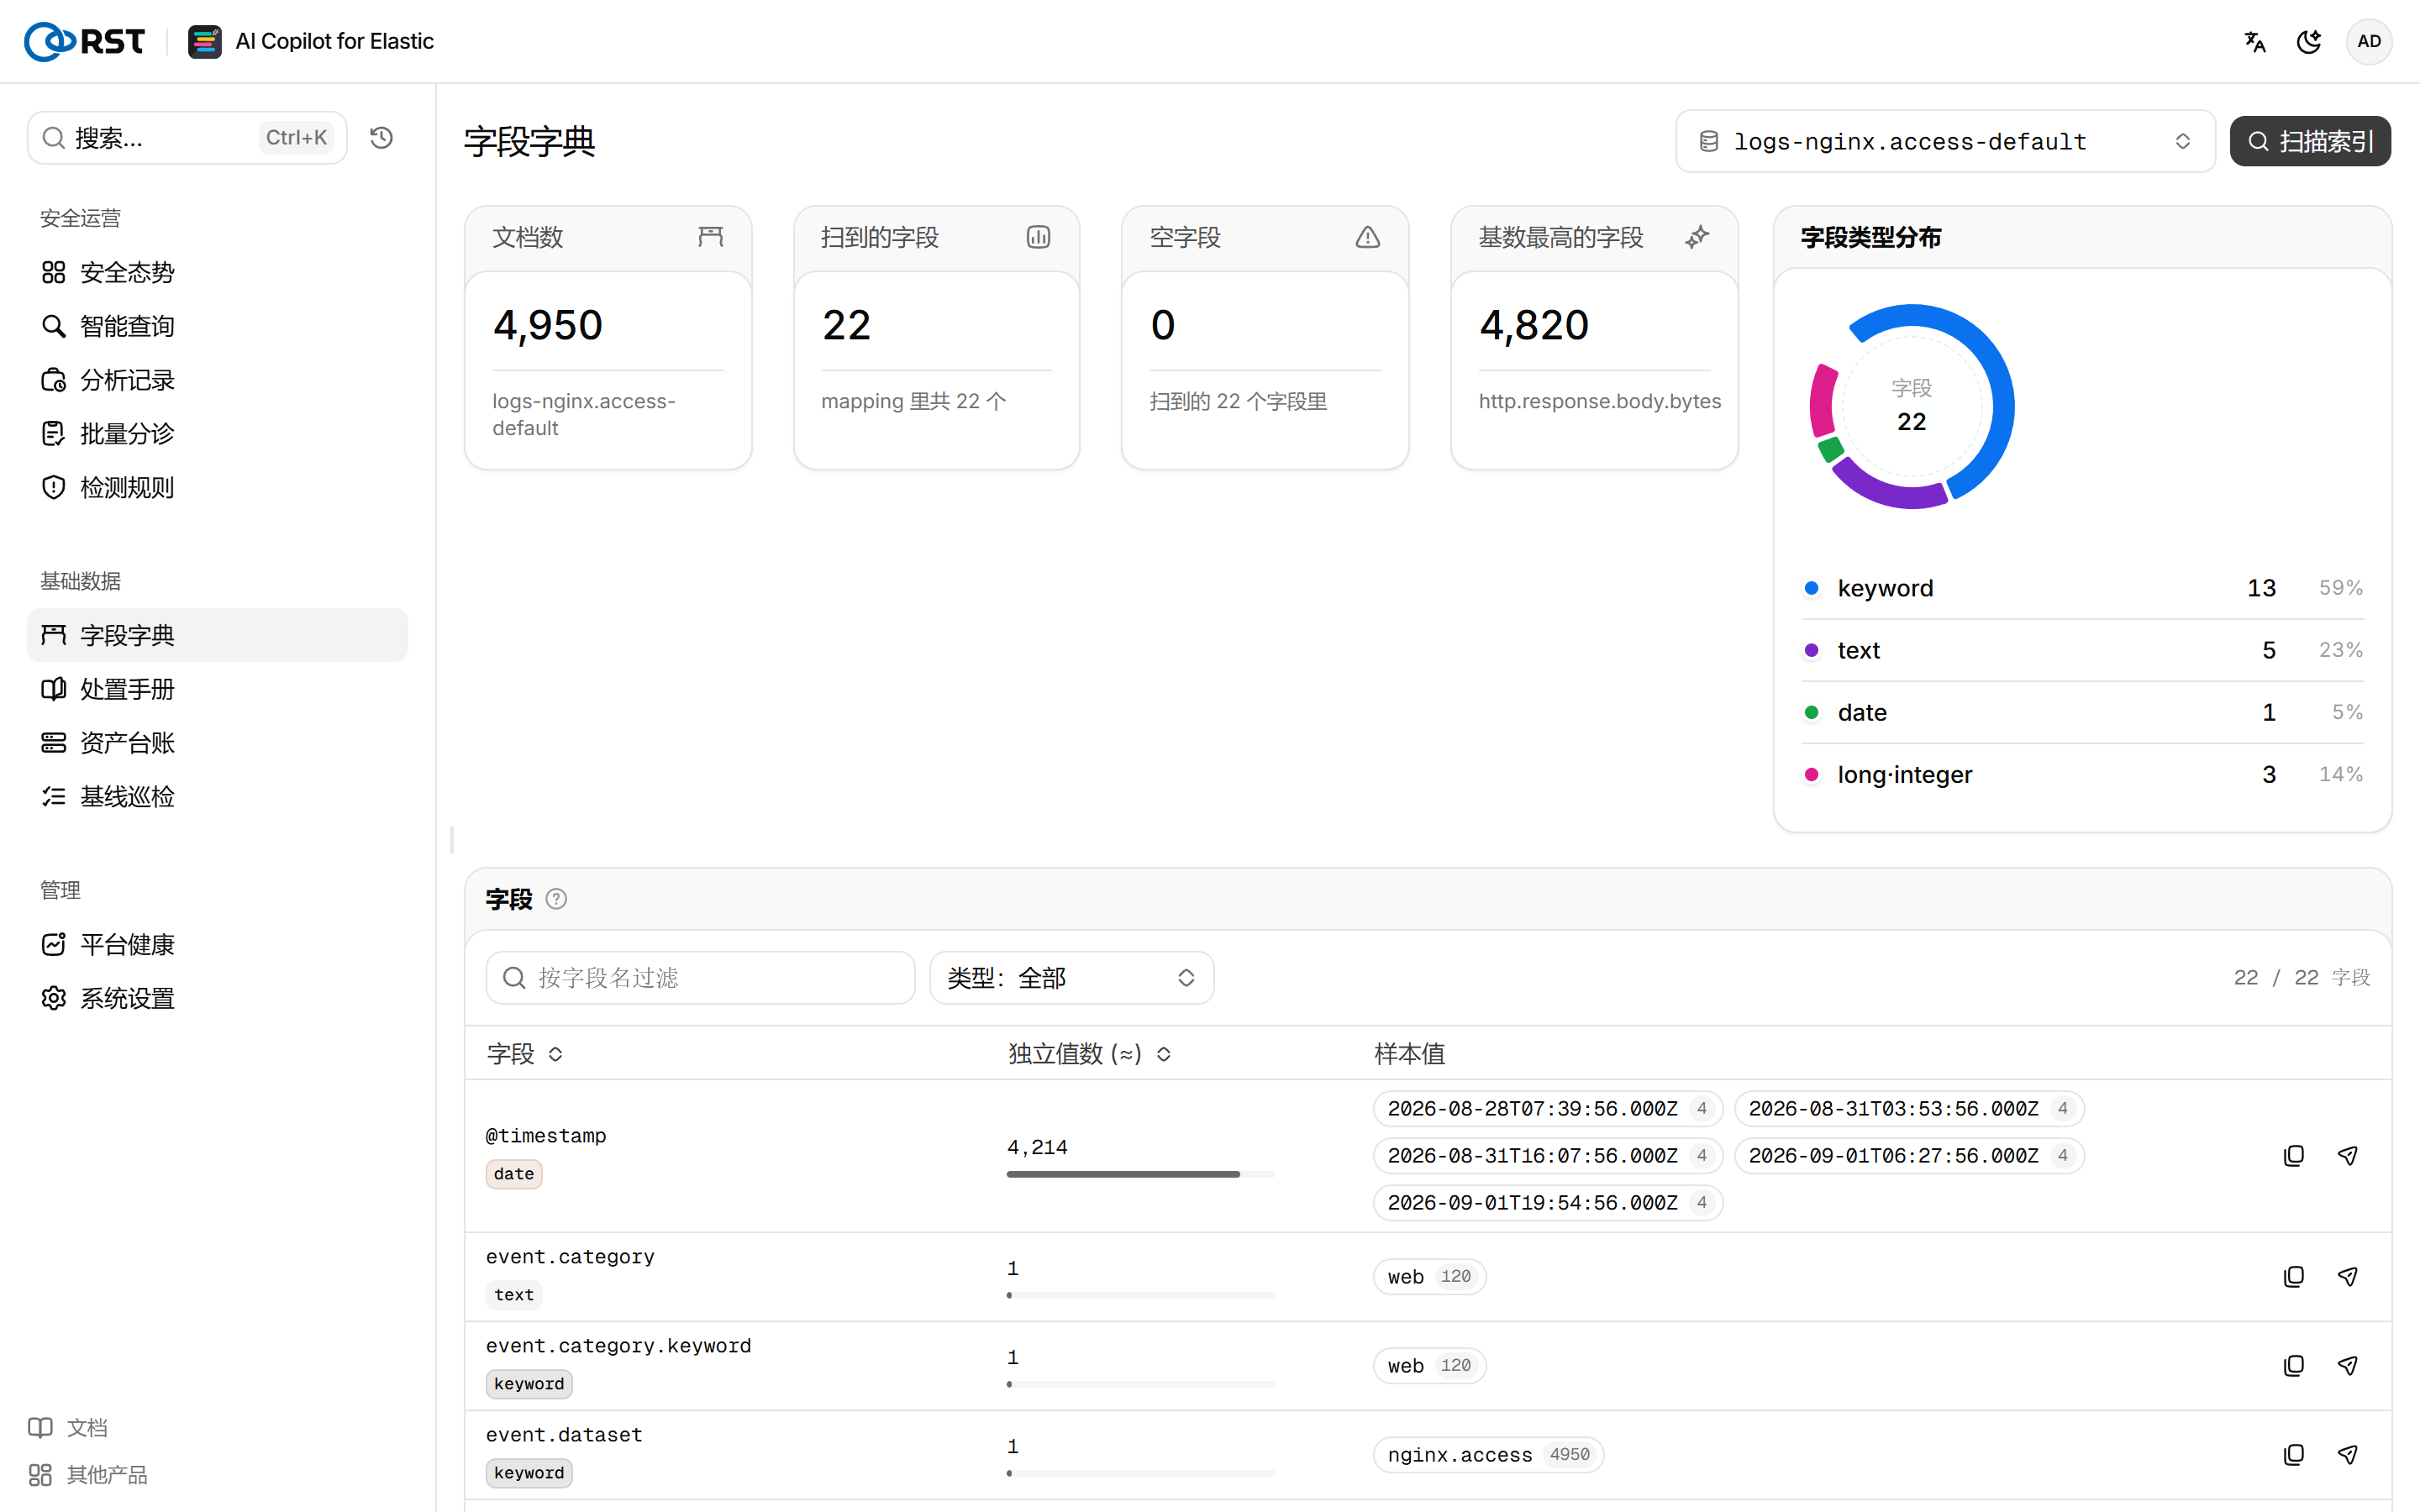
扫描索引
步骤
- 输入索引名,支持通配符,例如
logs-nginx.*。 - 选择 扫描索引。
扫描结果缓存 300 秒,由 RST_FIELD_DICT_CACHE_TTL_S 设置,0 表示不缓存。
扫描概览
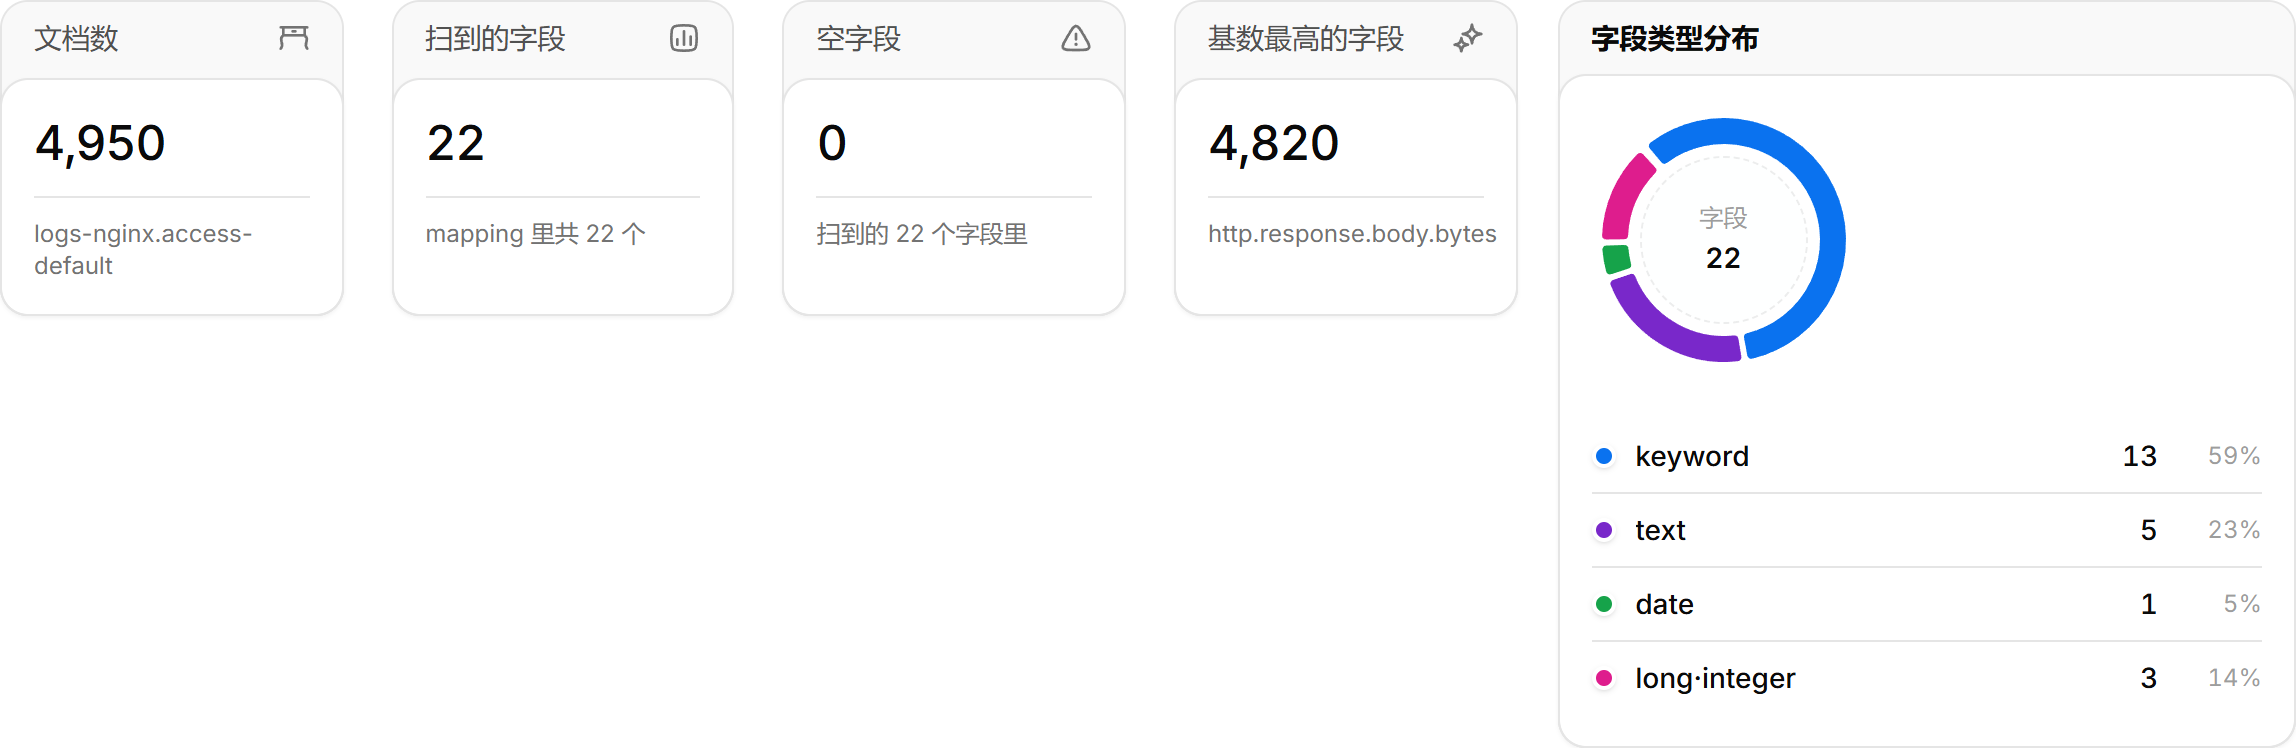
| 卡片 | 含义 |
|---|---|
| 文档数 | 匹配的索引数与文档数 |
| 扫到的字段 | 采样中出现的字段数,以及 mapping 声明的字段数。大索引只扫描前一批时标注 只扫了前一批 |
| 空字段 | mapping 中存在、采样中从未出现的字段。写规则时避开这些字段 |
| 基数最高的字段 | 独立值最多的字段,通常是 ID、时间戳或消息体 |
| 字段类型分布 | keyword、text、date、ip、long 等类型的占比 |
使用字段表
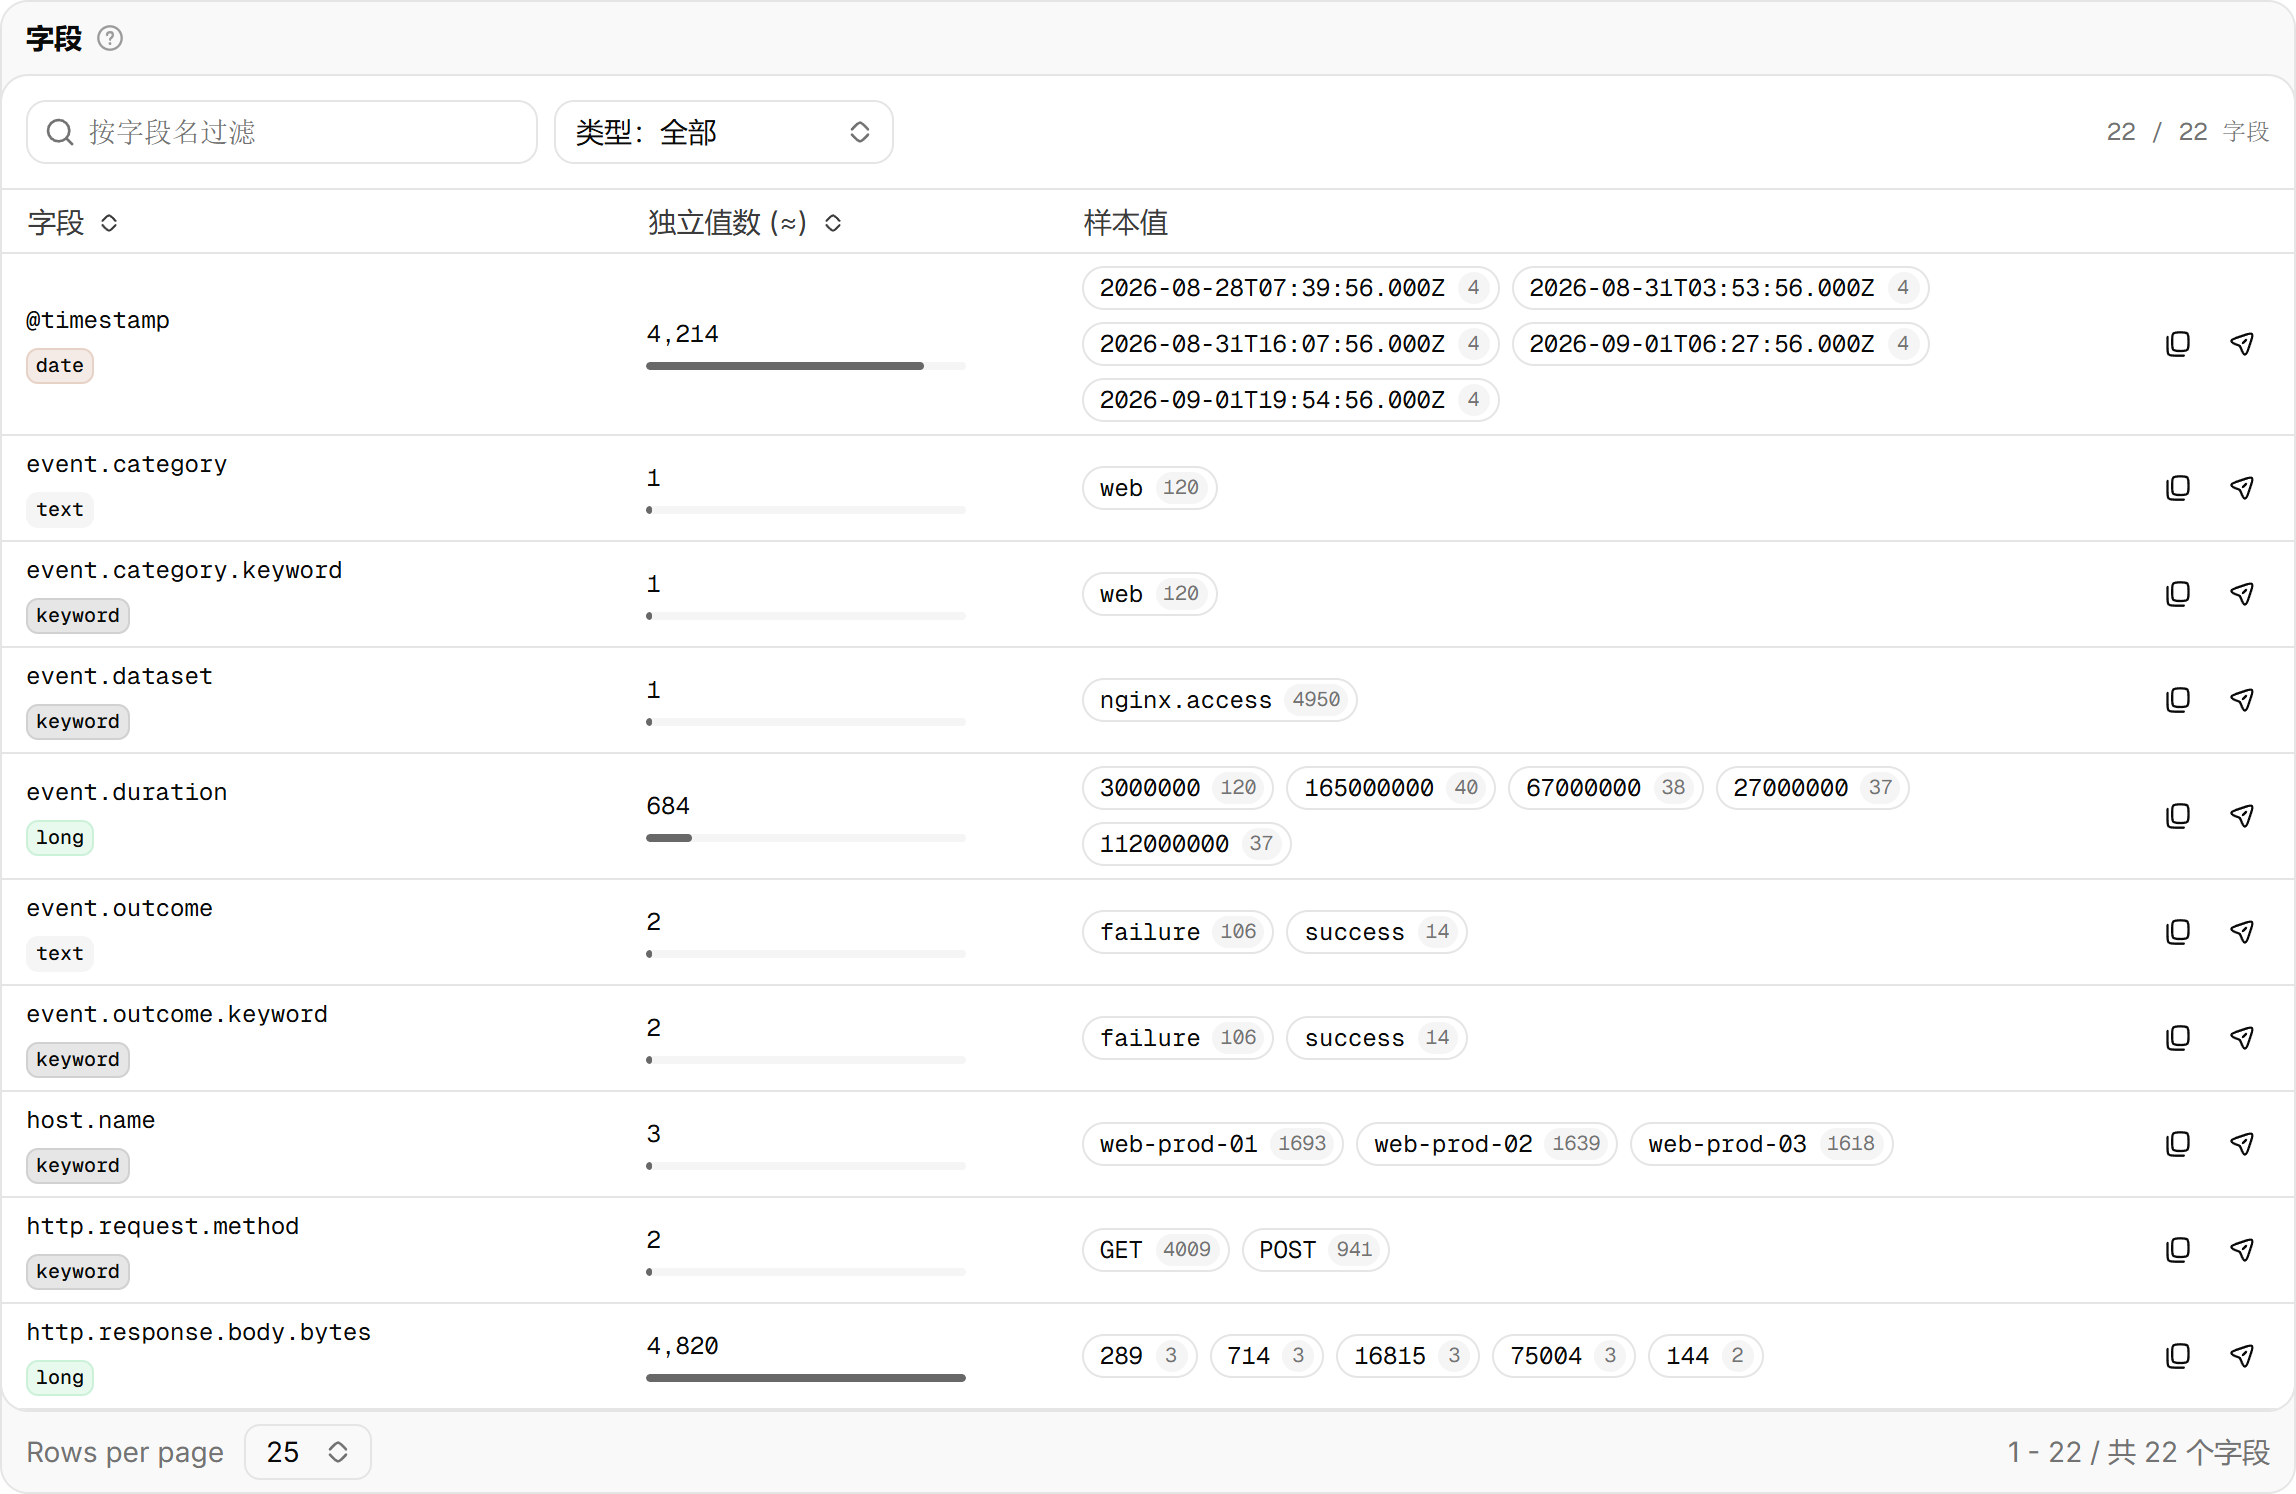
字段表每行一个字段,列出类型、估算的独立值数和样本值。样本值按出现次数倒序排列。
| 操作 | 结果 |
|---|---|
| 选择一个样本值 | 复制为 字段:"值",可以直接粘贴进查询或规则 |
| 插入到查询 | 把该字段带到智能查询 |
| 按字段聚合 | 生成「按 X 聚合,取 top 10」的统计问题,带到智能查询 |